
我敢打赌,每个数据团队的代码仓库里,都躺着那么一两段没人愿意碰的 “祖传 SQL”。一百多行,N 层嵌套 CTE,窗口函数套着窗口函数。写它的人早就离职了,注释约等于没有,没人敢改,也没人能完全读通。业务改个小口径,接盘的人要先花两小时捋清每层子查询的作用,改完再花一小时调试,生怕动了一行,塌了一整片逻辑。
周五下午四点,产品经理在群里 @了你:“线上那个‘每日累计去重商品数’的逻辑要确认一下,今天能上线吗?”
你打开那段 SQL,准确地说,是半年前前同事留下的那段 SQL。
先看这个业务场景:每天累计去重计数
需求本身听起来并不复杂。有一张表,记录了每个账号每天购买的商品名称: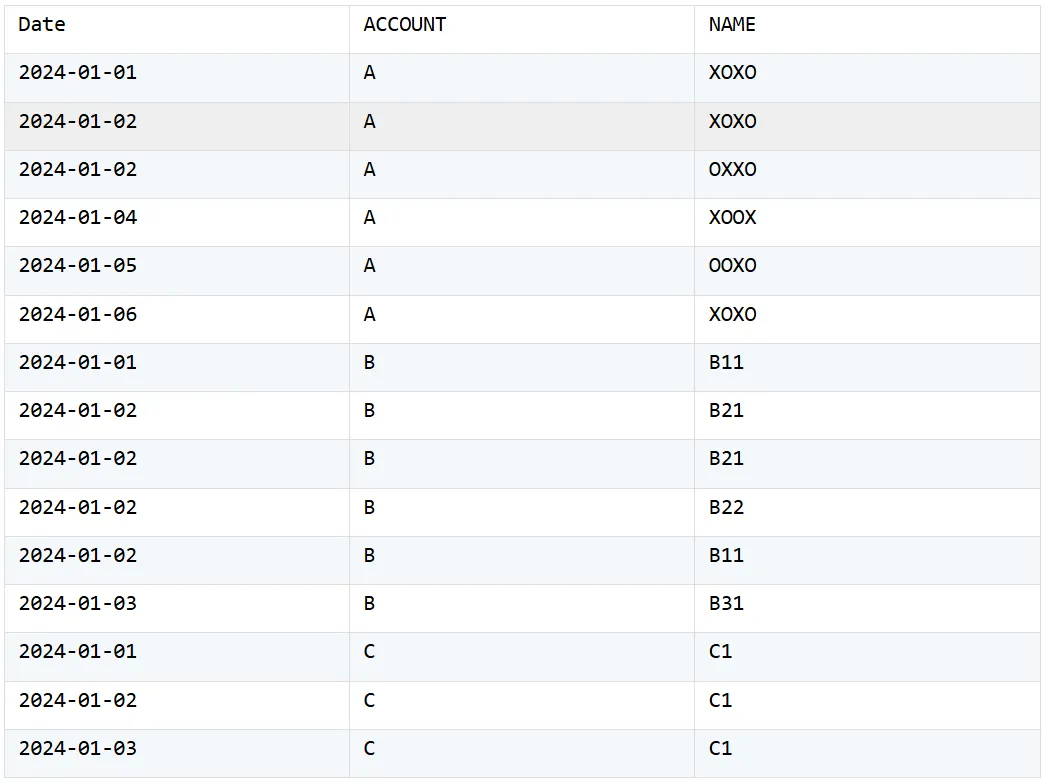
要计算的结果是:每个账号到每天之前(不含当天)曾经购买过多少种不同的商品。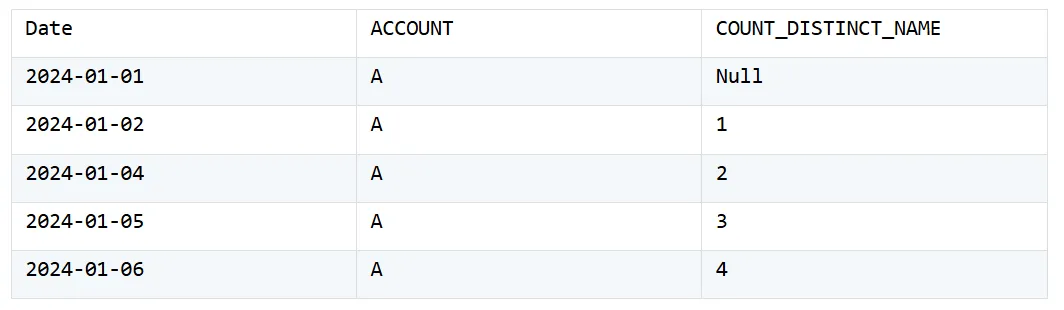
2024-01-01 是第一天,之前没有任何购买记录,所以是 Null。2024-01-02 时,A 账号在 1 月 1 日买过 XOXO 这一种商品,所以累计去重数是 1。到了 1 月 4 日,1 月 1 日和 1 月 2 日两天累计买过 XOXO 和 OXXO 两种,所以是 2。依此类推。
按账号分组、按日期排序,依次处理每一天的数据,取从第一天到前一天的区间,进行去重计数。按说逻辑很清晰,对吧?
生产环境里的 SQL 长这样
你打开那段 SQL,它长这样(已经删掉了注释,但保留了全部逻辑):
WITH
cte_base AS (
    SELECT account, dt, name,
        1 AS dummy_const, 'N/A' AS dummy_text
    FROM orders WHERE 1 = 1
),
cte_with_row_num AS (
    SELECT account, dt, name,
        ROW_NUMBER() OVER (PARTITION BY account ORDER BY dt) AS row_num
    FROM cte_base
),
cte_with_lag AS (
    SELECT account, dt, name, row_num,
        LAG(name) OVER (PARTITION BY account ORDER BY dt) AS lag_name,
        LAG(dt) OVER (PARTITION BY account ORDER BY dt) AS lag_dt
    FROM cte_with_row_num
),
cte_self_join_distinct AS (
    SELECT a.account, a.dt, a.name,
        COUNT(DISTINCT b.name) AS self_join_distinct_count
    FROM cte_with_row_num a
    LEFT JOIN cte_with_row_num b
        ON a.account = b.account AND b.row_num < a.row_num
    GROUP BY a.account, a.dt, a.name, a.row_num
),
cte_with_window AS (
    SELECT account, dt, name, row_num,
        COUNT(DISTINCT name) OVER (
            PARTITION BY account
            ORDER BY dt
            ROWS BETWEEN UNBOUNDED PRECEDING AND 1 PRECEDING
        ) AS window_distinct_count
    FROM cte_with_row_num
),
cte_combined AS (
    SELECT w.account, w.dt, w.name, w.window_distinct_count,
        s.self_join_distinct_count,
        CASE WHEN w.window_distinct_count = s.self_join_distinct_count
             THEN 'MATCH' ELSE 'MISMATCH' END AS match_flag
    FROM cte_with_window w
    LEFT JOIN cte_self_join_distinct s
        ON w.account = s.account AND w.dt = s.dt AND w.name = s.name
),
cte_with_flag AS (
    SELECT account, dt, name,
        window_distinct_count,
        EXTRACT(YEAR FROM dt) AS dt_year,
        EXTRACT(MONTH FROM dt) AS dt_month,
        EXTRACT(DAY FROM dt) AS dt_day,
        ROW_NUMBER() OVER (PARTITION BY account, dt ORDER BY name) AS rn_per_day
    FROM cte_combined
),
cte_daily_agg AS (
    SELECT account, dt,
        MAX(window_distinct_count) AS daily_distinct_count,
        COUNT(DISTINCT name) AS daily_unique_names,
        COUNT(*) AS daily_total_rows
    FROM cte_with_flag
    GROUP BY account, dt
),
cte_with_previous AS (
    SELECT account, dt, daily_distinct_count,
        LAG(daily_distinct_count) OVER (PARTITION BY account ORDER BY dt) AS prev_day_count,
        LAG(dt) OVER (PARTITION BY account ORDER BY dt) AS prev_dt,
        (SELECT COUNT(DISTINCT dt) FROM cte_daily_agg b WHERE b.account = a.account) AS total_days
    FROM cte_daily_agg a
),
cte_final AS (
    SELECT account, dt,
        CASE WHEN daily_distinct_count = 0 THEN NULL ELSE daily_distinct_count END AS count_distinct_name,
        prev_day_count AS dummy_prev
    FROM cte_with_previous
    WHERE 1 = 1
    UNION ALL
    SELECT NULL, NULL, NULL, NULL WHERE 1 = 0
)
SELECT DISTINCT account, dt, count_distinct_name
FROM cte_final
WHERE account IS NOT NULL
ORDER BY account, dt;
你盯着屏幕看了三十分钟。
这段 CTE 在干嘛?那个 cte_self_join_distinct 为什么要用自连接做去重计数?既然已经用了窗口函数,为什么还要把两个结果拼在一起对比 MATCH/MISMATCH?那些 EXTRACT(YEAR FROM dt) 的字段在最外层一个都没用到,为什么还留着?最后那个 UNION ALL 空集和 SELECT DISTINCT 又是怎么回事?
理论上,用窗口函数应该不用写的这么复杂,但生产环境里就是长成了这样。可能因为需求一步步叠加,一个人改了加一段,另一个人接手后不敢删旧的,只能在上面继续堆;也可能是某次紧急修复时加了个临时补丁,后来没人记得清理。代码像年轮一样层层累积,膨胀到了接近 100 行。
代码能跑。但没人敢动。
100 行 SQL 的问题不在“长”,在“没法动”
这段 SQL 的问题不是“长,长代码可以忍受。真正的问题是:改动它的风险,比重写还高。
为什么?
第一,你不知道哪些代码是“活”的。
那段 cte_self_join_distinct,明明 cte_with_window 已经用窗口函数算出了同样的去重计数,为什么还要保留一个自连接去重?是有什么边界情况窗口函数处理不了?还是写的人忘了删?那些 EXTRACT(YEAR FROM dt)、EXTRACT(MONTH FROM dt)、EXTRACT(DAY FROM dt) 的字段,以及 ROW_NUMBER()OVER (PARTITION BY account, dt ORDER BY name) AS rn_per_day,最外层一个都没用到,为什么还留着?你不知道。
第二,你不知道改了会断什么。
最外层的 cte_final 包含一个 UNION ALL 空集,然后又被 SELECT DISTINCT 包了一层。你想删掉这些显然没用的东,但万一它们存在的目的是为了让某个下游依赖保持字段类型呢?万一某一天某个定时任务正好依赖了这个 UNION ALL 的字段数量呢?你不知道,也不敢试。
第三,你没有办法“小步试错”。
SQL 是声明式的,你不能在中间打个断点看看 cte_self_join_distinct 算出来到底是什么,也没法在 cte_with_window 执行完后暂停观察结果。你只能把整段 SQL 跑完,然后祈祷结果是对的。如果 cte_daily_agg 里某个边界条件写错了,直到最外层 SELECT DISTINCT 才会暴露问题,而那时候你根本不知道是哪一层出了问题。
第四,AI 也没解决这个问题。
即便你让 AI 重写这段 SQL,你也得先完整地告诉 AI 这段 SQL 到底在做什么,而你刚刚花了两个小时还没完全搞明白。改完了一跑,结果不对,你甚至不知道是 AI 理解错了还是你自己描述错了。最后你只能回到原点:这段代码既然能跑,不如就别动了。
换一种写法:把 100 行变成 7 步
SQLazy 的做法是:让分组能保持分组子集,让每一步操作都保留中间结果供下一步使用。
按账号分组,再按日期分组,依次处理每组数据,取从开始到上一日的所有记录,去重计数。用 SQLazy 的 workflow 写: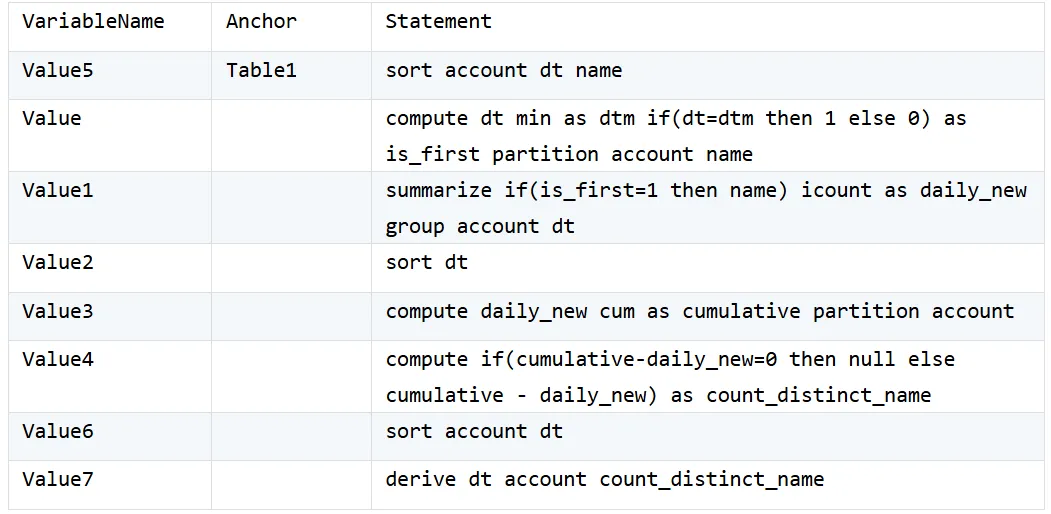
不是“少写几行代码”,而是“换了一种思考方式”。
第 1 步:按账号、日期、商品名排序——把数据理顺。
第 2 步:对每个账号的每种商品,标记它第一次出现的日期。is_first=1 表示这一天是该商品首次被该账号购买。
第 3 步:按账号和日期汇总,统计每天有多少种商品是“第一次出现”——也就是当日新增的去重商品数。
第 4 步:按日期排序——为累计做准备。
第 5 步:对每个账号,计算 daily_new 的累计值——也就是截至当天累计购买过的不同商品总数。
第 6 步:计算最终结果——cumulative - daily_new 就是“截至前一天累计购买过的不同商品总数”。如果结果为 0,则置为 Null。
第 7 步:整理输出,只保留需要的字段。
每一步都可以预览中间结果。第 3 步执行完,你立刻能看到每天新增了多少种商品;第 5 步执行完,累计值对不对当场就知道。不需要跑到最外层才看到结果出错。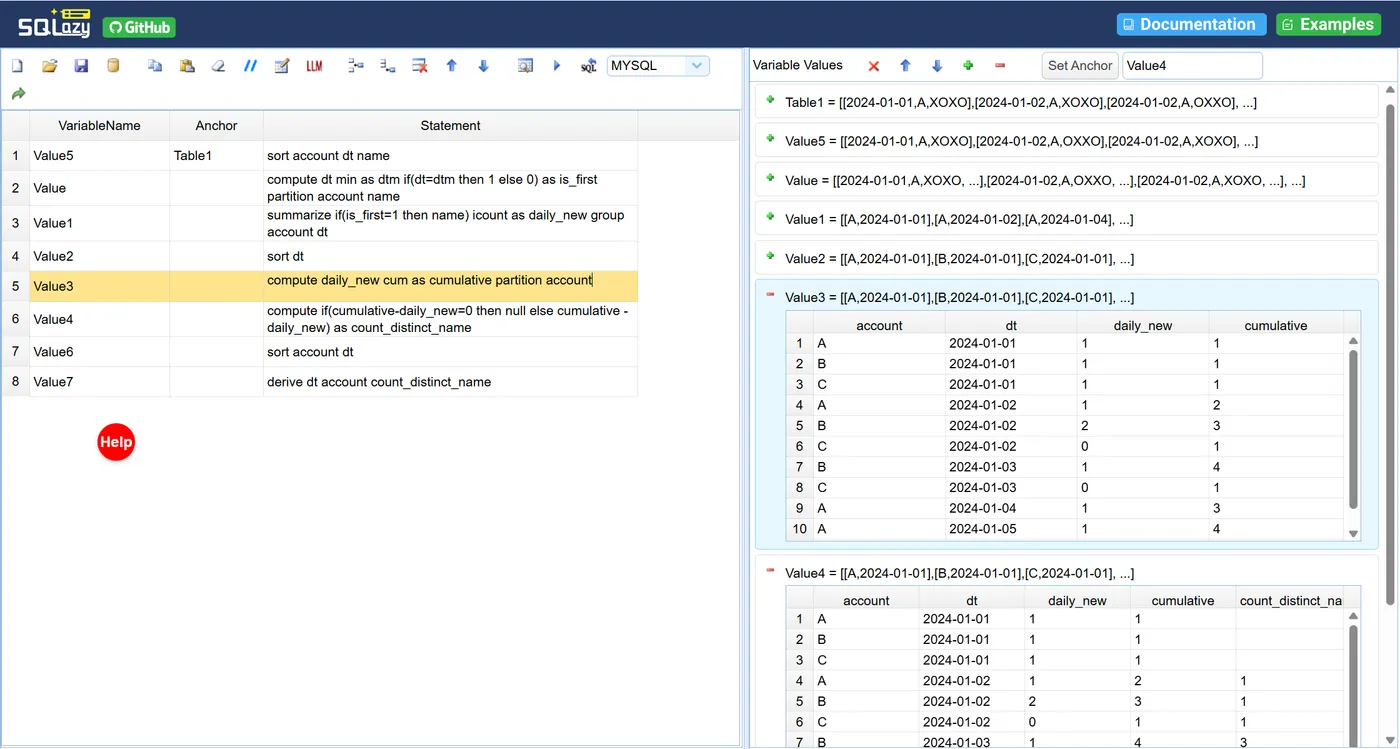
编译器保证:SQL 自动生成 100% 准确
编写 workflow 后,通过编译器生成目标数据库 SQL。
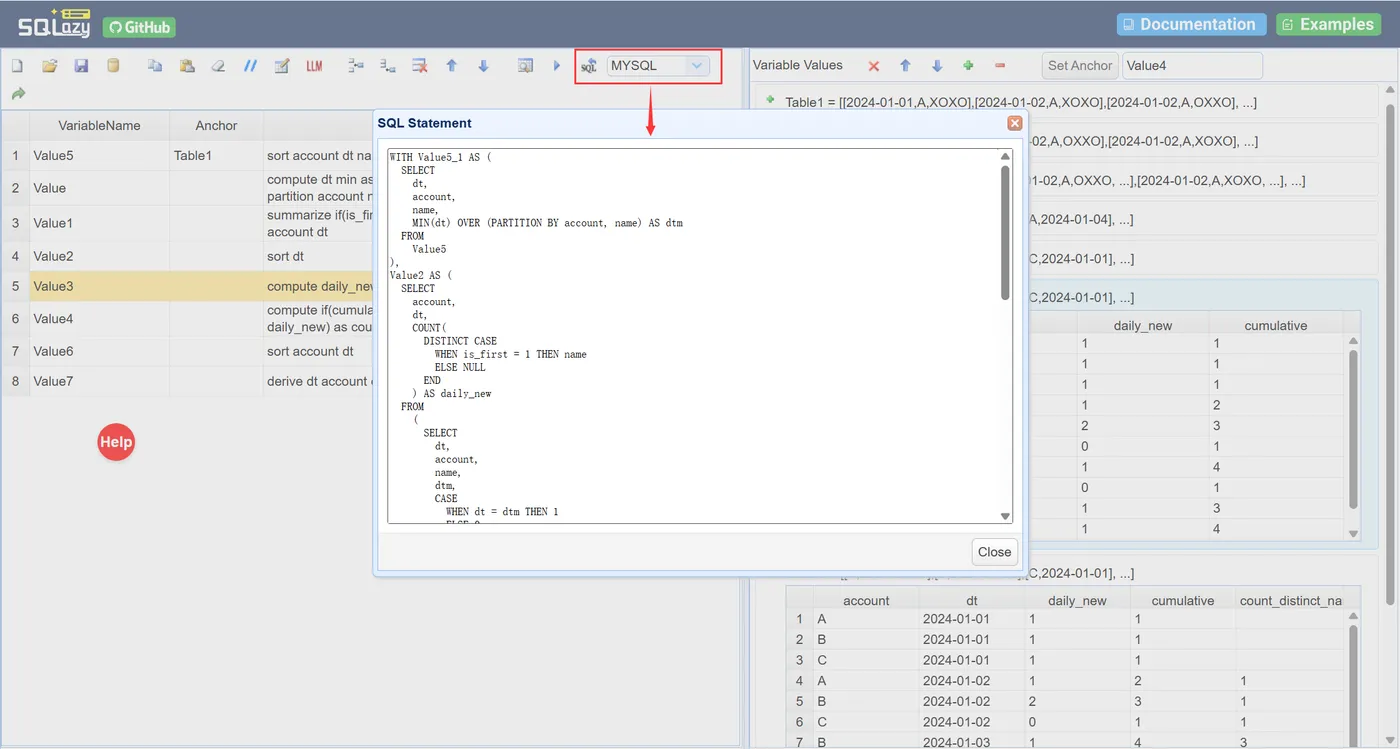
半年后需求变了:“不仅要算累计去重数,还要区分‘老商品’和‘新商品’,每天新增的商品里,有多少是以前从未出现过的,有多少是以前出现过的。”
在原来那 100 行 SQL 里,你无从下手。因为你根本不知道哪一层 CTE 在区分“首次出现”和“重复出现”,那些 is_first 标记可能被埋在某层的 CASE WHEN 里,也可能根本没有这个维度。你要么从头重写,要么在某个 CTE 里硬塞一个额外的聚合逻辑,然后祈祷不影响后面的累计计算。
在 SQLazy 的 workflow 里,改两步(核心只有一步):
原来的第 3 步:summarize if(is_first=1 then name) icount as daily_new group account dt——统计每天首次出现的商品数。
原来的第 7 步:derive dt account count_distinct_name ——整理输出结果。
现在要区分“新”和“旧”,只需要在第 3 步里加一个计数维度:
第 3 步:summarize if(is_first=1 then name) icount as daily_new,if(is_first=0 then name) icount as daily_repeat; group account dt
然后在第 7 步输出需要的字段:derive dt account,daily_new,daily_repeat, count_distinct_name
主要就改了一行,在 summarize 里加了一个 daily_repeat。编译器重新生成 SQL,新的字段自动出现在结果中。workflow 的其他步骤完全不用动,因为 daily_new 和 daily_repeat 都是按同一维度分组的,后续的累计逻辑天然兼容。
只改一行,不需要理解 100 行 SQL 的每一层 CTE 在干什么,不需要担心改了 A 影响 B。
编译器重新生成 SQL,100% 准确,没有幻觉。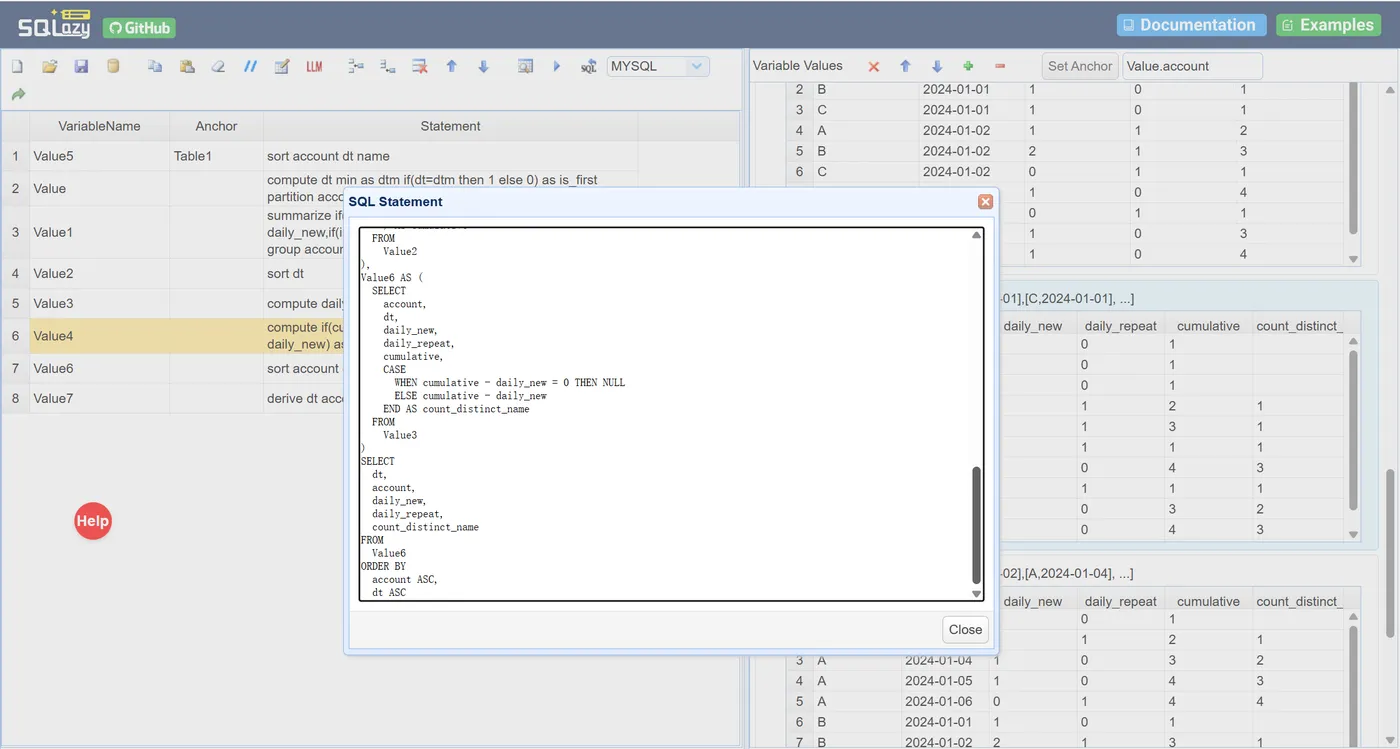
如果目标数据库从 MySQL 换成 PostgreSQL,切换一个选项,workflow 不用改,SQL自动适配方言。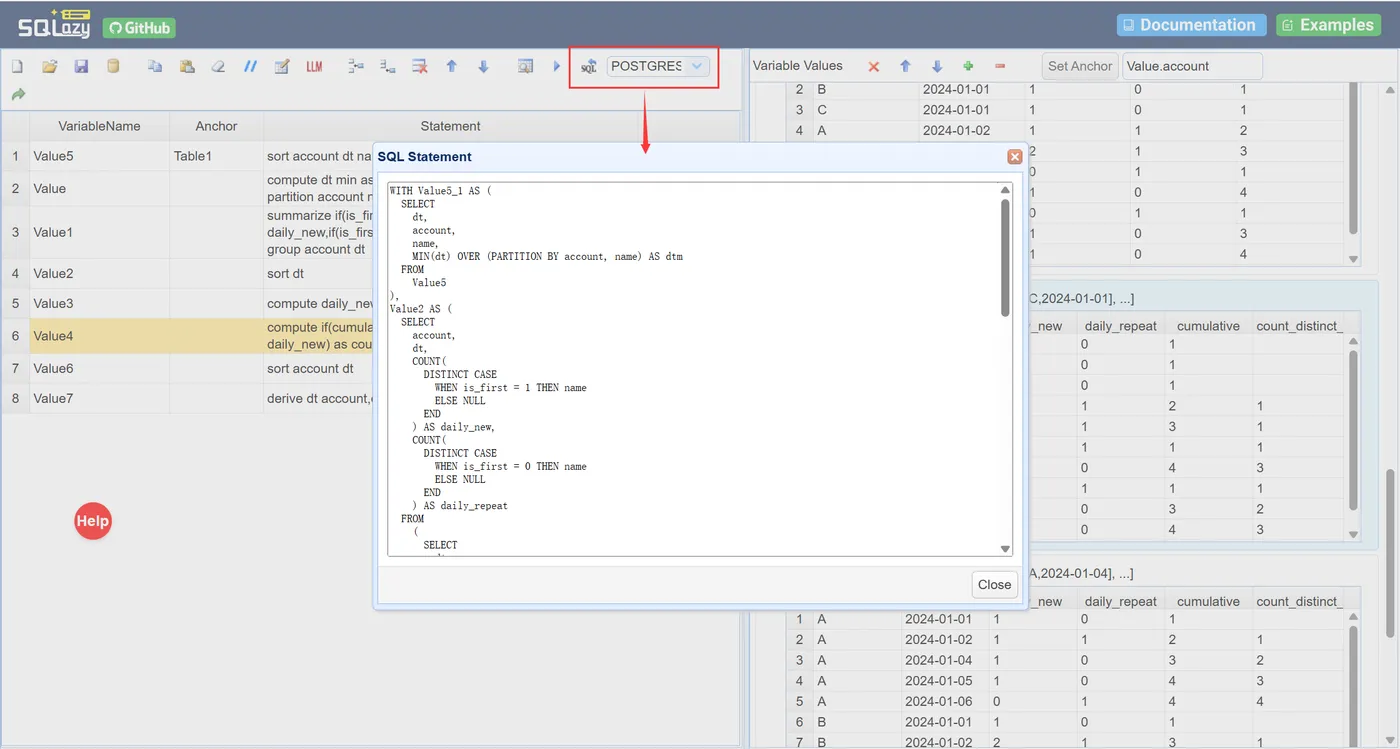
LLM 辅助规范
在 SQLazy 的 workflow 中,AI 的角色也被重新定义了。以往做法中,AI 负责从自然语言直接生成最终 SQL,高难度、高幻觉率。而在 SQLazy 中,AI 只做一件事:把用户口语化的步骤描述转译成规范的 workflow 语法。前者是“决策”,后者是“翻译”。即便 AI 转译有偏差,你在 workflow 层面一眼就能发现,纠正成本几乎为零。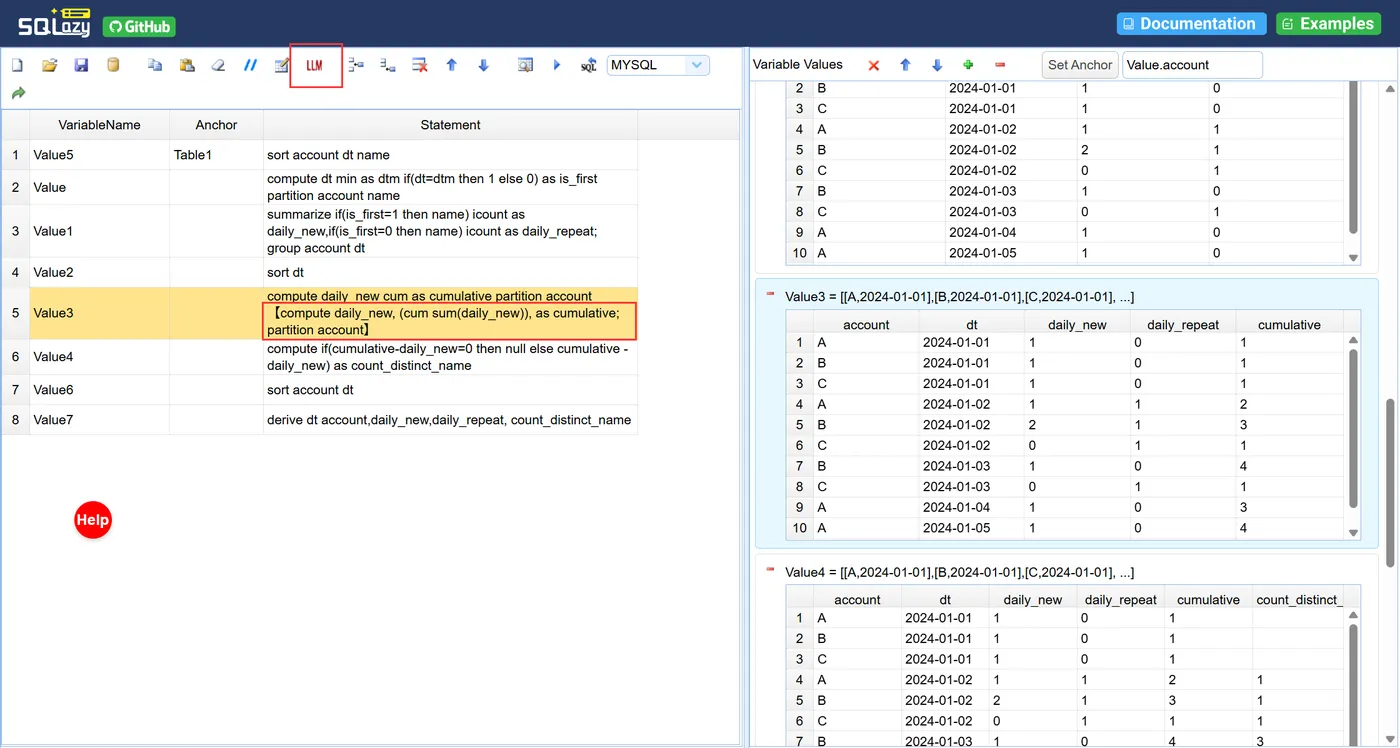
借助 LLM 把自然语言转成 SQLazy 语法
那 100 行 SQL 是前同事留下的。但说实话,三个月后你自己回头看自己写的 100 行 SQL,也未必能轻松看懂。这不是代码规范的问题。这是 SQL 这种语言本身的问题,它更适合机器执行,不适合人类阅读。
SQLazy 做的事情很简单:让你写给人看的那份逻辑,同时也是能编译成 SQL 的那份代码。代码即文档,两者是同一个东西。
与 AI 结合使用,可以发现 SQLazy 的核心逻辑:
AI writes the logic. A compiler writes the SQL.


