本文适合谁看:用过 AI 编程助手(Cursor、Copilot、Trae 等)写过项目的开发者。如果你还在"让 AI 先全做出来再挑"的阶段,这篇能帮你少走弯路。
背景:本文方法论源于「超兔一体云」SaaS 产品的业务诊断模块建设实践。该项目面向工业制造行业,需要把 13 个业务中心、数百篇产品文档结构化为可交互的诊断流程,过程中踩过的坑与沉淀的经验,正是这套"减法+知识杠杆"工作流。
TL;DR
- Vibe Coding(VC)时代,代码越少、层级越浅,项目越健康——因为生成成本极低,但纠错成本随代码量非线性增长
- 两个核心方法:大刀阔斧用减法(决定做什么)+ 放大 VC 处理海量知识的能力(决定怎么做)
- 真实案例:超兔一体云业务诊断页项目,4 层 22 项砍到 2 层 10 项,文档匹配从 3 周压缩到半天,Bug 反而更少了
一、开局:一个让我脸红的 Bug
最近给超兔一体云做业务诊断互动页——用户勾选企业问题,系统匹配对应的产品能力解法。这是整个 SaaS 产品的入口体验模块,直接影响客户的首次认知与转化。
照搬咨询方法论,设计了 4 层倒推:
L1 症状(8项)→ L2 原因(8项)→ L3 卡点(6项)→ L4 解法
22 个问题,逻辑严密,听起来很专业。
第一次交付,直接炸了:
- L4 某个选项少了
p字段,JS 一崩到底,C1 之后所有中心全部空白 - 用户反馈:"问题太多了,不想答完"
- 复盘发现 L1/L2/L3 近 10 个选项在说同一件事的不同侧面
最后做了两件事:
- 三层合并为一层,22 项砍到 10 项
- 让 VC 自动浏览语雀文档库,半天完成 200+ 个文档链接匹配(人工要 2-3 周)
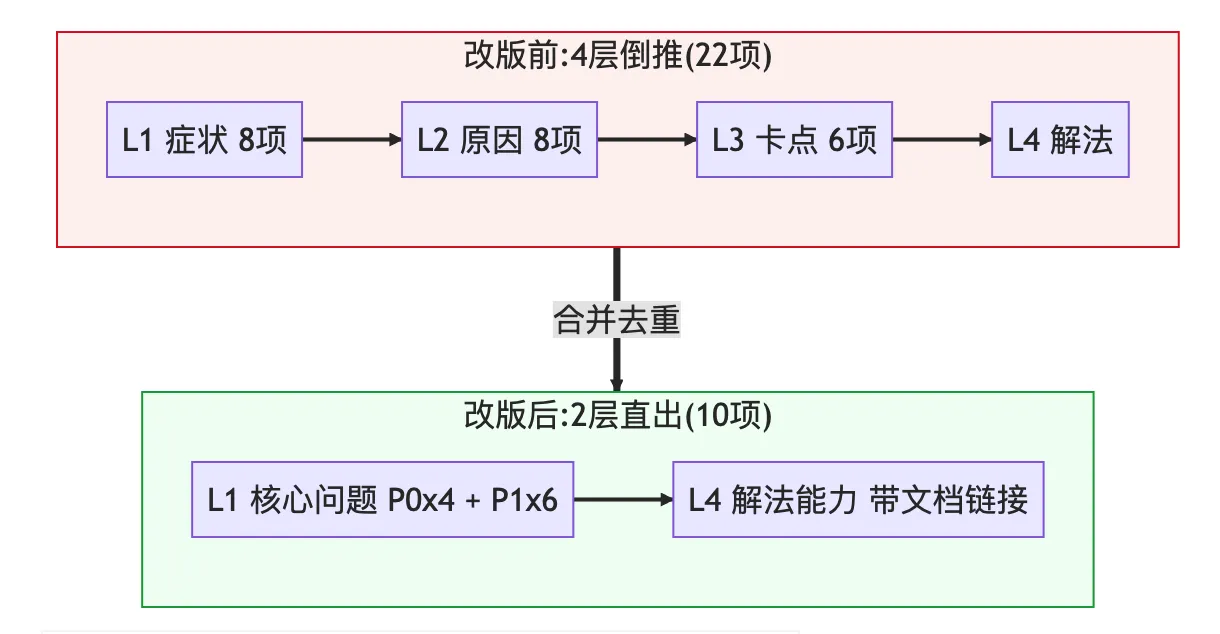
flowchart TB
    subgraph 改版前["改版前:4层倒推(22项)"]
        L1["L1 症状 8项"] --> L2["L2 原因 8项"] --> L3["L3 卡点 6项"] --> L4["L4 解法"]
    end
    subgraph 改版后["改版后:2层直出(10项)"]
        N1["L1 核心问题 P0x4 + P1x6"] --> N2["L4 解法能力 带文档链接"]
    end
    改版前 ==合并去重==> 改版后

    style 改版前 fill:#fef2f2,stroke:#dc2626
    style 改版后 fill:#f0fdf4,stroke:#16a34a
| 指标 | 改版前 | 改版后 |
|---|---|---|
| 问题选项 | 22项(跨3层) | 10项(1层直出) |
| 崩溃风险 | 高(字段遗漏x3层) | 低(单层结构) |
| 用户路径 | 4步 | 2步 |
| 文档链接 | 无(人工整理需3周) | 200个链接(半天完成) |
这个案例揭示了两个反直觉的真相:
- "少"不是妥协,"少"本身就是质量保障
- VC 真正的杠杆不在"写代码快",在它能接管最耗时的知识处理环节
二、VC 不是 Copilot 升级版
先对齐一下概念。Vibe Coding(VC)不是"AI 自动补全代码"的升级版,而是开发工作流的根本性重构——你用自然语言描述意图,AI 负责方案生成、代码编写、浏览器验证、数据提取,你负责判断和取舍。
| 维度 | 传统开发 | Vibe Coding |
|---|---|---|
| 交互方式 | 逐行编码 | 自然语言对话 |
| 生成成本 | 高 | 极低(30秒出结果) |
| 纠错成本 | 线性增长 | 非线性(代码越多越难定位) |
| 瓶颈环节 | 编码速度 | 人的判断力 |
| 信息收集 | 人工逐页整理 | AI 自动浏览提取 |
核心矛盾:生成成本极低,但纠错成本随代码量非线性增长。所以——
在 VC 中,代码越少、层级越浅,项目越健康。
这也意味着,开发者的核心价值转移了:从"写代码"变成了"判断该写什么"。本文的两个方法就围绕这个展开。
三、方法一:大刀阔斧做减法
核心论点
AI 天然倾向于生成更多内容——你要 10 个选项,它给你 20 个,每个看起来都合理。但 AI 不会告诉你"其实 6 个就够了"。
大刀阔斧砍掉冗余,是人类开发者在 VC 中最不可替代的价值。
减法三板斧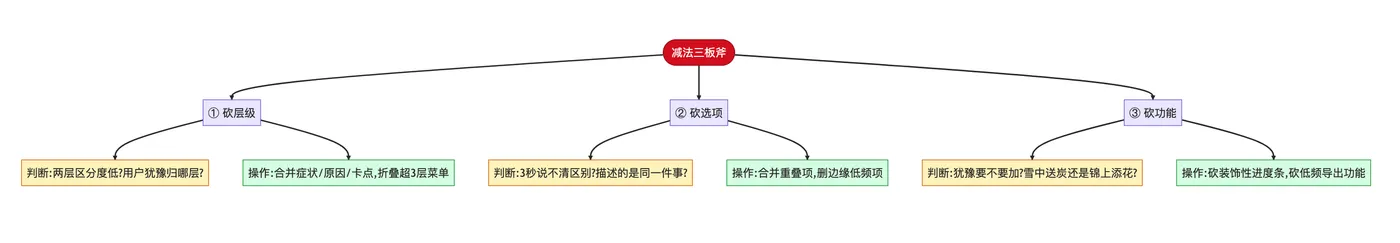
flowchart TB
    ROOT(["减法三板斧"])
    ROOT --> A["① 砍层级"]
    ROOT --> B["② 砍选项"]
    ROOT --> C["③ 砍功能"]

    A --> A1["判断:两层区分度低?用户犹豫归哪层?"]
    A --> A2["操作:合并症状/原因/卡点,折叠超3层菜单"]

    B --> B1["判断:3秒说不清区别?描述的是同一件事?"]
    B --> B2["操作:合并重叠项,删边缘低频项"]

    C --> C1["判断:犹豫要不要加?雪中送炭还是锦上添花?"]
    C --> C2["操作:砍装饰性进度条,砍低频导出功能"]

    style ROOT fill:#dc2626,stroke:#991b1b,color:#fff
    style A1 fill:#fef3c7,stroke:#d97706
    style B1 fill:#fef3c7,stroke:#d97706
    style C1 fill:#fef3c7,stroke:#d97706
    style A2 fill:#dcfce7,stroke:#16a34a
    style B2 fill:#dcfce7,stroke:#16a34a
    style C2 fill:#dcfce7,stroke:#16a34a
优先级:砍层级 > 砍选项 > 砍功能。层级减少同时降低开发复杂度、出错概率和用户流失率,收益最大。
真实砍掉的内容
抽象原则不够说服力,看看实际砍了什么:
| 原内容 | 砍后 | 理由 |
|---|---|---|
| L1/L2/L3 三层 22 项 | 单层 10 项 | 3秒说不清区别就合并 |
| 4项关于"过程黑盒" | 合并为1项 | 描述同一件事 |
| 6项"现状良好" | 全删 | 现状良好无需"对症" |
| 业务画像收集 6 题 | 整模块删 | 用户大概率跳过 |
| 诊断书 PDF 导出 | 整功能删 | 一次都没用 |
| 装饰性进度条 | 删 | 增加视觉噪音 |
| 多角色切换视图 | 删 | 复杂度高、使用率极低 |
为什么"砍层级"排第一
追求完备在 VC 中会触发连锁负向循环: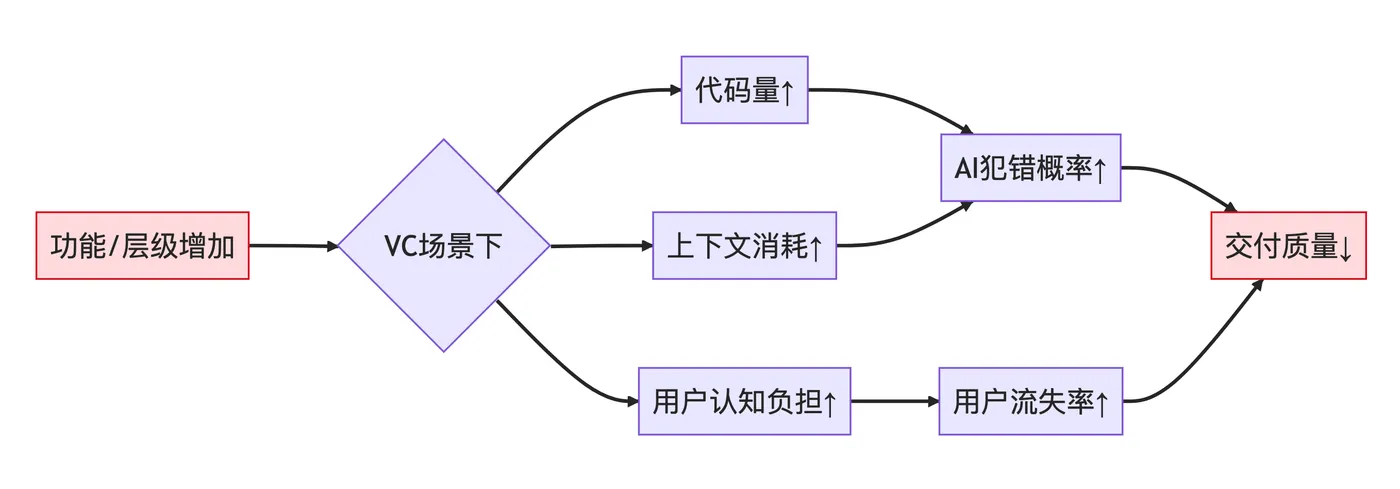
graph LR
    A["功能/层级增加"] --> B{"VC场景下"}
    B --> C["代码量↑"]
    B --> D["上下文消耗↑"]
    B --> E["用户认知负担↑"]
    C --> F["AI犯错概率↑"]
    D --> F
    E --> G["用户流失率↑"]
    F --> H["交付质量↓"]
    G --> H

    style A fill:#fee2e2,stroke:#dc2626
    style H fill:#fee2e2,stroke:#dc2626
三个连锁效应:
- 对用户:网页产品用户给你 30 秒到 2 分钟,层级深度与流失率呈指数关系
- 对 AI:超兔一体云诊断页项目 80% 的 Bug 出现在"为完备而加"的边缘功能上。精简代码本身就是提升稳定性
- 对人:AI 能生成内容但不会取舍。识别冗余、抓住核心——这是 VC 中最有价值的人的工作
砍层级同时触发三条正向效应,其他两个板斧只触发部分。
四、方法二:把 VC 当知识处理引擎
核心论点
VC 最大的杠杆不是"写代码快",而是它能将"获取信息 → 理解语义 → 整合数据 → 生成产物"这条传统上人力密集的链路,压缩到对话级别完成。
以前花几周做的知识整理,VC 几小时搞定。关键是把 VC 当知识处理引擎,不是代码生成器。
实战对比:3 周 → 半天
诊断页项目中最耗时的不是写页面,而是为每个解法匹配产品说明书链接。超兔一体云语雀文档库涵盖 13 个业务中心(客户、销售、订单、采购、生产、库存、财务、回款等)、数百篇文档。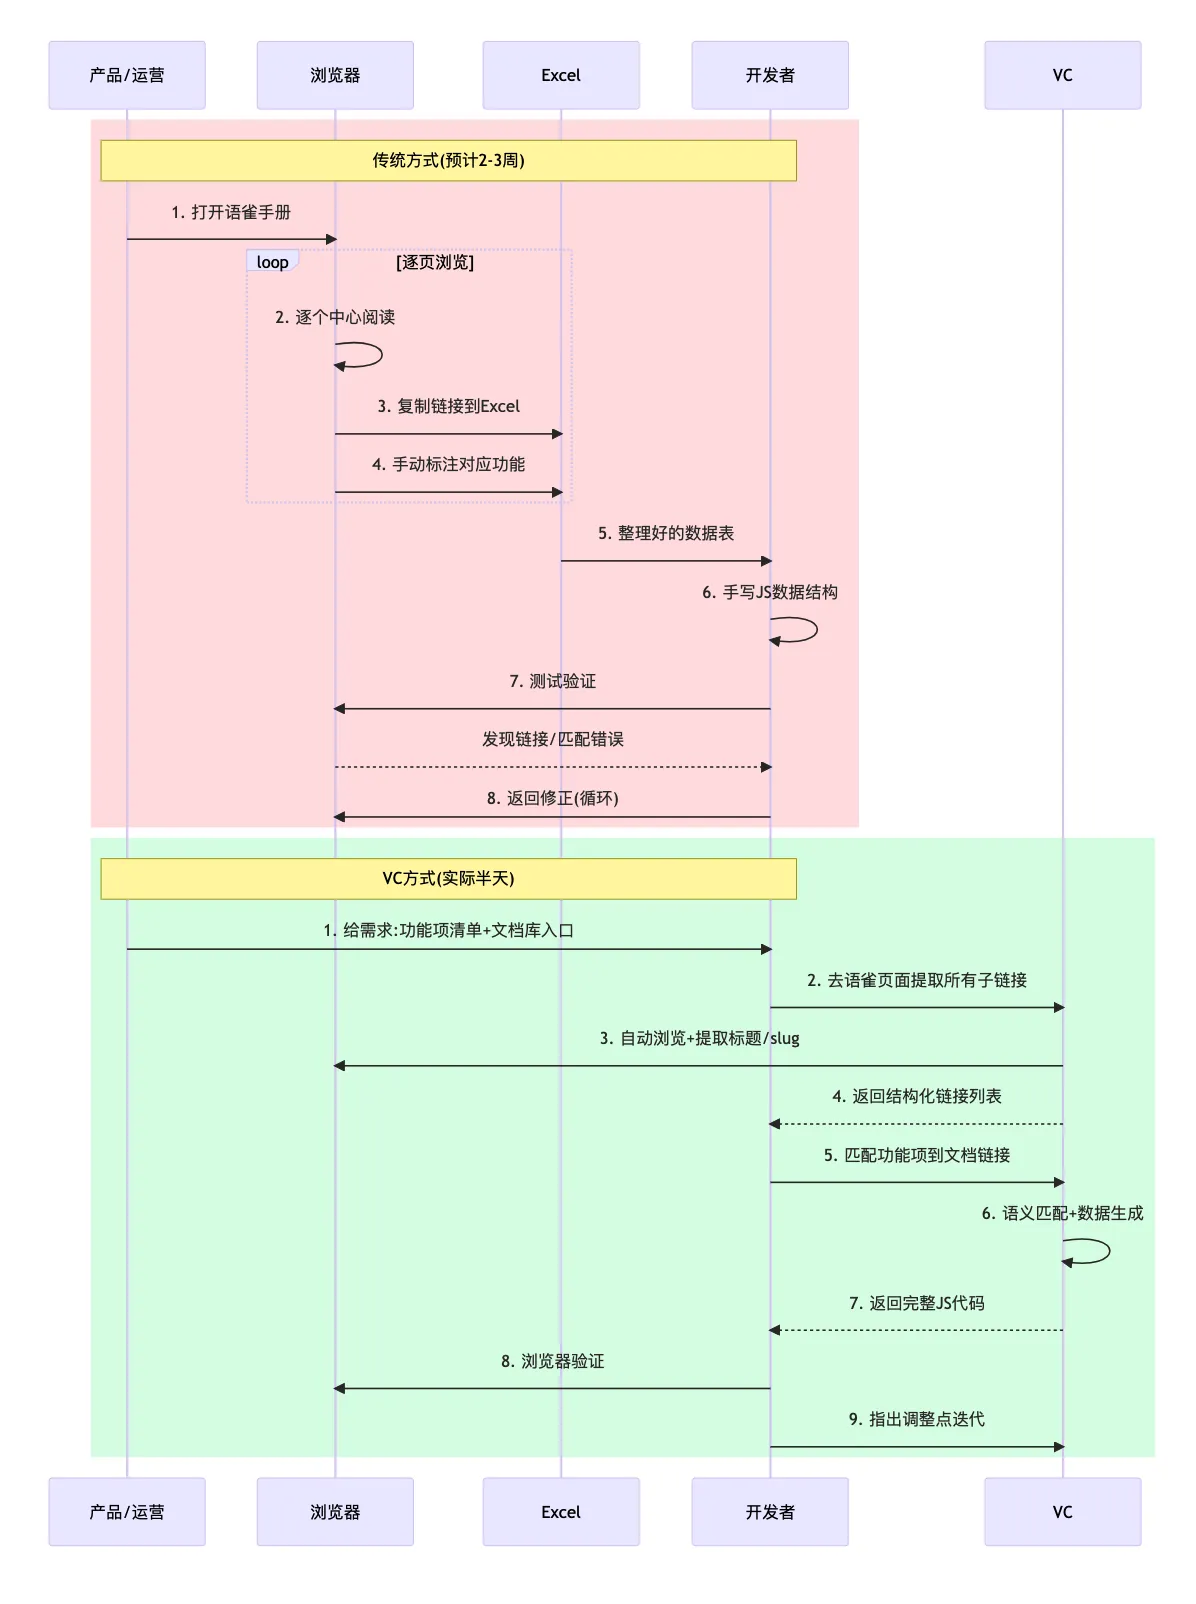
sequenceDiagram
    participant P as 产品/运营
    participant B as 浏览器
    participant E as Excel
    participant D as 开发者

    rect rgb(254, 226, 226)
        Note over P,D: 传统方式(预计2-3周)
        P->>B: 1. 打开语雀手册
        loop 逐页浏览
            B->>B: 2. 逐个中心阅读
            B->>E: 3. 复制链接到Excel
            B->>E: 4. 手动标注对应功能
        end
        E->>D: 5. 整理好的数据表
        D->>D: 6. 手写JS数据结构
        D->>B: 7. 测试验证
        B-->>D: 发现链接/匹配错误
        D->>B: 8. 返回修正(循环)
    end

    rect rgb(220, 252, 231)
        Note over P,D: VC方式(实际半天)
        P->>D: 1. 给需求:功能项清单+文档库入口
        D->>VC: 2. 去语雀页面提取所有子链接
        VC->>B: 3. 自动浏览+提取标题/slug
        VC-->>D: 4. 返回结构化链接列表
        D->>VC: 5. 匹配功能项到文档链接
        VC->>VC: 6. 语义匹配+数据生成
        VC-->>D: 7. 返回完整JS代码
        D->>B: 8. 浏览器验证
        D->>VC: 9. 指出调整点迭代
    end
效率差异不在编码速度,而在知识处理链路被 AI 接管了。传统流程中信息收集和数据准备占 70% 以上时间,这恰恰是 VC 最擅长的。
实操:让 VC 爬文档的 Prompt 模板
这是超兔一体云诊断页项目中实际使用的提示词模式,可直接复用:
任务:从语雀文档库提取所有功能页链接

入口页:https://www.yuque.com/xtools_help/2021/{中心slug}
操作步骤:
1. 访问入口页,提取所有子页面链接和标题
2. 对每个子页面,记录:标题、URL中的slug、所属分类
3. 返回结构化JSON格式:
   { name: "页面标题", slug: "url中的标识", category: "所属中心" }
4. 不要遗漏任何子页面

输出要求:返回完整的JSON数组,我需要用它来匹配功能选项。
匹配阶段的提示词:
任务:将功能选项与文档链接做语义匹配

功能选项列表:
[粘贴你的功能选项数组]

文档链接列表:
[粘贴VC提取的链接数组]

匹配规则:
1. 按语义相似度匹配,不是关键词匹配
2. 每个功能选项匹配1-3个最相关的文档
3. 输出格式:{ v: "功能描述", docs: [{name, url}, ...] }
4. 匹配不确定的标记 [待确认]
质量把控:人机校验闭环
用 VC 快速处理知识不等于"凑数据"。质量把控的关键是人机校验闭环:
VC批量生成 → 人工快速校验 → 质量OK?
                            ├─ 是 → 交付
                            ├─ 否 → 指出问题 → VC修正 → 再校验
                            └─ 关键项 → 逐个验证 → 交付
超兔一体云诊断页项目的具体实践:
- 每个文档链接逐个验证 slug 有效、内容对应
- 匹配不准的手动纠正(如"客户子表自定义"最终替换为用户提供的精确 slug)
- 防御性代码到位——比如
o.p的 fallback:
// 防止字段缺失导致页面崩溃
// 这正是第一次崩溃的根因:某个选项少了 p 字段
const priority = (o.p || 'p2').toUpperCase();
人的角色从"执行者"变成"校验者和决策者"——不是亲自做每一步,而是确保每一步都做对。
哪些项目适合用知识杠杆
| 项目类型 | 核心特征 | 为什么适合 VC |
|---|---|---|
| 知识整合类 | 内容现成,难点在结构化呈现 | VC 自动提取+匹配+生成 |
| 互动诊断类 | 输入→匹配→输出,逻辑确定 | 确定性逻辑可一次生成 |
| 数据可视化类 | 数据→图表,验证想法 | 快速原型,无需 BI 工具 |
| 临时/内部工具 | 生命周期短 | 开发成本低,不值得工程化 |
不适用:复杂后端逻辑、高安全性、长期维护、多人协作的大型工程——该用传统工程化流程。
五、两方法怎么配合用
整体工作流
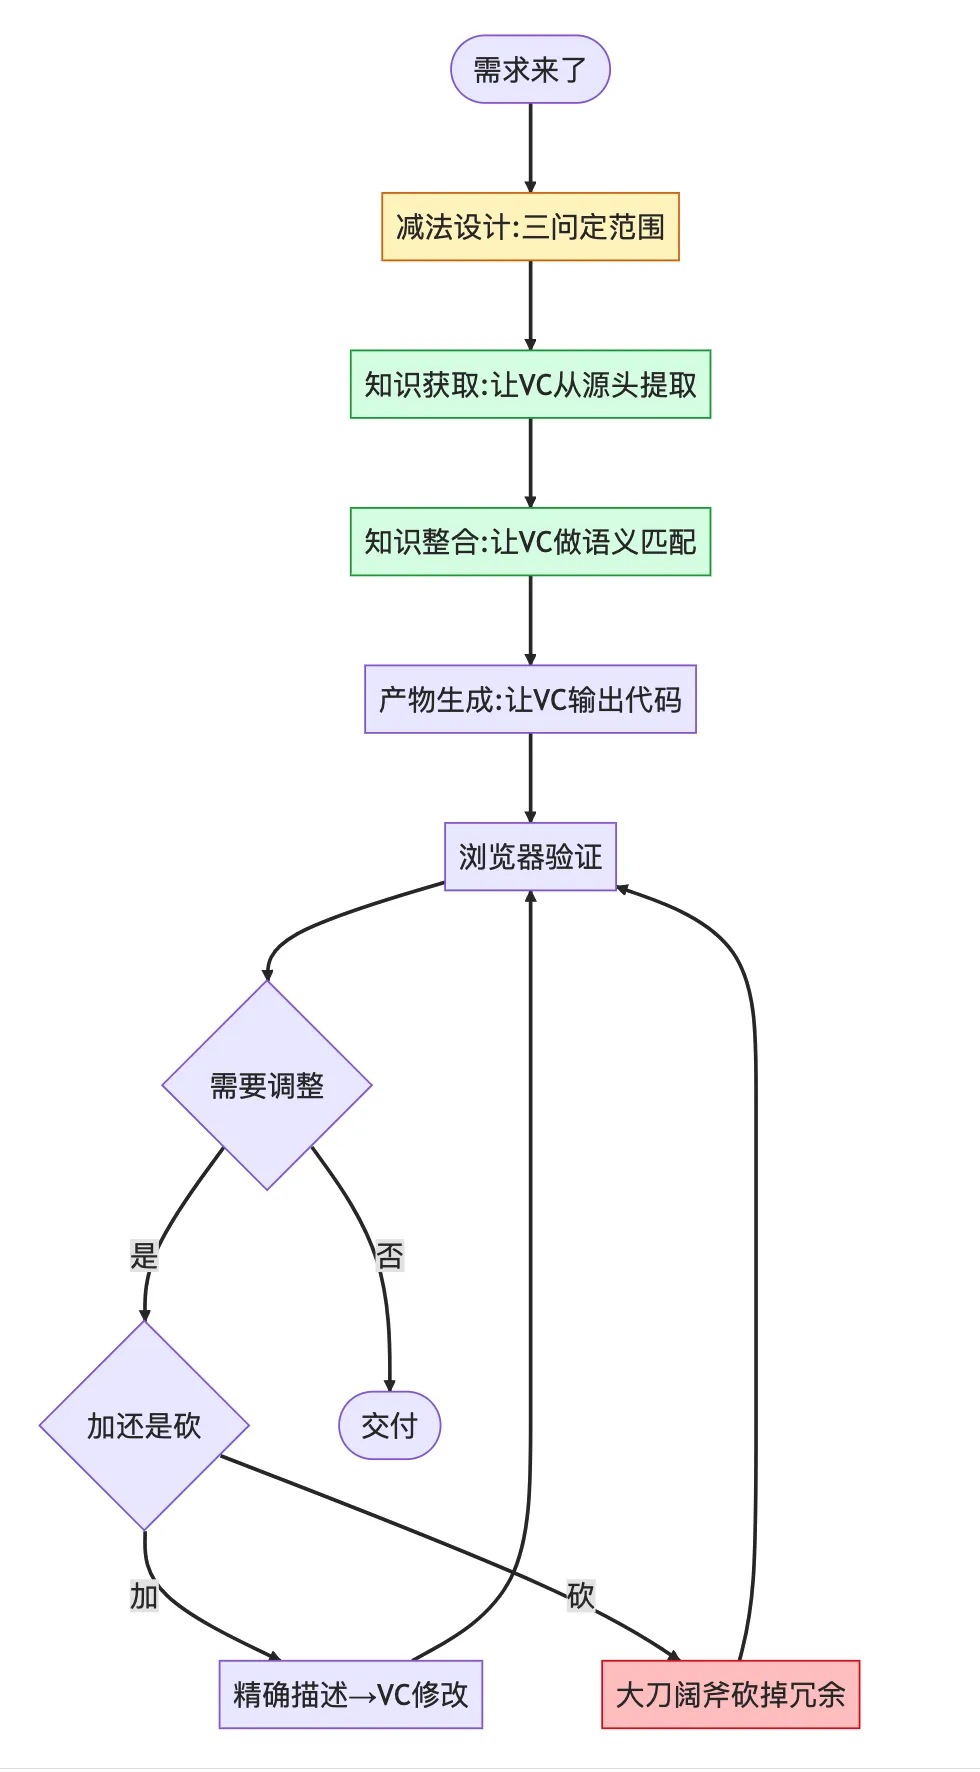
flowchart TB
    START(["需求来了"]) --> S1["减法设计:三问定范围"]
    S1 --> S2["知识获取:让VC从源头提取"]
    S2 --> S3["知识整合:让VC做语义匹配"]
    S3 --> S4["产物生成:让VC输出代码"]
    S4 --> S5["浏览器验证"]
    S5 --> S6{"需要调整"}
    S6 -->|"是"| S7{"加还是砍"}
    S7 -->|"加"| S8["精确描述→VC修改"]
    S7 -->|"砍"| S9["大刀阔斧砍掉冗余"]
    S8 --> S5
    S9 --> S5
    S6 -->|"否"| END(["交付"])

    style S1 fill:#fef3c7,stroke:#d97706
    style S2 fill:#dcfce7,stroke:#16a34a
    style S3 fill:#dcfce7,stroke:#16a34a
    style S9 fill:#fecaca,stroke:#dc2626
人机分工
一句话原则:VC 负责出方案和执行,人负责判断和取舍。
| VC 负责(执行层) | 人负责(决策层) |
|---|---|
| 批量提取网页内容 | 定义核心动作和范围 |
| 生成初始代码/页面 | 判断什么该砍/该留 |
| 数据格式转换填充 | 校验数据准确性 |
| CSS 样式/响应式适配 | 把控视觉风格/体验 |
| Bug 修复/错误处理 | 定义对的标准 |
| 多方案并行生成 | 选择最优方案 |
减法三问(开工前必答)
在让 VC 写代码之前,必须回答三个问题:
- 核心动作:用户打开页面,最想做的那一件事是什么?答不出就先想清楚再动手
- 必要边界:哪些是"雪中送炭",哪些是"锦上添花"?犹豫的就先不加
- 最小层级:能用 1 层不用 2 层,能用 1 页不用 2 页。用户滚动比跳转的耐心高得多
六、我踩过的 5 个坑
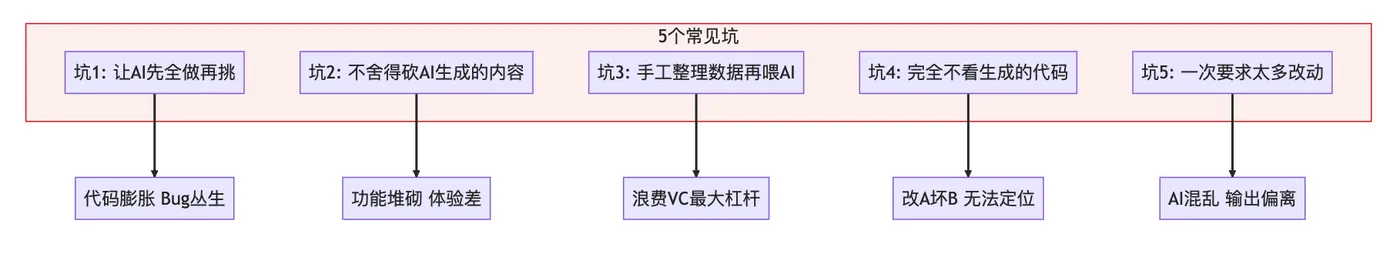
flowchart TD
    subgraph 坑["5个常见坑"]
        E1["坑1: 让AI先全做再挑"]
        E2["坑2: 不舍得砍AI生成的内容"]
        E3["坑3: 手工整理数据再喂AI"]
        E4["坑4: 完全不看生成的代码"]
        E5["坑5: 一次要求太多改动"]
    end
    E1 --> S1["代码膨胀 Bug丛生"]
    E2 --> S2["功能堆砌 体验差"]
    E3 --> S3["浪费VC最大杠杆"]
    E4 --> S4["改A坏B 无法定位"]
    E5 --> S5["AI混乱 输出偏离"]

    style 坑 fill:#fef2f2,stroke:#dc2626
坑 1:让 AI 先全做出来再挑。 最致命的一个。生成成本极低,但纠错成本非线性增长。代码越多越难定位问题。正确做法:先做减法设计,明确 MVP 范围,再让 AI 生成。
坑 2:不舍得砍 AI 生成的内容。 AI 生成的内容看起来都不错,但很多是冗余的。超兔一体云诊断页 22 个选项砍到 10 个,用户反馈反而更好。以用户视角审视,大胆删。
坑 3:手工整理数据再喂给 AI。 这是对 VC 能力的最大浪费。让 AI 自己去浏览、提取、整理数据——它做这件事比你快 100 倍。
坑 4:完全不看生成的代码。 即使 AI 写了 90% 的代码,你仍需能看懂关键部分:数据结构在哪定义、怎么被使用、Bug 出在哪个环节。完全不看代码,"改 A 坏 B"的循环无法避免。
坑 5:一次要求太多改动。 每次迭代聚焦 1-2 个调整点。一次性提 5 个以上改动,AI 容易混乱,输出偏离预期。
七、写在最后
Vibe Coding 最令人兴奋的不是"AI 能写代码了",而是它从根本上降低了把想法变成可用产品的门槛。以前需要一个小团队花几周做的事,现在一个懂业务的人用 VC 几小时就能做出可用版本。
但工具越强,使用者的判断力就越重要。
本文两个方法本质上是一件事:
- 减法确保你做的是对的事情(Do the right things)
- 知识杠杆确保你用最高效的方式做(Do things right)
VC 不会替代工程师,它会替代不思考的工程师。
AI 可以帮你写出任何你能描述出来的页面,但它不会告诉你"这个页面不该有这么多功能",也不会主动去浏览上百篇文档帮你整合知识——除非你明确让它这么做。
善用工具,但不要依赖工具替你思考。做减法,用杠杆,做真正有价值的东西。
你在 VC 项目中踩过什么坑?或者有什么减法设计的心得?欢迎评论区交流。
附录:核心原则速查卡
| 原则 | 核心问题 | 一句话答案 |
|---|---|---|
| 减法设计 | 这个功能真的需要吗? | 犹豫就先不加 |
| 砍层级 | 用户需要走这么深吗? | 能用1层不用2层 |
| 砍选项 | 3秒内说不清区别? | 合并 |
| 砍功能 | 雪中送炭还是锦上添花? | 只做雪中送炭 |
| 知识杠杆 | 数据需要人工整理吗? | 让VC去获取 |
| 人机分工 | 这是执行还是决策? | 人做决策,VC做执行 |
| 质量校验 | 生成结果可信吗? | 关键项逐个验证 |
| 迭代节奏 | 一次改多少? | 每次1-2个调整点 |
| 失控症状 | 应急手段 |
|---|---|
| 页面崩溃,不知道哪坏了 | 先加防御性代码兜底,再逐层排查 |
| AI 生成的代码越来越乱 | 停下来,砍掉冗余部分,重新描述需求 |
| 迭代多次还是不对 | 回到减法三问,重新确认核心动作 |
| 用户反馈"太复杂" | 大刀阔斧砍层级和选项 |
标签:
Vibe CodingAI编程开发方法论减法设计效率工程SaaS实践