
阿里云通义千问Qwen3.7系列包含Max、Plus、Flash三大核心版本,三者定位清晰、能力互补,分别面向极致推理、多模态全能、轻量高效三大场景。三款模型共享100万Tokens超长上下文窗口与35小时自治执行上限,但在模态能力、架构设计、输出上限、推理速度与计费标准上存在本质差异。本文结合实测数据,从核心定位、基础参数、能力表现、成本性价比、场景适配五大维度,全面解析三大版本的区别,为个人与企业提供精准选型参考。
一、三大版本核心定位与基础参数
(一)Qwen3.7 Max:纯文本旗舰,极致推理王者
Max是Qwen3.7系列的纯文本旗舰模型,采用全参数密集架构,参数量约1.2T,推理时激活约450亿参数,专注于极致文本推理、长文本连贯性与复杂逻辑推演。其核心定位是高强度智能体、百万行代码重构、超长文档深度分析、高精度金融/法律推演等对文本能力要求极高的专业场景。基础参数方面,最大输出Tokens为65536,纯文本场景推理速度比Plus快7%-15%,无视觉/视频处理能力。详情👉访问阿里云百炼大模型服务平台页面 了解
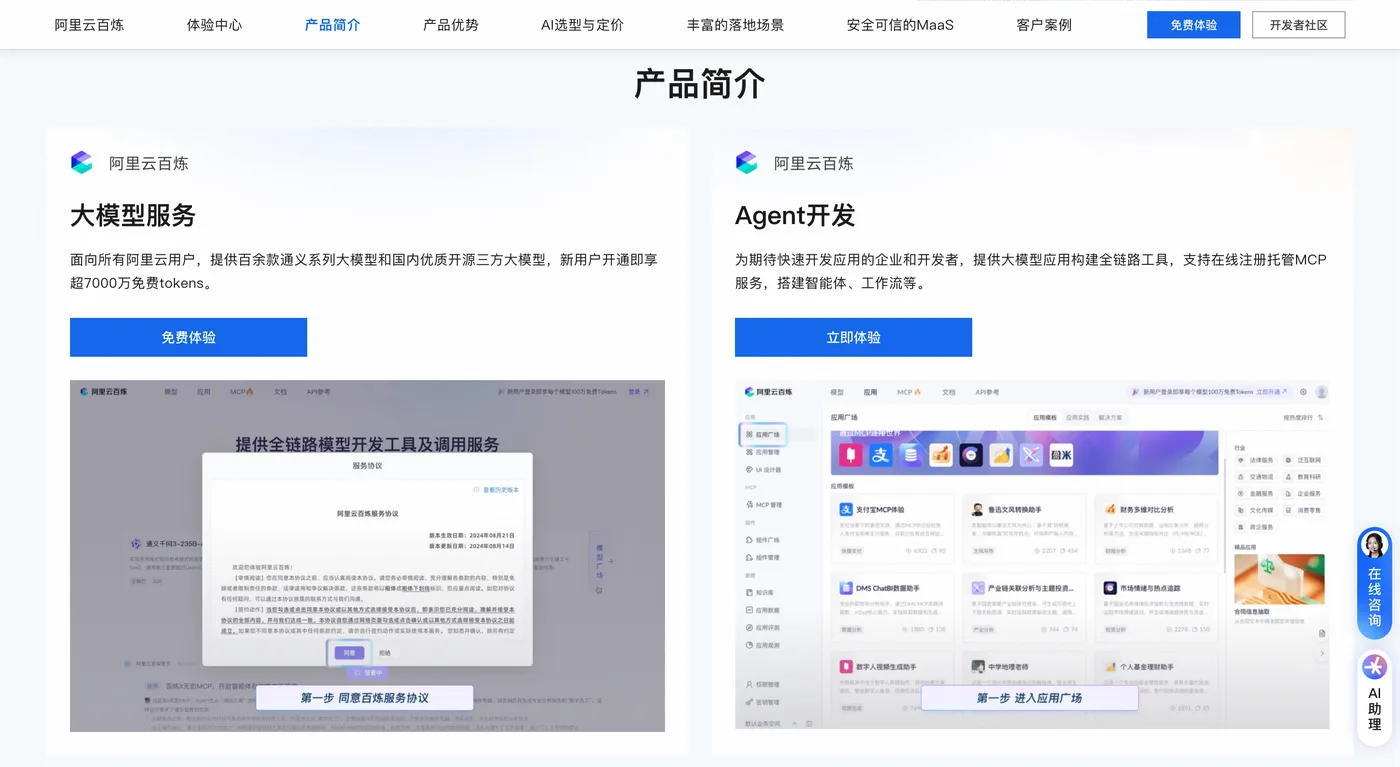
(二)Qwen3.7 Plus:多模态全能,性价比之王
Plus是系列中的多模态全能选手,原生支持文本+图像+视频输入,打破纯文本模型的能力边界。它在保持高推理质量的同时,成本大幅降低,是兼顾能力与性价比的最优选择。基础参数上,最大输出Tokens为32768,推理速度比Max快3倍左右,支持图像理解、视频分析、截图调试、设计稿解读等多模态任务,是商用场景的主流选择。
(三)Qwen3.7 Flash:轻量高效,极速响应之选
Flash是系列中的轻量化版本,主打极速响应与极致性价比,采用精简架构设计,专注于简单、高频、实时的文本处理场景。其核心定位是日常问答、文案生成、简单总结、实时交互等轻量化任务,推理速度最快,成本最低,适合高并发、低延迟的基础场景。基础参数方面,最大输出Tokens为16384,无多模态能力,纯文本处理效率最高。
(四)基础参数对比(核心维度)
- 上下文窗口:三款均为100万Tokens,满足超长文本处理需求。
- 模态能力:Max纯文本;Plus文本+图像+视频;Flash纯文本。
- 最大输出:Max 65536;Plus 32768;Flash 16384。
- 推理速度:Flash > Plus > Max(纯文本场景)。
- 自治执行:三款均支持35小时连续自治执行。
二、三大版本能力实测对比
(一)文本推理能力
- Max:在复杂逻辑推理、数学计算、法律条文解读、金融分析等高精度文本任务中表现最优,SWE-Bench Pro得分60.6%,在纯文本编码、长文本连贯性上领先Plus约2个百分点。开启深度思考模式后,处理超长文档、百万行代码重构的能力无出其右,适合需要极致推理的专业场景。
- Plus:文本推理能力接近Max,在AIME数学竞赛等任务中与Max持平,15道竞赛题均答对14道。日常文本处理、文案创作、内容总结、常规编程等任务表现稳定,完全满足商用需求,且推理速度比Max快3倍,效率更高。
- Flash:文本推理能力满足基础需求,适合简单问答、短文本生成、快速总结等轻量化任务,复杂逻辑与长文本处理能力较弱,但响应速度最快,适合实时交互场景。详情👉访问阿里云百炼大模型服务平台页面 了解
(二)多模态能力
- Max:无任何视觉/视频处理能力,仅支持纯文本输入输出,无法处理图像、视频、截图等多模态内容。
- Plus:原生支持图像理解、视频分析、OCR识别、设计稿解读、截图调试等多模态任务。可精准识别图片内容、分析视频帧、解读设计图细节,在电商商品图分析、文档图片识别、代码截图调试等场景表现出色,是唯一支持多模态的版本。
- Flash:无多模态能力,仅支持纯文本处理。
(三)编程能力
- Max:纯文本编程能力最强,SWE-Bench Pro得分领先,支持百万行代码重构、复杂算法实现、深度代码调试,适合专业开发、大型项目代码处理场景。
- Plus:编程能力接近Max,在10个真实Bug修复任务中全部成功(10/10),优于Max的9/10。支持视觉编程,可通过截图调试代码、解读设计稿中的代码逻辑,是编程+多模态场景的唯一选择。
- Flash:支持基础代码生成、简单脚本编写,复杂算法与大型代码处理能力不足,适合快速生成简单代码片段。
(四)推理速度与响应效率
- Flash:响应速度最快,纯文本任务平均响应时间比Plus快50%,比Max快2倍以上,适合高并发、低延迟的实时交互场景。
- Plus:推理速度比Max快3倍左右,在多模态与文本任务中均保持高效响应,平衡速度与能力。
- Max:纯文本场景推理速度比Plus快7%-15%,但多模态任务无能力,整体响应效率低于Plus。
三、三大版本成本性价比实测
(一)计费标准(每百万Tokens)
- Max:输入$2.50,输出$7.50,缓存输入$0.25(90%折扣)。
- Plus:输入$0.40,输出$1.60,缓存输入$0.08。
- Flash:输入$0.10,输出$0.40,缓存输入$0.01。
(二)性价比对比
- Max:成本最高,是Plus的6倍左右,适合对推理精度要求极高、不计成本的专业场景。
- Plus:性价比最高,以Max约1/6的成本,实现接近Max的文本能力与完整多模态能力,是商用场景的首选。
- Flash:成本最低,是Plus的1/4,Max的1/25,适合轻量化、高频次、低成本的基础场景。
(三)成本优化要点
- 优先使用缓存功能,重复输入内容仅计费一次,成本可降90%。
- 简单任务用Flash,常规任务用Plus,复杂专业任务用Max,避免高射炮打蚊子。
- 多模态场景必选Plus,Max无法处理,Flash无能力,避免无效成本。
四、三大版本场景适配方案
(一)Qwen3.7 Max适用场景
- 专业领域:金融分析、法律推演、医疗诊断、学术研究等高精度文本推理场景。
- 开发场景:百万行代码重构、复杂算法实现、深度代码调试、智能体开发。
- 长文本场景:超长文档分析、百万字内容总结、长篇小说创作、多轮深度对话。
- 核心优势:极致推理精度、长文本连贯性、复杂逻辑处理能力。
(二)Qwen3.7 Plus适用场景
- 多模态场景:图像分析、视频理解、设计稿解读、截图调试、OCR识别。
- 商用场景:电商内容生成、广告创意、短视频脚本、品牌宣传、客户服务。
- 开发场景:常规代码编写、Bug修复、视觉编程、小程序开发。
- 通用场景:日常问答、文案创作、内容总结、翻译、知识问答。
- 核心优势:多模态全能、高性价比、推理速度快、平衡能力与成本。
(三)Qwen3.7 Flash适用场景
- 轻量化场景:简单问答、快速总结、短文案生成、实时交互、基础翻译。
- 高并发场景:客服机器人、智能问答、实时信息查询、高频次基础任务。
- 低成本场景:个人日常使用、小型项目基础处理、批量简单文本生成。
- 核心优势:极速响应、极致性价比、低延迟、高并发支持。
五、选型决策指南
(一)按能力需求选型
- 需多模态处理(图像/视频):必选Plus,Max与Flash无此能力。
- 需极致文本推理/复杂编程:选Max,Plus接近但略有差距。
- 仅需基础文本处理/极速响应:选Flash,成本最低、速度最快。详情👉访问阿里云百炼大模型服务平台页面 了解
(二)按成本预算选型
- 预算充足、追求极致能力:选Max。
- 预算中等、兼顾能力与成本:选Plus(首选)。
- 预算有限、仅需基础功能:选Flash。
(三)按场景复杂度选型
- 复杂专业场景(金融/法律/大型开发):Max。
- 通用商用场景(多模态/常规开发/内容创作):Plus。
- 简单轻量化场景(日常问答/快速处理):Flash。
六、总结
Qwen3.7三大版本形成清晰的产品矩阵,Max专注极致推理,Plus主打多模态全能与高性价比,Flash聚焦轻量高效与极速响应。三者共享超长上下文与自治执行能力,在能力、成本、场景上形成完美互补。选型核心原则是“按需匹配”:多模态与通用商用场景优先选Plus,复杂专业推理选Max,轻量化基础场景选Flash。通过精准选型,可在满足需求的同时,实现成本最优与效率最大化,充分发挥Qwen3.7系列的价值。
