
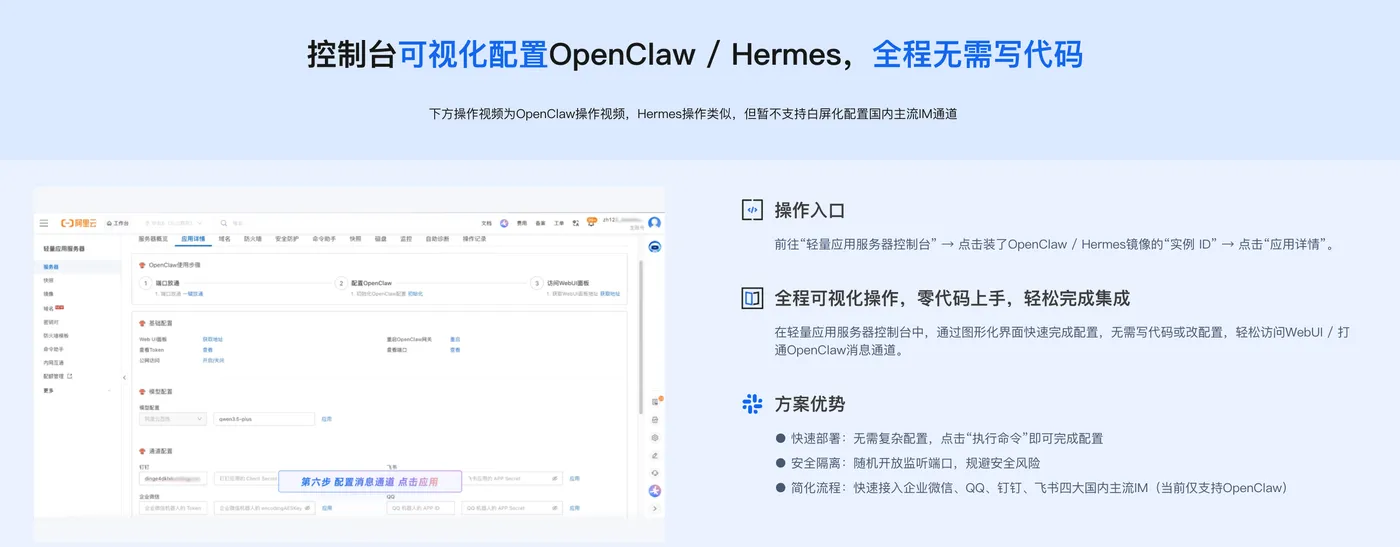
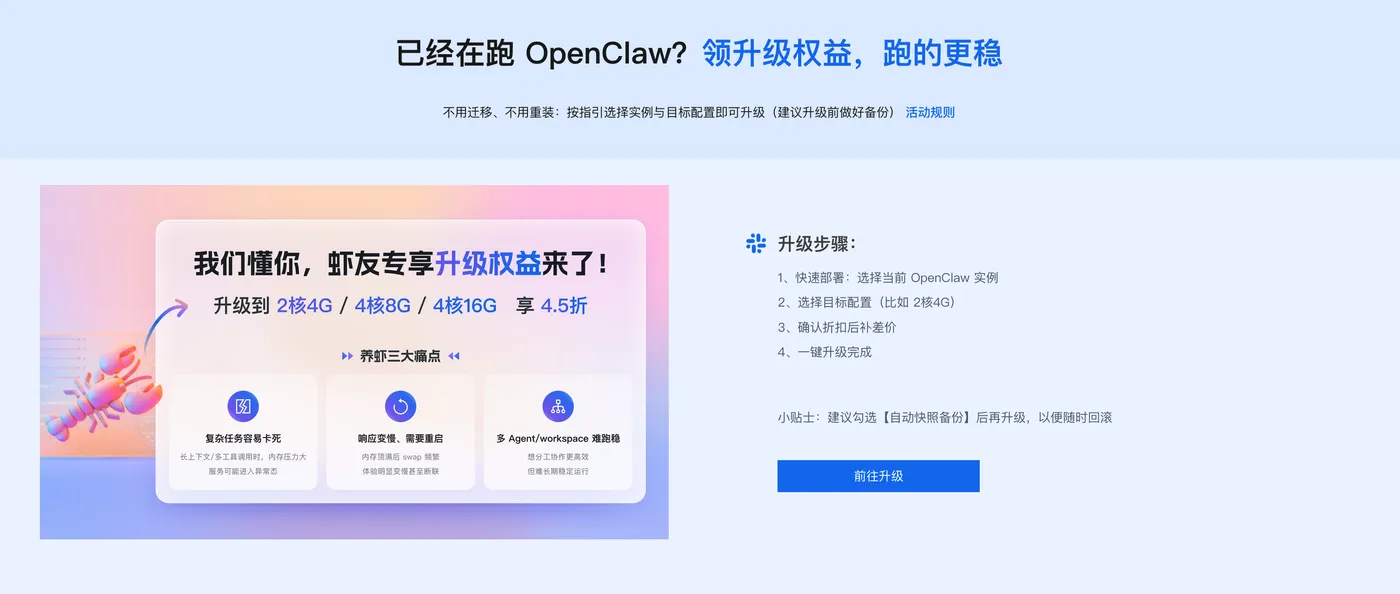
GLM 5.2是智谱推出的开源混合专家大模型,拥有7440亿总参数、400亿激活参数,原生支持100万tokens超长上下文,在长文档分析、复杂代码生成、多步骤AI智能体任务上表现突出,MIT开源协议允许企业完全私有化部署,数据无需外流,满足隐私合规需求。但超大模型对GPU硬件要求极高,需要根据业务并发、上下文长度选择BF16、FP8、Q4_K_M、UD-IQ2四类量化权重,并搭配vLLM、SGLang两类主流推理框架搭建服务。本文从量化硬件匹配、两套推理框架完整部署实操、自托管与线上API成本测算、AI智能体后端适配、常见故障排查五大维度完整讲解落地流程,同时结合Hermes、OpenClaw两款主流智能体给出后端选型建议。阿里云部署AI Agent:OpenClaw/Hermes Agent全网最简单,只需两步,详情👉访问阿里云OpenClaw/Hermes一键部署专题页面 了解。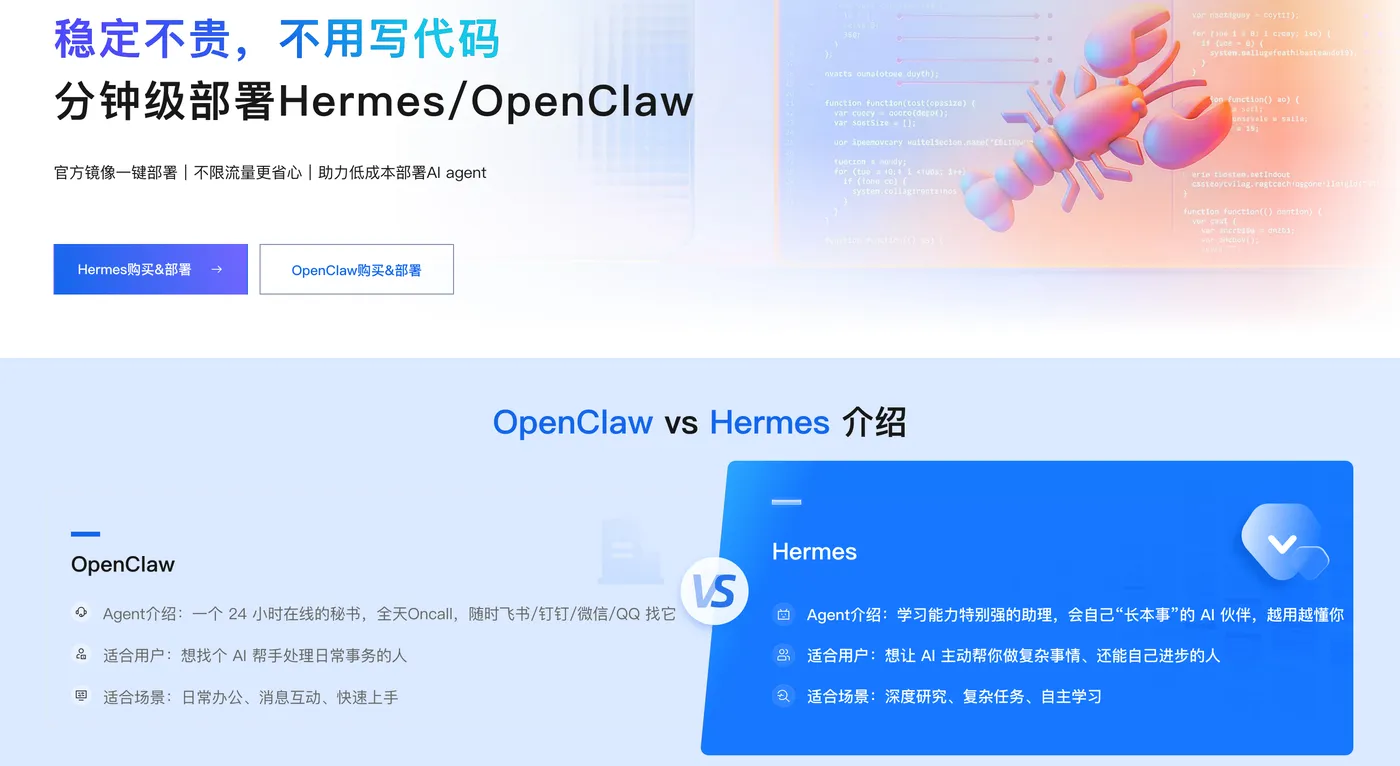
Token Plan Token最便宜/支持多模型切换:👉访问订阅阿里云百炼Token Plan AI大模型服务 。支持多模型切换,用于多模态模型灵活调用,实现多模型、多工具、多场景下的额度共享与统一管理,兼顾灵活性、稳定性与安全性,大幅降低企业使用大模型的门槛与成本。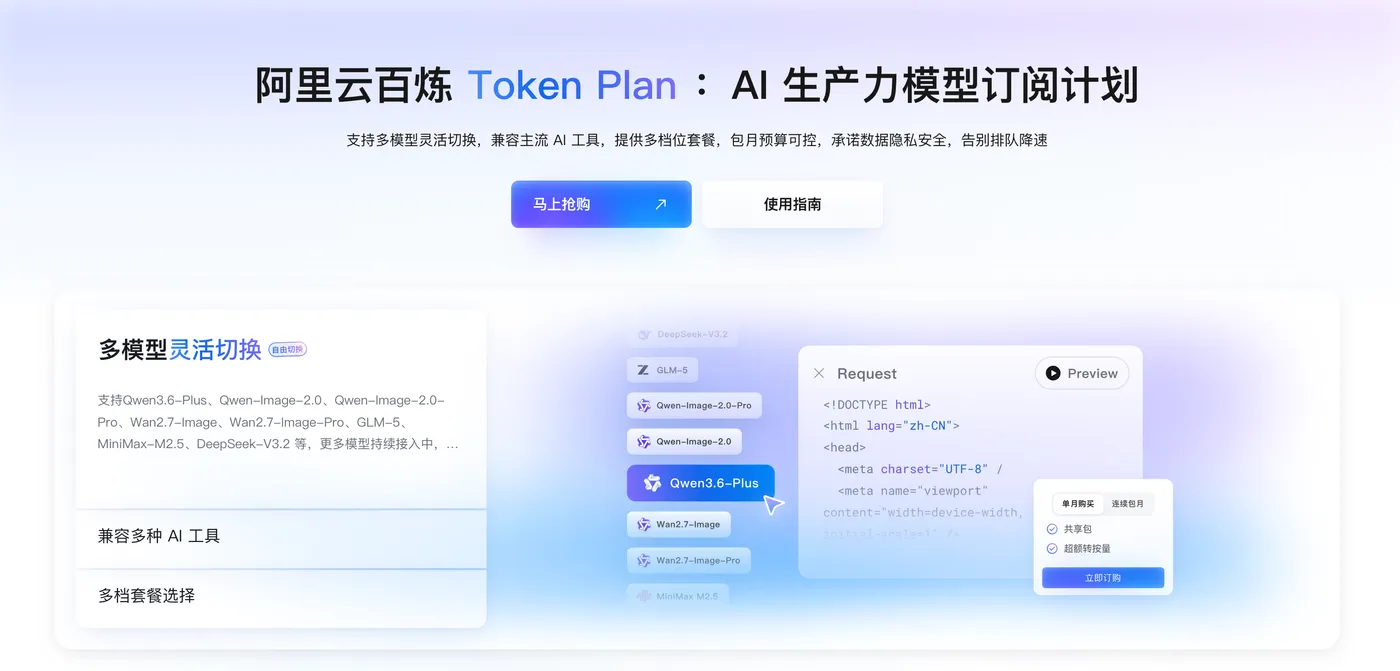
一、GLM 5.2四大量化版本硬件与存储匹配
不同量化版本磁盘占用、显存需求差距极大,错误选型会出现显存溢出、推理速度过低等问题,按业务场景区分配置标准。
- BF16原生全精度版
磁盘占用约1.5TB,推理效果最优,无精度损失,但硬件门槛极高,生产环境至少16张H100 80GB显卡集群,仅适合顶尖科研机构做基准测试,普通企业无落地价值,云端租赁成本难以承受。 - FP8 E4M3量化版
云端生产主流方案,磁盘占用750GB,KV缓存同步量化减半显存占用,兼容H20、H10 Hopper架构GPU。生产最低标准8×H200 141GB节点,可稳定承载256K并发上下文;若使用8卡H100,长文本请求极易触发OOM显存溢出,仅适合短对话业务。 - Q4_K_M GGUF量化版
中型企业平衡成本与性能的选择,磁盘376GB,依靠主机内存分担KV缓存,最低生产配置4×H100 80GB,支持常规长文档、代码推理,适配中小型智能体业务。 - UD-IQ2轻量量化版
仅适合个人本地调试,磁盘仅241GB,只能在Mac Studio M3 Ultra(统一内存≥256GB)运行,单任务推理速度3至9token/s,无法支撑并发线上服务,仅用于单人代码、文档测试。
配套硬件通用要求:存储使用1TB以上高速SSD存放权重,主机物理内存不低于256GB,生产环境推荐512GB;内网带宽10Gbps以上,避免多卡张量并行时IO瓶颈拖慢推理速度。
二、两套推理框架完整部署实操
vLLM、SGLang均原生支持GLM 5.2,但适配场景完全区分:vLLM面向通用线上对话、批量文本生成;SGLang内置RadixAttention优化,百万上下文、多轮智能体任务吞吐高出三成,是Hermes、OpenClaw等长任务Agent的首选后端。
(一)vLLM通用生产部署步骤
- 隔离虚拟环境,避免依赖冲突
python3 -m venv glm52-vllm source glm52-vllm/bin/activate pip install vllm==0.23.0 huggingface-hub - 拉取FP8权重并校验磁盘占用,确保存储空间充足
huggingface-cli download zai-org/GLM-5.2-FP8 --local-dir /data/models/glm52-fp8 du -sh /data/models/glm52-fp8 - 生产启动核心命令,适配8卡H200集群,开启缓存与工具调用
vllm serve "zai-org/GLM-5.2-FP8" \ --tensor-parallel-size 8 \ --max-model-len 262144 \ --kv-cache-dtype fp8 \ --enable-prefix-caching \ --port 8000 \ --gpu-memory-utilization 0.8 \ --tool-call-parser glm47 \ --reasoning-parser glm45 - 接口冒烟测试,返回OK即代表服务正常
通过curl发送简短对话请求,若返回空或报错,下调max-model-len参数降低上下文长度,缓解显存压力。
(二)SGLang长智能体专属部署步骤
适合Hermes、OpenClaw多步骤复杂任务,内置推测解码提升长文本输出速度:
- 新建独立运行环境并安装依赖
python3 -m venv glm52-sglang source glm52-sglang/bin/activate pip install sglang==0.5.13.post1 huggingface-hub - 启动服务,启用EAGLE推测加速,区分端口与vLLM隔离
python3 -m sglang.launch_server \ --model-path zai-org/GLM-5.2-FP8 \ --tp-size 8 \ --max-model-len 262144 \ --kv-cache-dtype fp8 \ --enable-prefix-caching \ --port 8001 \ --speculative-algorithm EAGLE \ --speculative-num-steps 3 - 验证逻辑与vLLM一致,仅修改访问端口为8001;百万文档RAG、自动报告生成等场景优先选用SGLang。
三、自托管与线上API成本盈亏测算
自托管优势在于数据不出内网、长期高并发场景成本更低,但前期硬件投入巨大,需要按日均请求量判断落地可行性。
- 成本构成拆分
自托管成本:GPU硬件采购/云端租赁费用、3年硬件折旧、机房电费、运维人力、存储网络开销;云端8×H200节点每小时租赁价格30至50美元,24小时不间断运行月度成本超两万美元。
线上托管API:按输入、输出Token计费,高端模型单价偏高,轻度使用无硬件门槛,无需运维。 - 盈亏临界标准
日均持续请求3000次以上,企业自有机房硬件前提下,自托管长期综合成本低于线上API;日均请求低于1000次,直接选用托管API更划算,硬件投入完全不经济;1000至3000次可采用混合方案,核心业务自托管,临时轻量任务调用线上服务。 - 成本优化手段
优先选用FP8量化降低显卡需求;全局开启Prefix前缀缓存,复用固定系统提示词减少重复算力消耗;个人调试使用Mac轻量量化方案,避免租赁昂贵GPU;生产区分任务长短,短对话用vLLM,长智能任务切换SGLang,提升单卡吞吐。
四、GLM 5.2后端搭配Hermes/OpenClaw选型方案
两款主流AI智能体对推理框架适配需求不同,可结合GLM 5.2特性选择后端:
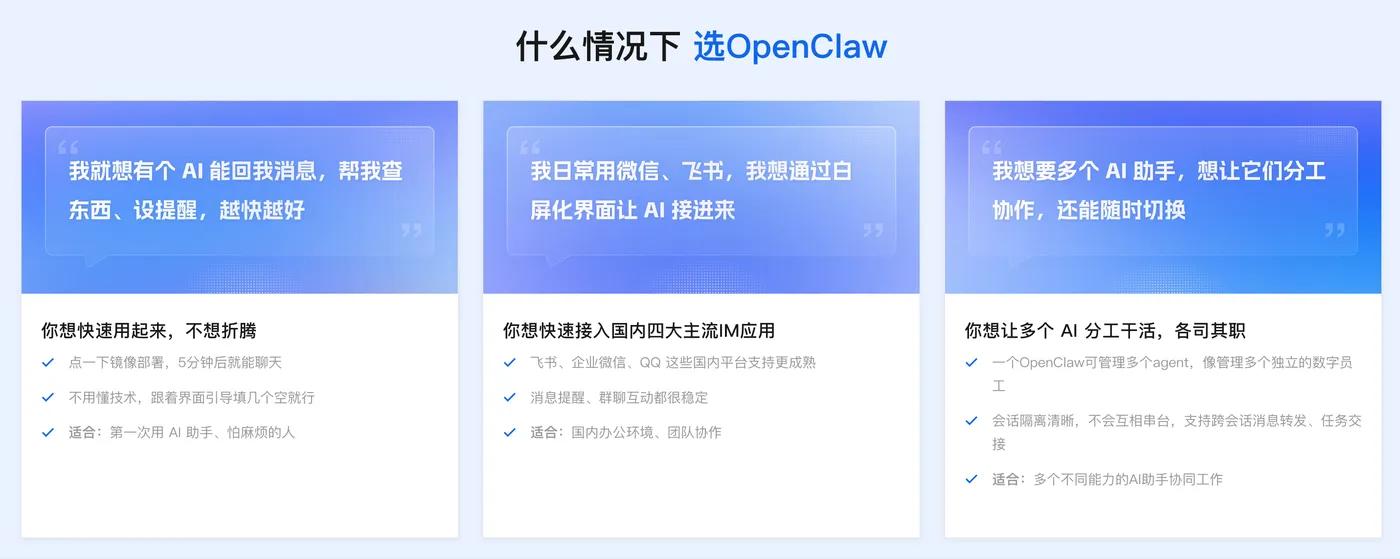
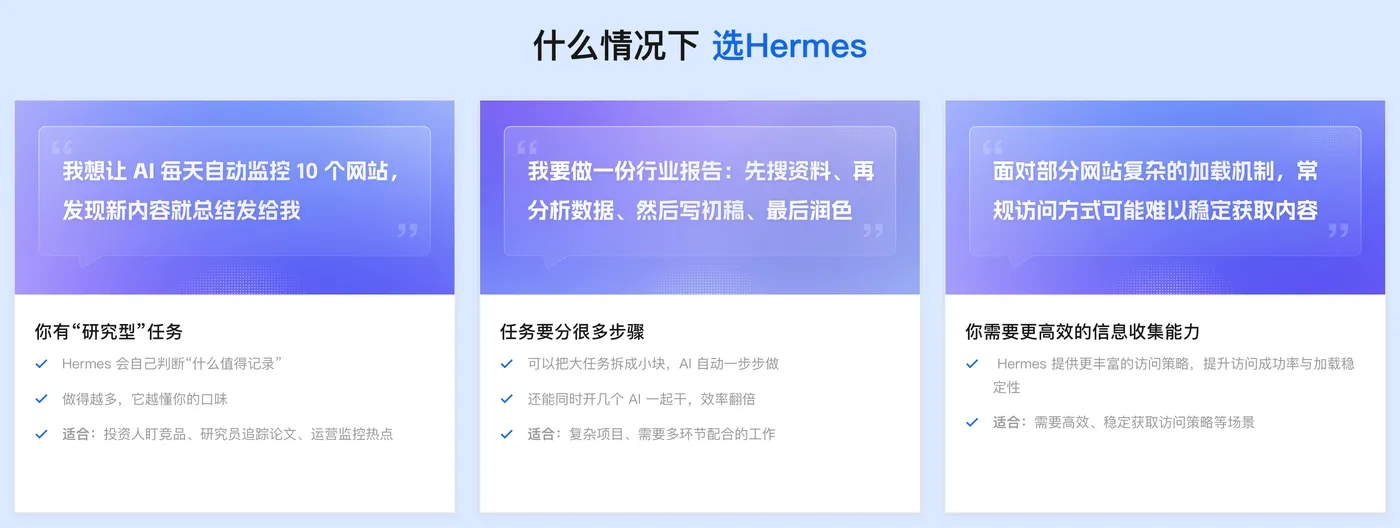
- Hermes Agent:主打自主学习、多步骤行业研究、定时网页监控、长篇行业报告,单次任务上下文可达数十万Token,优先部署SGLang作为GLM 5.2推理后端,RadixAttention大幅提升长文档处理吞吐,任务拆解、多轮迭代稳定性更强。
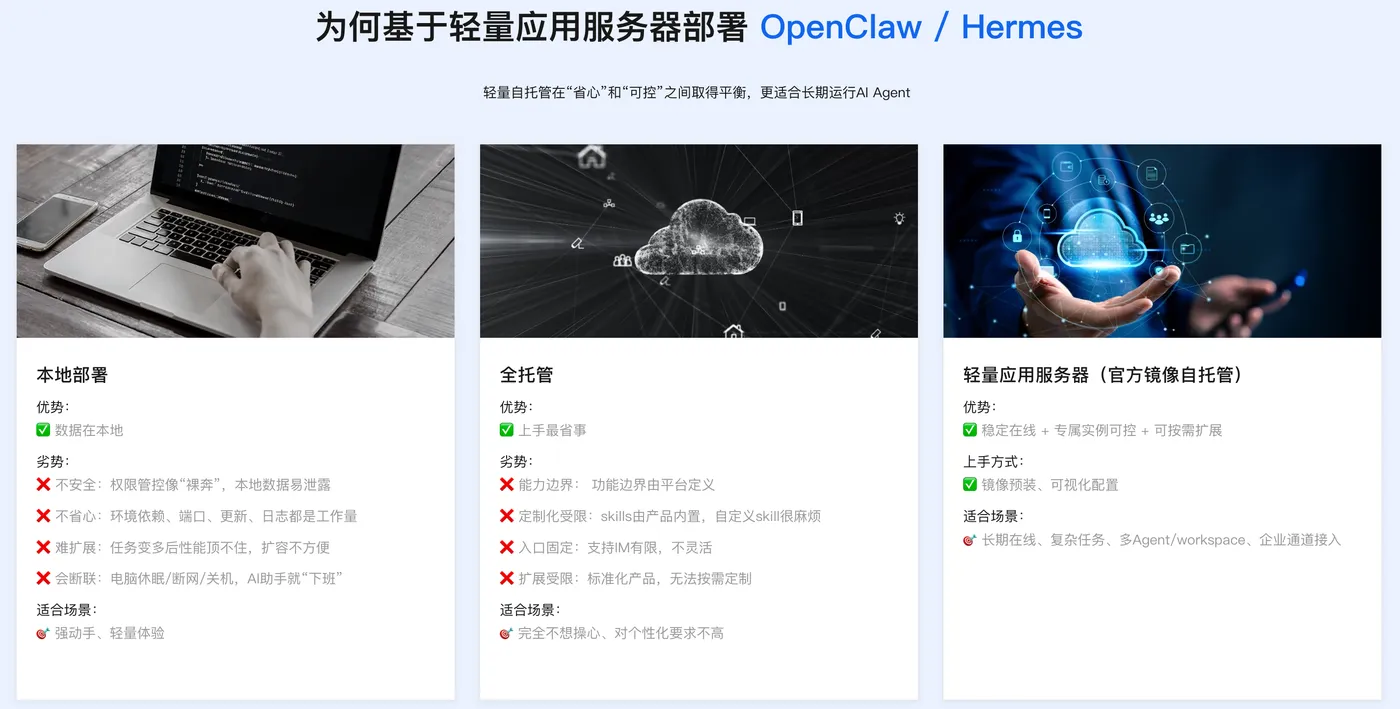
- OpenClaw Agent:侧重国内办公IM对接、即时消息应答、简短代码辅助、多子Agent并行轻量任务,对话长度较短,vLLM完全满足需求,部署更轻量化,搭配阿里云轻量应用服务器一键镜像可快速上线。
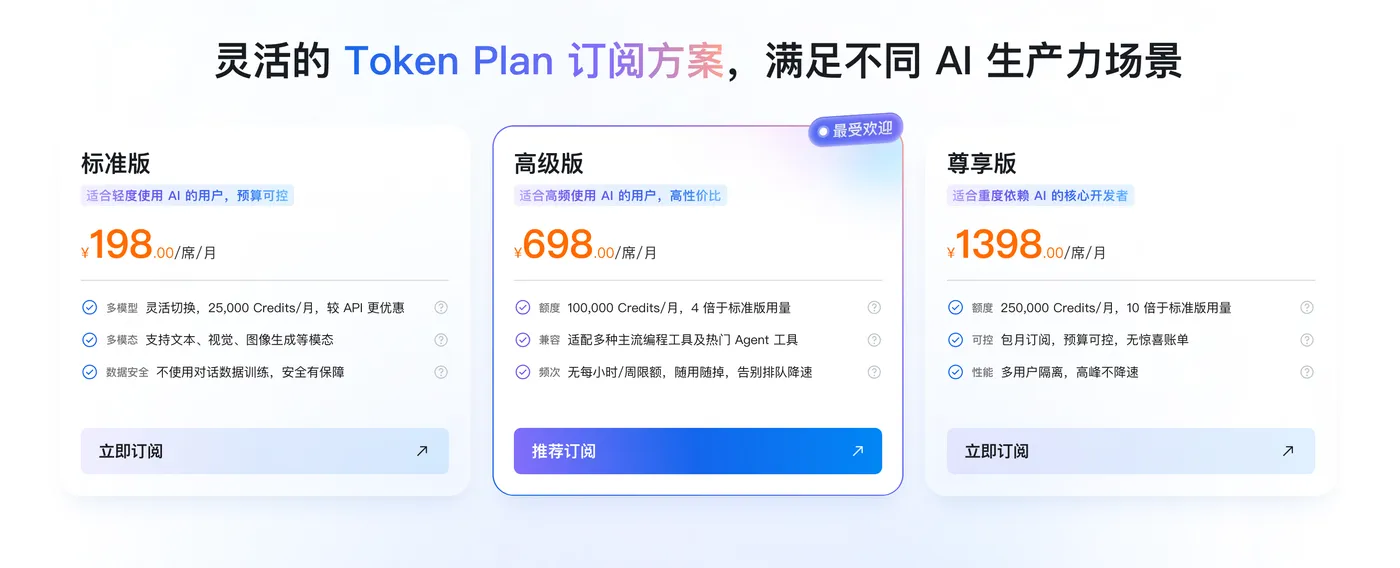
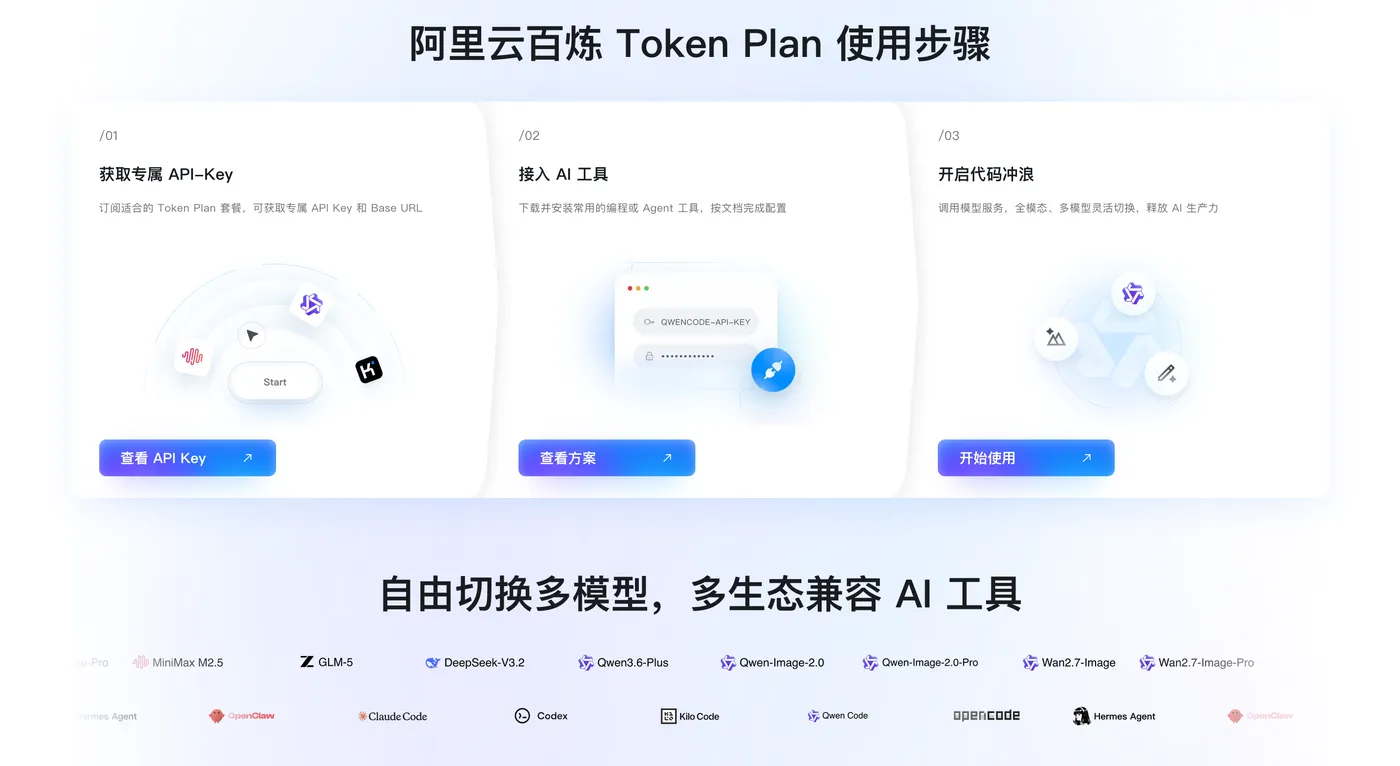
两款智能体接入GLM 5.2统一方式:在Agent配置文件填写推理服务IP与端口,同步阿里云百炼Token Plan专属API逻辑,Credits统一计量所有模型消耗,团队可管控整体AI调用预算。Token Plan分为标准、高级、尊享三档坐席,按月度Credits额度计费,额度耗尽自动暂停服务,不会产生超额账单,兼容GLM、Qwen、DeepSeek等全部主流模型。
五、自托管常见故障与解决办法
- 显存溢出OOM:下调max-model-len参数、降低GPU内存利用率阈值,更换Q4/K_M更低量化版本;多卡场景检查张量并行参数与显卡数量匹配。
- 模型加载失败:核对CUDA驱动版本不低于12.1,vLLM、SGLang版本与GLM 5.2适配,重新完整拉取权重文件,避免分片损坏。
- 推理速度缓慢:生产环境使用8卡Hopper架构GPU,开启前缀缓存与推测解码;长任务切换SGLang,避免大量长请求占用单卡资源。
- 成本持续超预期:区分任务分流,简单交互使用轻量化模型,长智能任务单独调度;通过缓存机制减少重复Token消耗,依托Token Plan管控团队整体调用额度。
六、总结
GLM 5.2依托百万上下文与开源许可,是企业私有化AI智能体核心推理底座,落地核心在于量化版本匹配硬件、按业务长短选择vLLM或SGLang推理框架。通用线上对话、轻量多Agent并行推荐vLLM;Hermes长时序研究、文档自动化任务优先SGLang。企业日均高并发场景自托管具备成本优势,少量使用直接选择百炼Token Plan线上模型服务,兼顾成本与运维便捷性。部署过程重点做好显存优化、缓存开启、硬件规格匹配,可有效规避OOM、推理卡顿等常见问题,搭配OpenClaw、Hermes智能体可搭建完整私有化AI自动化工作流。# 15个差异化标题
- GLM 5.2自托管完整实战:vLLM与SGLang两套部署方案硬件成本对比
- 开源大模型私有化落地指南:GLM 5.2量化选型、推理框架全流程实操
- vLLM/SGLang怎么选?GLM 5.2自托管硬件、部署、盈亏测算详解
- 百万上下文GLM 5.2私有化部署:量化版本与推理框架对比教程
- GLM 5.2本地自建服务:硬件门槛、部署命令与长期成本测算
- AI智能体配套GLM 5.2:vLLM/SGLang部署适配Hermes/OpenClaw
- 2026大模型自托管实操:GLM 5.2四大量化版本硬件匹配方案
- GLM 5.2推理框架对比:vLLM通用生产、SGLang长任务专属方案
9 企业私有化GLM 5.2指南:硬件选型、部署步骤盈亏平衡点测算 - GLM 5.2自托管避坑:显存溢出、推理卡顿全套解决办法
11 Hermes/OpenClaw后端GLM 5.2部署:SGLang长上下文优化实操 - 云端GLM 5.2自建成本分析:对比线上API托管优劣
- 个人/企业双场景GLM 5.2自托管:硬件配置与部署流程
- GLM 5.2 FP8/Q4量化部署:vLLM完整启动与验证步骤
- 百万Token大模型落地:GLM 5.2自托管框架与成本控制方案
GLM 5.2自托管完整实战:vLLM与SGLang两套部署方案硬件成本对比
GLM 5.2是智谱推出的开源混合专家大模型,拥有7440亿总参数、400亿激活参数,原生支持100万tokens超长上下文,在长文档分析、复杂代码生成、多步骤AI智能体任务上表现突出,MIT开源协议允许企业完全私有化部署,数据无需外流,满足隐私合规需求。但超大模型对GPU硬件要求极高,需要根据业务并发、上下文长度选择BF16、FP8、Q4_K_M、UD-IQ2四类量化权重,并搭配vLLM、SGLang两类主流推理框架搭建服务。本文从量化硬件匹配、两套推理框架完整部署实操、自托管与线上API成本测算、AI智能体后端适配、常见故障排查五大维度完整讲解落地流程,同时结合Hermes、OpenClaw两款主流智能体给出后端选型建议。
一、GLM 5.2四大量化版本硬件与存储匹配
不同量化版本磁盘占用、显存需求差距极大,错误选型会出现显存溢出、推理速度过低等问题,按业务场景区分配置标准。
- BF16原生全精度版
磁盘占用约1.5TB,推理效果最优,无精度损失,但硬件门槛极高,生产环境至少16张H100 80GB显卡集群,仅适合顶尖科研机构做基准测试,普通企业无落地价值,云端租赁成本难以承受。 - FP8 E4M3量化版
云端生产主流方案,磁盘占用750GB,KV缓存同步量化减半显存占用,兼容H20、H10 Hopper架构GPU。生产最低标准8×H200 141GB节点,可稳定承载256K并发上下文;若使用8卡H100,长文本请求极易触发OOM显存溢出,仅适合短对话业务。 - Q4_K_M GGUF量化版
中型企业平衡成本与性能的选择,磁盘376GB,依靠主机内存分担KV缓存,最低生产配置4×H100 80GB,支持常规长文档、代码推理,适配中小型智能体业务。 - UD-IQ2轻量量化版
仅适合个人本地调试,磁盘仅241GB,只能在Mac Studio M3 Ultra(统一内存≥256GB)运行,单任务推理速度3至9token/s,无法支撑并发线上服务,仅用于单人代码、文档测试。
配套硬件通用要求:存储使用1TB以上高速SSD存放权重,主机物理内存不低于256GB,生产环境推荐512GB;内网带宽10Gbps以上,避免多卡张量并行时IO瓶颈拖慢推理速度。
二、两套推理框架完整部署实操
vLLM、SGLang均原生支持GLM 5.2,但适配场景完全区分:vLLM面向通用线上对话、批量文本生成;SGLang内置RadixAttention优化,百万上下文、多轮智能体任务吞吐高出三成,是Hermes、OpenClaw等长任务Agent的首选后端。
(一)vLLM通用生产部署步骤
- 隔离虚拟环境,避免依赖冲突
python3 -m venv glm52-vllm source glm52-vllm/bin/activate pip install vllm==0.23.0 huggingface-hub - 拉取FP8权重并校验磁盘占用,确保存储空间充足
huggingface-cli download zai-org/GLM-5.2-FP8 --local-dir /data/models/glm52-fp8 du -sh /data/models/glm52-fp8 - 生产启动核心命令,适配8卡H200集群,开启缓存与工具调用
vllm serve "zai-org/GLM-5.2-FP8" \ --tensor-parallel-size 8 \ --max-model-len 262144 \ --kv-cache-dtype fp8 \ --enable-prefix-caching \ --port 8000 \ --gpu-memory-utilization 0.8 \ --tool-call-parser glm47 \ --reasoning-parser glm45 - 接口冒烟测试,返回OK即代表服务正常
通过curl发送简短对话请求,若返回空或报错,下调max-model-len参数降低上下文长度,缓解显存压力。
(二)SGLang长智能体专属部署步骤
适合Hermes、OpenClaw多步骤复杂任务,内置推测解码提升长文本输出速度:
- 新建独立运行环境并安装依赖
python3 -m venv glm52-sglang source glm52-sglang/bin/activate pip install sglang==0.5.13.post1 huggingface-hub - 启动服务,启用EAGLE推测加速,区分端口与vLLM隔离
python3 -m sglang.launch_server \ --model-path zai-org/GLM-5.2-FP8 \ --tp-size 8 \ --max-model-len 262144 \ --kv-cache-dtype fp8 \ --enable-prefix-caching \ --port 8001 \ --speculative-algorithm EAGLE \ --speculative-num-steps 3 - 验证逻辑与vLLM一致,仅修改访问端口为8001;百万文档RAG、自动报告生成等场景优先选用SGLang。
三、自托管与线上API成本盈亏测算
自托管优势在于数据不出内网、长期高并发场景成本更低,但前期硬件投入巨大,需要按日均请求量判断落地可行性。
- 成本构成拆分
自托管成本:GPU硬件采购/云端租赁费用、3年硬件折旧、机房电费、运维人力、存储网络开销;云端8×H200节点每小时租赁价格30至50美元,24小时不间断运行月度成本超两万美元。
线上托管API:按输入、输出Token计费,高端模型单价偏高,轻度使用无硬件门槛,无需运维。 - 盈亏临界标准
日均持续请求3000次以上,企业自有机房硬件前提下,自托管长期综合成本低于线上API;日均请求低于1000次,直接选用托管API更划算,硬件投入完全不经济;1000至3000次可采用混合方案,核心业务自托管,临时轻量任务调用线上服务。 - 成本优化手段
优先选用FP8量化降低显卡需求;全局开启Prefix前缀缓存,复用固定系统提示词减少重复算力消耗;个人调试使用Mac轻量量化方案,避免租赁昂贵GPU;生产区分任务长短,短对话用vLLM,长智能任务切换SGLang,提升单卡吞吐。
四、GLM 5.2后端搭配Hermes/OpenClaw选型方案
两款主流AI智能体对推理框架适配需求不同,可结合GLM 5.2特性选择后端:
- Hermes Agent:主打自主学习、多步骤行业研究、定时网页监控、长篇行业报告,单次任务上下文可达数十万Token,优先部署SGLang作为GLM 5.2推理后端,RadixAttention大幅提升长文档处理吞吐,任务拆解、多轮迭代稳定性更强。
- OpenClaw Agent:侧重国内办公IM对接、即时消息应答、简短代码辅助、多子Agent并行轻量任务,对话长度较短,vLLM完全满足需求,部署更轻量化,搭配阿里云轻量应用服务器一键镜像可快速上线。
两款智能体接入GLM 5.2统一方式:在Agent配置文件填写推理服务IP与端口,同步阿里云百炼Token Plan专属API逻辑,Credits统一计量所有模型消耗,团队可管控整体AI调用预算。Token Plan分为标准、高级、尊享三档坐席,按月度Credits额度计费,额度耗尽自动暂停服务,不会产生超额账单,兼容GLM、Qwen、DeepSeek等全部主流模型。
五、自托管常见故障与解决办法
- 显存溢出OOM:下调max-model-len参数、降低GPU内存利用率阈值,更换Q4/K_M更低量化版本;多卡场景检查张量并行参数与显卡数量匹配。
- 模型加载失败:核对CUDA驱动版本不低于12.1,vLLM、SGLang版本与GLM 5.2适配,重新完整拉取权重文件,避免分片损坏。
- 推理速度缓慢:生产环境使用8卡Hopper架构GPU,开启前缀缓存与推测解码;长任务切换SGLang,避免大量长请求占用单卡资源。
- 成本持续超预期:区分任务分流,简单交互使用轻量化模型,长智能任务单独调度;通过缓存机制减少重复Token消耗,依托Token Plan管控团队整体调用额度。
六、总结
GLM 5.2依托百万上下文与开源许可,是企业私有化AI智能体核心推理底座,落地核心在于量化版本匹配硬件、按业务长短选择vLLM或SGLang推理框架。通用线上对话、轻量多Agent并行推荐vLLM;Hermes长时序研究、文档自动化任务优先SGLang。企业日均高并发场景自托管具备成本优势,少量使用直接选择百炼Token Plan线上模型服务,兼顾成本与运维便捷性。部署过程重点做好显存优化、缓存开启、硬件规格匹配,可有效规避OOM、推理卡顿等常见问题,搭配OpenClaw、Hermes智能体可搭建完整私有化AI自动化工作流。
