
GLM 5.2作为开源大模型领域的标杆产品,凭借753B参数、MoE架构与100万上下文能力,在代码、推理、长文本处理等场景表现突出,成为企业自托管的热门选择。自托管可实现数据完全可控、定制化部署与长期成本优化,但需解决硬件选型、推理框架适配、部署流程与成本核算四大核心问题。本文从硬件配置、vLLM/SGLang部署、性能优化、成本测算四大维度,提供从零基础到企业级的全流程实战指南,帮助用户高效落地并实现成本盈亏平衡。
一、GLM 5.2核心特性与自托管价值
1. 模型核心特性
GLM 5.2采用MoE混合专家架构,256个专家每次仅激活8个,在保持高性能的同时降低推理算力需求。核心能力包括:
- 超长上下文:原生支持100万Token上下文,可处理百万字级文档,长文本处理能力领先同类模型。
- 高性能推理:在Terminal-Bench、SWE-bench等专业评测中登顶开源模型榜首,代码能力追平闭源模型。
- 灵活量化:支持BF16、FP8、4-bit、2-bit等多档量化,适配不同硬件与场景需求。
- 开源开放:采用MIT开源协议,无使用限制,支持私有化部署与二次开发。
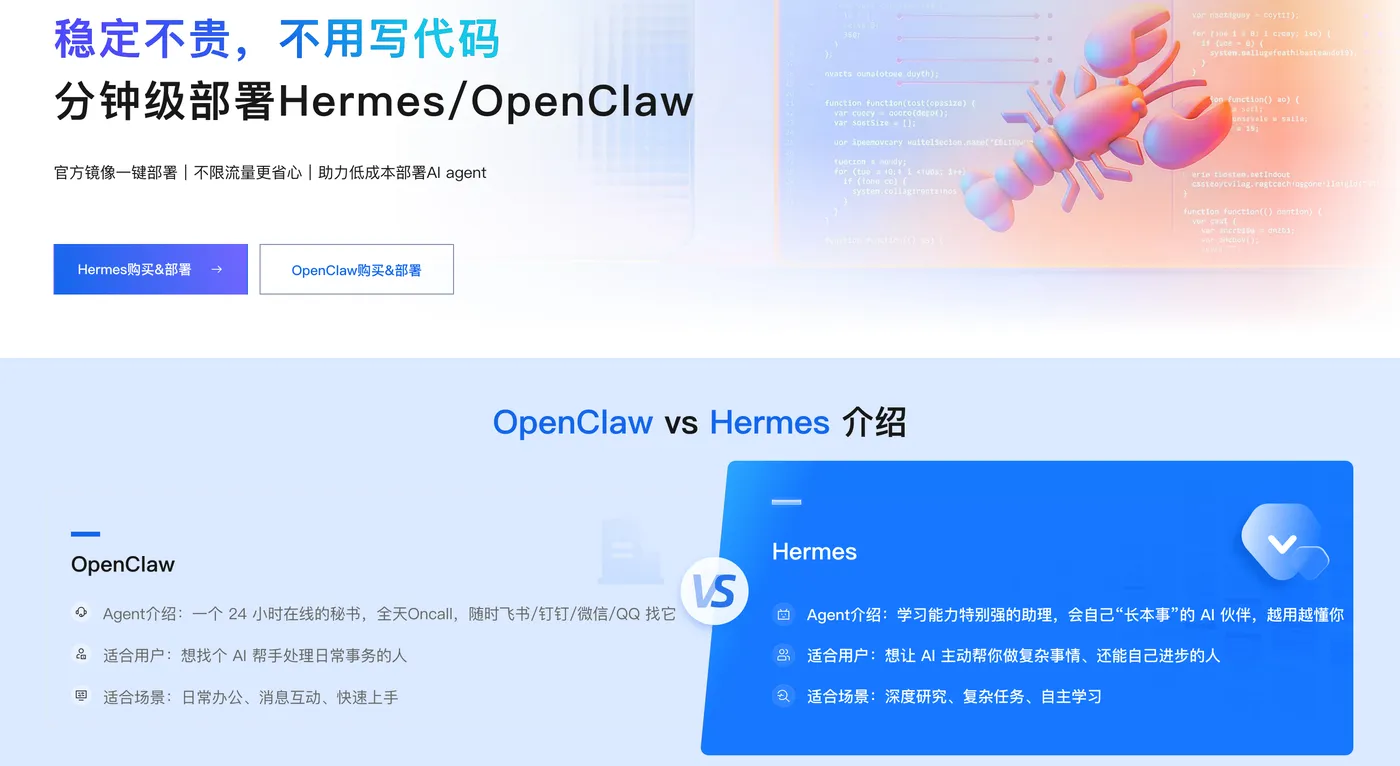
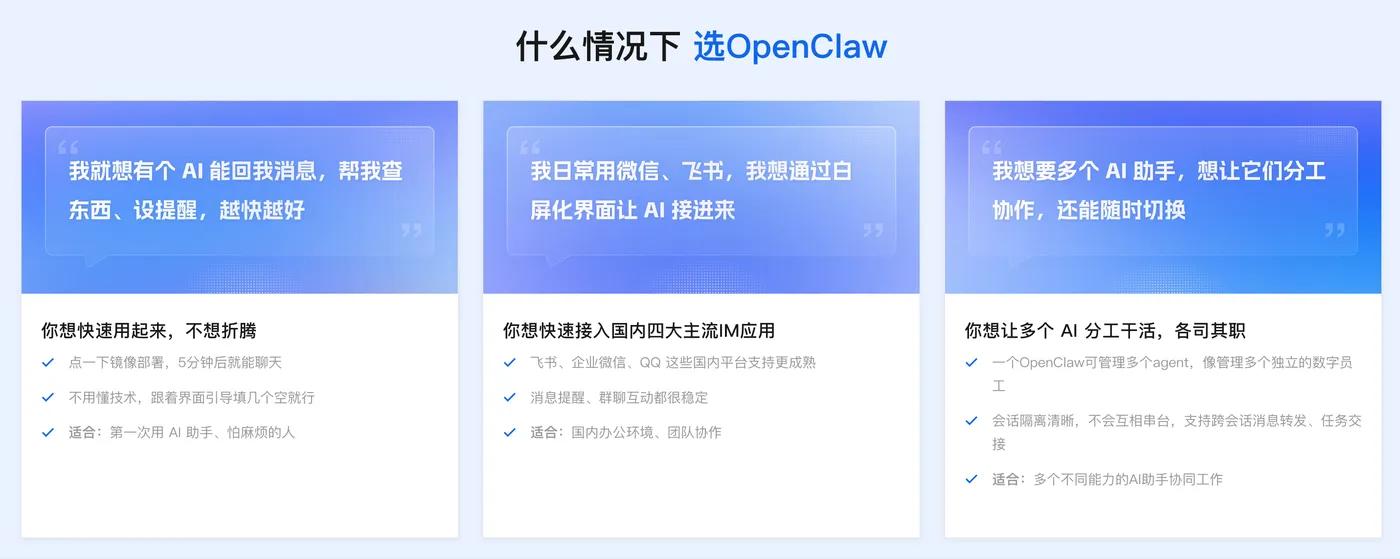
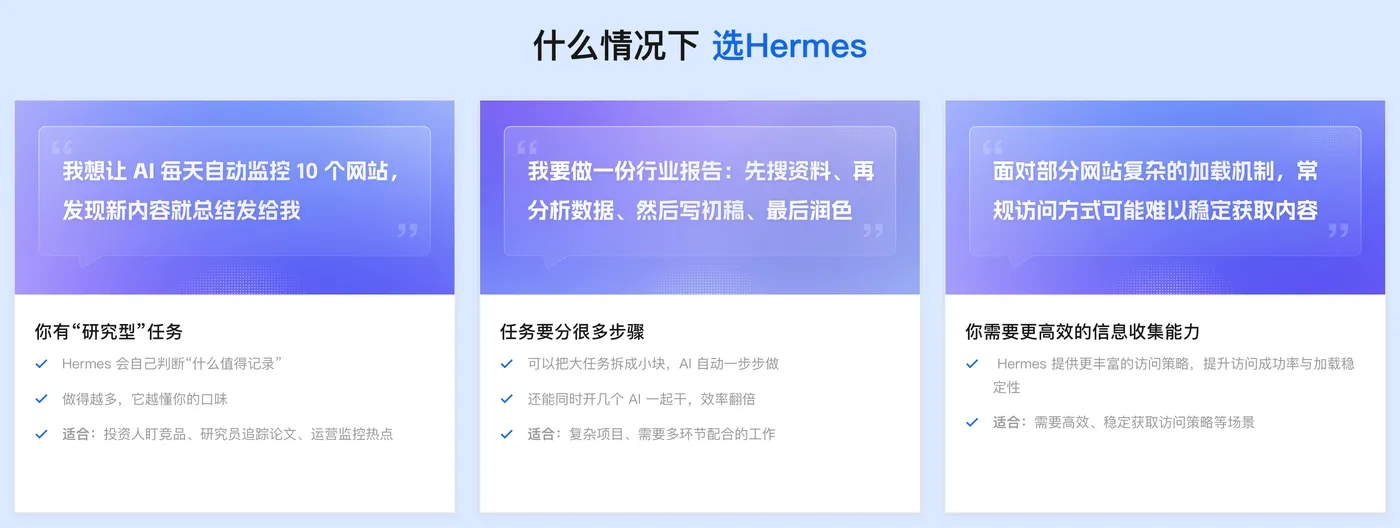
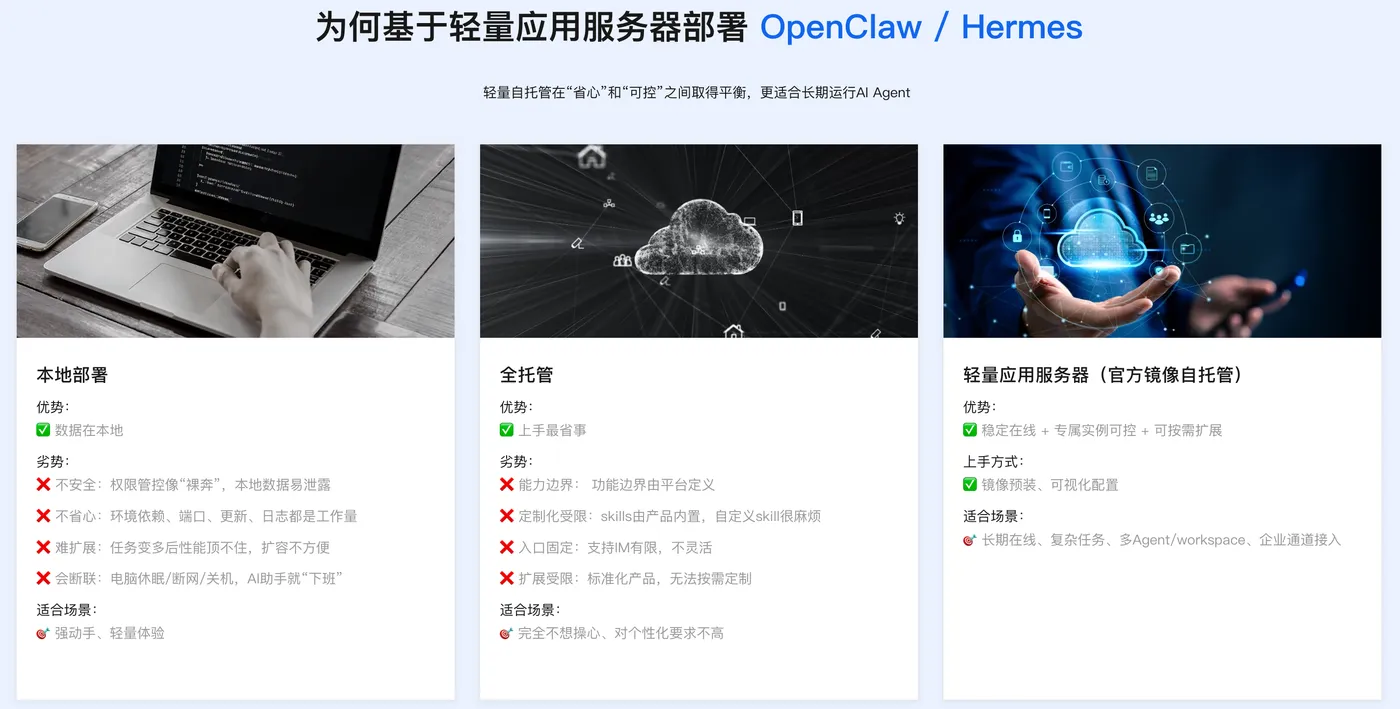
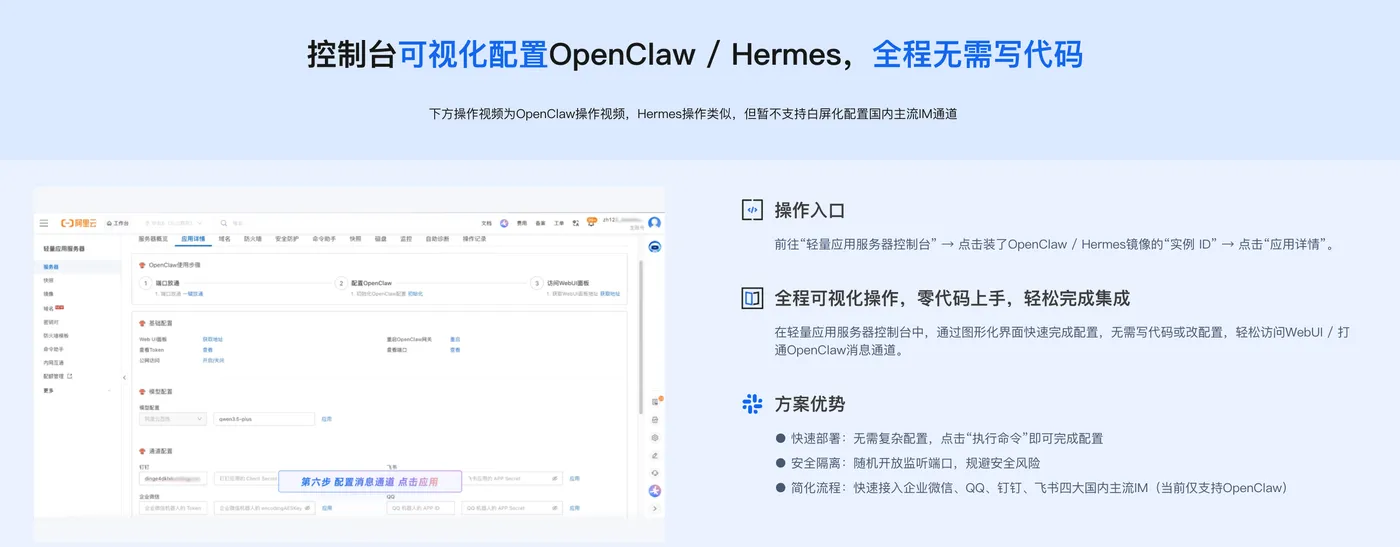
- 阿里云部署AI Agent:OpenClaw/Hermes Agent全网最简单,只需两步,详情👉访问阿里云OpenClaw/Hermes一键部署专题页面了解。
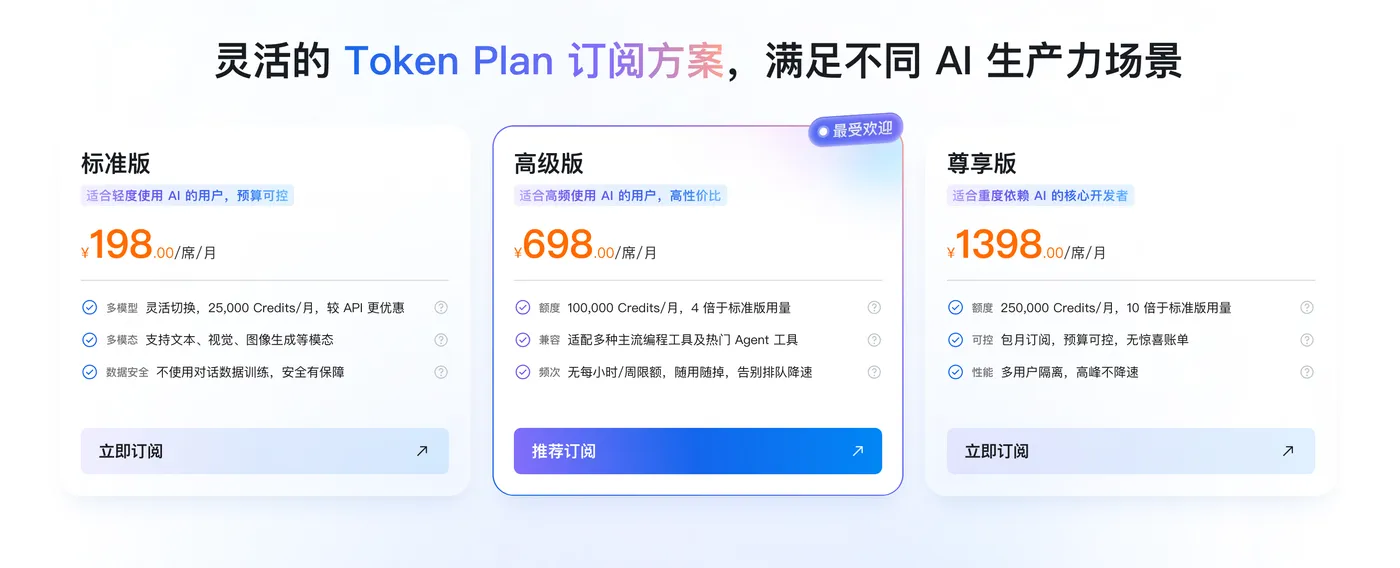
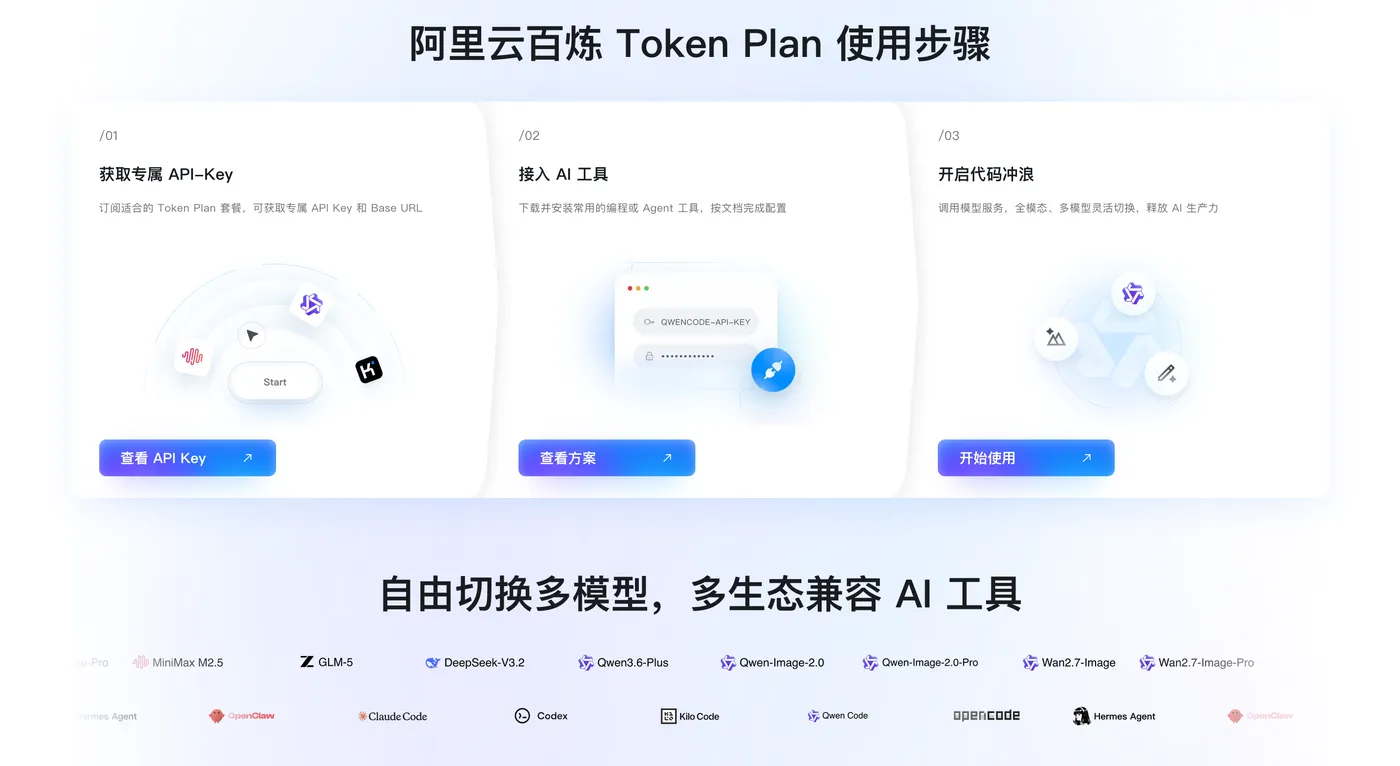
Token Plan Token最便宜/支持多模型切换:👉访问订阅阿里云百炼Token Plan AI大模型服务 。支持多模型切换,用于多模态模型灵活调用,实现多模型、多工具、多场景下的额度共享与统一管理,兼顾灵活性、稳定性与安全性,大幅降低企业使用大模型的门槛与成本。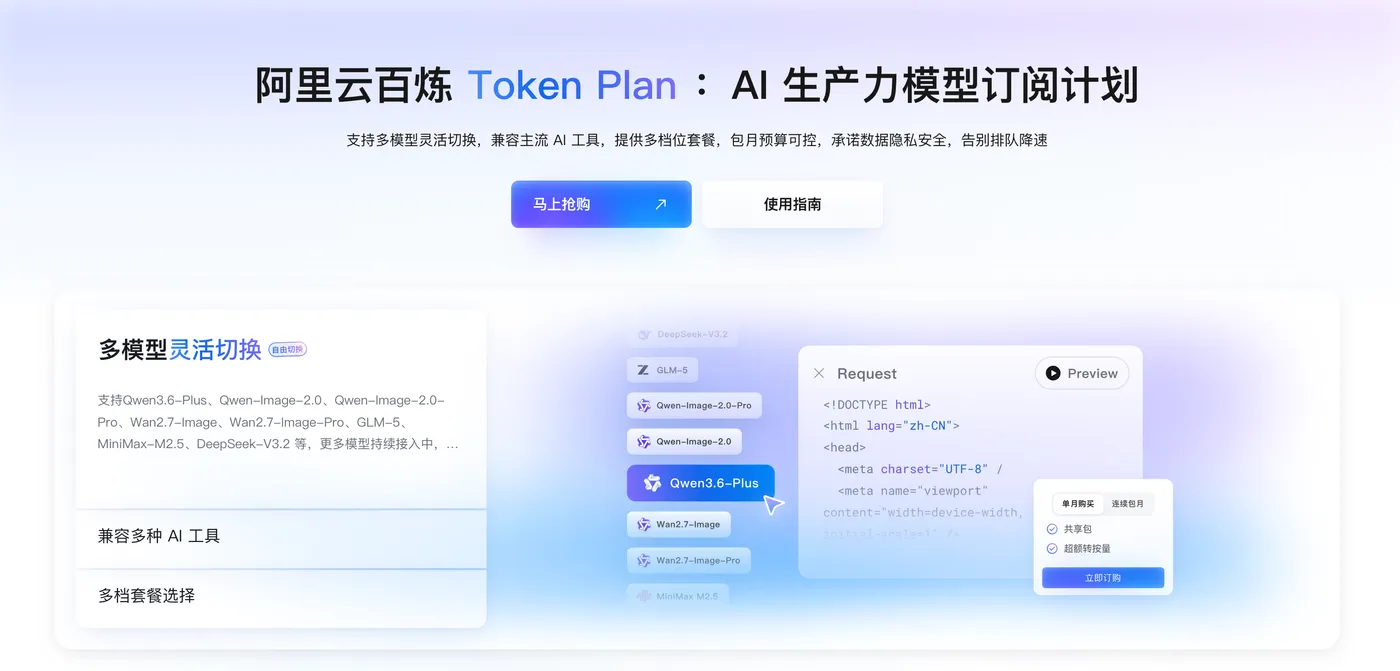
2. 自托管核心价值
- 数据安全:模型与数据完全存储在本地/私有云,满足金融、政务、医疗等行业合规要求。
- 成本可控:长期高频使用场景下,自托管成本显著低于API调用,可通过硬件复用、量化优化进一步降低成本。
- 定制化能力:支持模型微调、知识库接入、推理参数定制,适配企业专属业务场景。
- 性能可控:可根据业务需求调整硬件配置与推理参数,实现延迟与吞吐量的最优平衡。
二、硬件选型:从消费级到企业级全方案
GLM 5.2的硬件需求核心取决于量化精度,不同量化方案对应不同硬件配置,需根据业务场景、预算与性能要求选择。
1. 量化方案与硬件需求对比
| 量化方案 | 模型大小 | 最小硬件配置 | 推荐硬件 | 生成速度 | 适用场景 |
|---|---|---|---|---|---|
| BF16(全精度) | 1.51TB | 8×H200(141GB) | 8×H200+NVLink | ~300tok/s | 企业级高精度推理、长文本处理 |
| FP8(官方推荐) | 750GB | 8×H200/8×H100 | 8×H200 | ~250tok/s | 生产环境标准部署、平衡性能与成本 |
| 4-bit(Q4_K_M) | 376GB | 4×H100(80GB) | 4×H200 | ~80tok/s | 中小企业、成本敏感场景 |
| 2-bit(UD-IQ2_XXS) | 241GB | Mac Studio 256GB/高内存服务器 | 256GB统一内存设备 | 3-9tok/s | 个人测试、低性能需求场景 |
2. 硬件选型核心原则
- 企业生产环境:优先选择FP8量化+8×H200配置,搭配NVLink提升多卡通信效率,确保100万上下文稳定运行。
- 中小企业:选择4-bit量化+4×H100配置,在成本与性能间取得平衡,满足日常业务需求。
- 个人/测试场景:选择2-bit量化+256GB内存Mac或高内存服务器,实现低成本体验。
- 关键硬件要求:
- 显存:多卡部署需满足总显存≥模型大小,FP8需≥750GB,4-bit需≥376GB。
- 通信:企业级部署需NVLink/NVSwitch,提升多卡并行效率,避免通信瓶颈。
- 内存:服务器内存≥模型大小的1.5倍,确保模型加载与推理稳定。
- 存储:配备高速NVMe SSD,模型加载速度提升50%以上。
三、vLLM与SGLang部署:两大推理框架实战
vLLM与SGLang是当前GLM 5.2自托管的主流推理框架,各有优势,需根据业务场景选择。
1. 框架核心对比
- vLLM:采用Paged Attention技术,显存利用率高达90%以上,支持多卡并行,兼容性强,适合通用推理场景。
- SGLang:基于Redux Attention前缀缓存技术,多轮对话与长文本场景吞吐量可达vLLM的2-5倍,支持结构化输出,适合复杂Agent与长文本处理。
2. vLLM部署全流程(FP8量化,8×H200)
环境准备
- 安装依赖:
pip install vllm transformers accelerate - 下载模型:
git clone https://huggingface.co/zai-org/GLM-5.2-FP8
启动服务
vllm serve zai-org/GLM-5.2-FP8 \
--tensor-parallel-size 8 \
--max-model-len 1000000 \
--gpu-memory-utilization 0.92 \
--dtype fp8 \
--host 0.0.0.0 \
--port 8000
参数说明
--tensor-parallel-size 8:启用8卡张量并行--max-model-len 1000000:支持100万上下文--gpu-memory-utilization 0.92:显存利用率92%,平衡稳定性与性能--dtype fp8:指定FP8量化精度
3. SGLang部署全流程(FP8量化,8×H200)
环境准备
- 安装SGLang:
pip install sglang - 下载模型(同vLLM)
启动服务
python -m sglang.launch_server \
--model-path zai-org/GLM-5.2-FP8 \
--tp 8 \
--context-length 1000000 \
--host 0.0.0.0 \
--port 8000
优势配置
- 开启前缀缓存:
--enable-prefix-cache,多轮对话场景吞吐量提升2-5倍。 - 结构化输出:
--structured-output,支持JSON、SQL等格式输出,适合Agent场景。
4. 部署验证与性能测试
- 测试接口:
curl http://localhost:8000/v1/chat/completions \ -H "Content-Type: application/json" \ -d '{ "model": "GLM-5.2-FP8", "messages": [{"role": "user", "content": "介绍GLM 5.2模型"}] }' - 性能指标:
- TTFT:首token延迟,vLLM约600ms,SGLang约500ms
- TPOT:每token生成时间,vLLM约3.3ms,SGLang约2.5ms
- 吞吐量:vLLM约250tok/s,SGLang约300tok/s(长文本场景)
四、性能优化:提升推理效率与稳定性
1. 显存优化
- 开启
--gpu-memory-utilization 0.92,最大化显存利用率。 - 采用FP8/4-bit量化,减少显存占用50%以上。
- 开启上下文缓存,重复内容复用减少输入Token消耗30%。
2. 多卡优化
- 配置NVLink/NVSwitch,多卡通信效率提升10倍以上。
- 调整
--tensor-parallel-size,根据硬件配置选择4/8卡并行。 - 启用NCCL优化,设置
NCCL_IB_DISABLE=0提升通信速度。
3. 推理参数优化
- 调整
--max-batch-size,根据硬件性能设置合理批处理大小。 - 开启
--enable-chunked-prefill,长文本预填充优化,提升处理速度。 - SGLang开启
--enable-prefix-cache,多轮对话场景性能翻倍。
五、成本盈亏测算:自托管vs API调用
1. 自托管成本构成
- 硬件成本:8×H200约200万元,按4年摊销,每月约4.17万元。
- 电力成本:8×H200满载功耗约8000W,24/7运行每月电费约2880元(按1元/度)。
- 运维成本:服务器托管、网络、人工等,每月约5000元。
- 总成本:每月约4.96万元(24/7运行)。
2. API调用成本对比
- GLM 5.2 API价格:输入0.002元/千Token,输出0.008元/千Token。
- 假设每月调用1亿Token(输入6000万,输出4000万),API成本=6000万×0.002+4000万×0.008=44万元。
3. 盈亏平衡点
- 自托管每月成本约4.96万元,API调用达到4.96万元时,月调用量约1127万Token(输入676万,输出451万)。
- 结论:月调用量超过1127万Token时,自托管更划算;低于该值,API调用更经济。
4. 成本优化策略
- 分时部署:仅业务高峰运行,非高峰关闭,成本降低60%以上。
- 量化降级:非核心场景使用4-bit量化,硬件成本降低50%。
- 硬件复用:同一服务器部署多个模型,提升硬件利用率。
- 批量处理:使用Batch调用,享受半价优惠,降低Token消耗。
六、常见问题与避坑指南
1. 硬件相关问题
- 显存不足:检查量化方案,FP8需8×H200,4-bit需4×H100,避免硬上全精度。
- 多卡通信异常:确保NVLink驱动与CUDA版本匹配,启用NCCL优化。
- 模型加载失败:检查磁盘空间,FP8需≥750GB,使用高速NVMe SSD。
2. 部署框架问题
- vLLM报错:更新vLLM至最新版本,确保CUDA版本≥12.0。
- SGLang性能不佳:开启前缀缓存,调整批处理大小,适配长文本场景。
- API调用超时:增加服务器资源,调整
--max-batch-size,优化推理参数。
3. 成本控制问题
- 成本超支:设置消费预警,监控Token消耗,分时部署降低运行成本。
- 性能与成本失衡:根据业务场景选择量化方案与硬件配置,避免资源浪费。
七、总结
GLM 5.2自托管是企业实现AI能力自主可控的最优选择,通过合理的硬件选型、vLLM/SGLang框架部署与性能优化,可实现高性能、低成本的推理服务。从消费级2-bit量化到企业级FP8全量部署,覆盖不同场景需求;通过成本测算明确盈亏平衡点,帮助企业制定最优部署策略。自托管不仅满足数据安全与合规要求,更能在长期高频使用场景下显著降低成本,成为企业AI基础设施建设的核心方向。
