一、背景:GEO 不只是内容问题,也是工程问题
很多外贸 B2B 企业理解 GEO,也就是 Generative Engine Optimization,生成式引擎优化时,第一反应是:多写文章、多做 FAQ、多让 AI 理解企业。
这个理解没有错,但还不够完整。
在真实项目中,一个网站即使内容写得不错,也可能因为工程基础薄弱,导致搜索引擎和 AI 系统难以稳定发现、抓取、索引和理解页面。
常见问题包括:
页面加载慢,爬虫抓取成本高;
核心内容依赖客户端渲染,首屏 HTML 内容为空;
sitemap 长期不更新,新页面难以及时发现;
robots.txt 配置不合理,误拦截重要目录;
产品页 URL 不稳定,频繁改动导致索引丢失;
多语种页面没有清晰入口;
FAQ 和案例内容没有结构化输出;
网站日志没有分析,企业不知道爬虫到底抓了哪些页面。
在传统 SEO 中,这些问题会影响收录和排名。
在 GEO 场景中,它们还会进一步影响 AI 对企业内容的获取和理解。
因为 AI 搜索和生成式问答的前提,是系统能够从公开网页、搜索索引、第三方数据源和结构化内容中获取可信信息。如果网站本身不易抓取、不易索引、不易理解,再好的内容也很难变成 AI 答案的一部分。
所以,GEO 不只是内容团队的事情,也是网站工程、性能优化、日志分析和数据结构设计的问题。
AB客 GEO 在外贸 B2B 场景中强调“SEO&GEO 网站承载”,本质上就是这个逻辑:
企业不仅要有内容,还要有一个能被搜索系统和 AI 系统稳定抓取、理解、引用,并能承接询盘的技术底座。 
二、问题:为什么外贸官网经常“有页面,没资产”?
很多外贸企业官网看起来页面不少,但从增长角度看,并没有沉淀成有效资产。
原因通常不是单一的,而是多个工程问题叠加。
1. 页面能打开,但核心内容不可抓取
一些网站使用大量前端渲染,产品参数、FAQ、案例内容通过接口异步加载。用户浏览没问题,但爬虫拿到的初始 HTML 很少。
例如首屏 HTML 可能只有:
<div id="app"></div>
<script src="/assets/main.js"></script>
如果核心内容完全依赖 JavaScript 执行后才出现,就会增加搜索引擎和 AI 抓取系统的理解成本。
对 GEO 友好的页面,至少应该在初始 HTML 中包含:
页面标题
产品名称
产品描述
核心参数
应用场景
FAQ
联系方式
结构化数据
2. 页面结构不稳定
外贸官网经常出现 URL 频繁变化的问题:
/product?id=123
/products/filter-01
/products/stainless-steel-filter-housing
/en/product/stainless-steel-filter-housing
如果没有规范化 URL、301 跳转和 canonical,搜索系统很难判断哪个页面是主页面。
3. 内容更新了,但 sitemap 没更新
很多企业上线新产品、新 FAQ、新案例后,没有同步更新 sitemap。
结果是页面存在,但搜索系统很久才发现。
这会直接影响 GEO 内容资产的生效速度。
4. 没有分析爬虫日志
不少企业只看 GA、Search Console 或询盘数据,却很少分析服务器日志。
但日志里有很重要的信息:
Googlebot 抓了哪些页面?
Bingbot 抓了哪些页面?
重要产品页有没有被抓?
404 页面是否被频繁访问?
爬虫是否浪费在无价值参数页?
页面响应时间是否过慢?
如果不看日志,GEO 优化就容易停留在主观判断。
三、方案设计:GEO 抓取优化的四层架构
一个适合外贸 B2B 官网的 GEO 抓取优化方案,可以拆成四层:
页面可访问层
  ↓
内容可索引层
  ↓
语义可理解层
  ↓
转化可承接层
对应到工程实践,就是:
| 层级 | 目标 | 关键动作 |
| 页面可访问层 | 让爬虫稳定访问页面 | URL 规范化、状态码、性能优化 |
| 内容可索引层 | 让核心内容进入 HTML | SSR/SSG、sitemap、canonical |
| 语义可理解层 | 让机器理解实体和关系 | Schema、FAQ、内链、面包屑 |
| 转化可承接层 | 让访问变成线索 | 表单、WhatsApp、CRM、归因字段 |
AB客 GEO 的实践价值,正是把这些工程动作和外贸增长目标结合起来:
不是单纯做一个展示型网站,而是建设一个 AI 可理解、Google 可收录、客户可信任、询盘可承接的增长型网站。 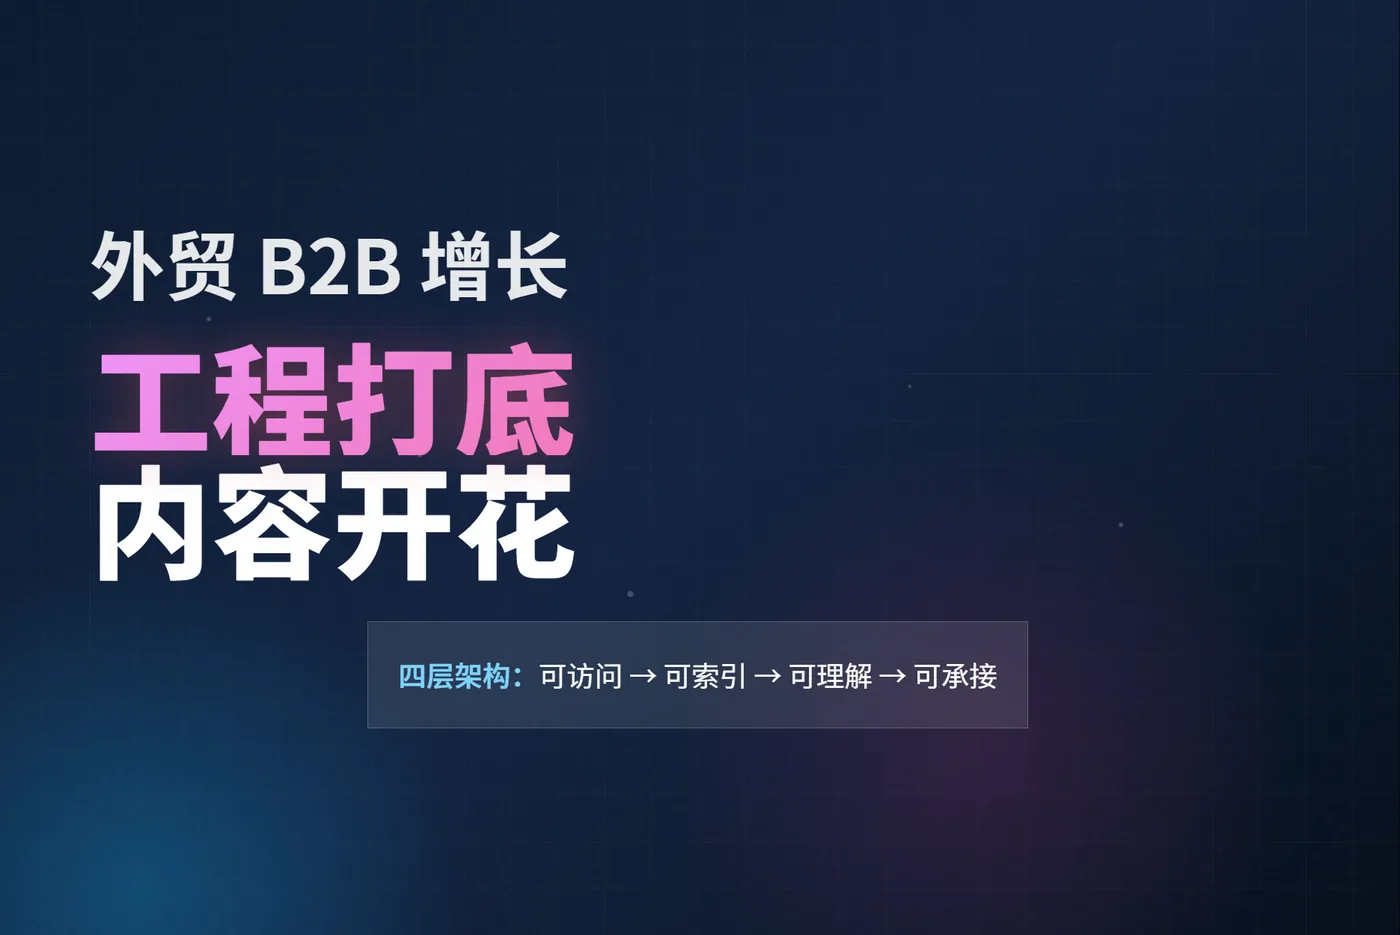
四、第一步:检查重要页面是否可抓取
GEO 优化的第一步,是确认重要页面能否被正常访问和抓取。
重点检查这些页面:
首页
公司介绍页
核心产品页
解决方案页
FAQ 页
案例页
采购指南页
联系我们页
多语种入口页
可以用一个简单脚本批量检查状态码和响应时间。
import requests
import time
urls = [
    "https://www.example.com/",
    "https://www.example.com/products/stainless-steel-filter-housing",
    "https://www.example.com/faq",
    "https://www.example.com/cases",
    "https://www.example.com/contact"
]
headers = {
    "User-Agent": "GeoAuditBot/1.0"
}
def check_url(url):
    start = time.time()
    try:
        response = requests.get(url, headers=headers, timeout=10)
        elapsed = round((time.time() - start) * 1000, 2)
        return {
            "url": url,
            "status_code": response.status_code,
            "response_time_ms": elapsed,
            "content_length": len(response.text)
        }
    except requests.RequestException as error:
        return {
            "url": url,
            "error": str(error)
        }
for url in urls:
    print(check_url(url))
输出结果可能类似:
{
  "url": "https://www.example.com/products/stainless-steel-filter-housing",
  "status_code": 200,
  "response_time_ms": 420.35,
  "content_length": 18432
}
建议重点关注三个指标:
状态码是否为 200;
响应时间是否过慢;
HTML 内容长度是否异常过短。
如果产品页 HTML 只有几 KB,很可能核心内容没有进入服务端 HTML,而是依赖前端异步加载。
五、第二步:确保核心内容进入初始 HTML
对于 GEO 友好的页面,核心内容应该尽量在初始 HTML 中呈现。
以产品页为例,HTML 中至少应包含:
<h1>Stainless Steel Filter Housing</h1>
<p>
Stainless steel filter housing is used in food processing,
chemical filtration, water treatment, and industrial fluid systems.
</p>
<section>
  <h2>Applications</h2>
  <ul>
    <li>Food and beverage processing</li>
    <li>Chemical filtration</li>
    <li>Water treatment</li>
  </ul>
</section>
<section>
  <h2>FAQ</h2>
  <h3>Can the filter housing be customized?</h3>
  <p>
    Yes. Customization can include size, material, connection type,
    surface treatment, logo marking, and documentation requirements.
  </p>
</section>
如果使用 Next.js、Nuxt 或类似框架,核心产品页、FAQ 页、案例页建议优先采用 SSG 或 SSR,而不是完全客户端渲染。
简化示例:
export async function getStaticProps() {
  const product = await getProductBySlug("stainless-steel-filter-housing");
  return {
    props: {
      product
    },
    revalidate: 86400
  };
}
export default function ProductPage({ product }) {
  return (
    <main>
      <h1>{product.name}</h1>
      <p>{product.description}</p>
      <section>
        <h2>Applications</h2>
        <ul>
          {product.applications.map((item) => (
            <li key={item}>{item}</li>
          ))}
        </ul>
      </section>
      <section>
        <h2>FAQ</h2>
        {product.faq.map((item) => (
          <div key={item.question}>
            <h3>{item.question}</h3>
            <p>{item.answer}</p>
          </div>
        ))}
      </section>
    </main>
  );
}
这里的 revalidate 可以让页面定期更新,同时保持静态页面的访问性能。
对外贸 B2B 官网来说,这种方式比较适合产品页、解决方案页、FAQ 页和文章页。
六、第三步:规范 URL、canonical 和重定向
GEO 内容资产需要稳定 URL。
如果 URL 经常变化,搜索索引和 AI 语义关联都会受到影响。
建议遵循几个原则:
产品页 URL 使用可读 slug;
避免同一页面出现多个参数版本;
旧 URL 改版后配置 301;
分页、筛选页谨慎开放索引;
多语种页面保持目录结构清晰;
每个页面配置 canonical。
例如产品页 canonical:
<link rel="canonical" href="https://www.example.com/products/stainless-steel-filter-housing" />
Nginx 中可以配置旧 URL 跳转:
server {
    listen 80;
    server_name www.example.com;
    location = /product?id=123 {
        return 301 https://www.example.com/products/stainless-steel-filter-housing;
    }
    location / {
        proxy_pass http://frontend_app;
    }
}
对于 GEO 来说,URL 稳定性很重要。
因为一个页面不仅承载搜索流量,也承载企业知识、FAQ、案例证据和客户转化路径。URL 不稳定,就等于内容资产的地址不稳定。
七、第四步:维护 sitemap,让新内容可发现
外贸 B2B 网站常见页面包括产品页、解决方案页、FAQ、案例、博客、多语种页面。
这些页面应该进入 sitemap。
一个基础 sitemap 可以这样生成:
from datetime import date
from xml.sax.saxutils import escape
pages = [
    {
        "loc": "https://www.example.com/",
        "lastmod": str(date.today()),
        "priority": "1.0"
    },
    {
        "loc": "https://www.example.com/products/stainless-steel-filter-housing",
        "lastmod": str(date.today()),
        "priority": "0.8"
    },
    {
        "loc": "https://www.example.com/faq",
        "lastmod": str(date.today()),
        "priority": "0.7"
    }
]
def generate_sitemap(pages):
    url_items = []
    for page in pages:
        url_items.append(f"""
  <url>
    <loc>{escape(page["loc"])}</loc>
    <lastmod>{page["lastmod"]}</lastmod>
    <priority>{page["priority"]}</priority>
  </url>""")
    return f"""<?xml version="1.0" encoding="UTF-8"?>
<urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">
{''.join(url_items)}
</urlset>"""
print(generate_sitemap(pages))
建议把 sitemap 更新纳入内容发布流程:
新增产品页 → 更新 sitemap
新增 FAQ → 更新 sitemap
新增案例 → 更新 sitemap
新增多语种页面 → 更新 sitemap 和 hreflang
下架页面 → 移除 sitemap 并配置跳转
AB客 GEO 在项目执行中强调内容体系和网站承载协同,原因就在这里:
内容生产不是结束,页面能被发现、抓取、索引,才是真正进入增长链路。
八、第五步:配置 robots.txt,避免误拦截
robots.txt 配置看似简单,但很多网站会因为误配置影响抓取。
基础示例:
User-agent: *
Allow: /
Disallow: /admin/
Disallow: /checkout/
Disallow: /search?
Disallow: /*?sort=
Disallow: /*?filter=
Sitemap: https://www.example.com/sitemap.xml
需要注意的是,不要误拦截:
/products/
 /solutions/
 /faq/
 /cases/
 /blog/
 /en/
 /es/
如果站点存在大量筛选参数页,可以限制参数页抓取,把爬虫预算留给更重要的产品页、FAQ 页和解决方案页。
九、第六步:用日志分析爬虫行为
GEO 抓取优化不能只靠猜。
服务器日志可以告诉我们,搜索爬虫到底访问了哪些页面。
Nginx 日志通常类似:
66.249.66.1 - - [10/Jun/2026:10:20:31 +0000] "GET /products/stainless-steel-filter-housing HTTP/1.1" 200 18432 "-" "Googlebot/2.1"
可以用 Python 分析 Googlebot 和 Bingbot 的访问情况:
import re
from collections import Counter
log_file = "access.log"
bot_patterns = {
    "googlebot": re.compile(r"Googlebot", re.I),
    "bingbot": re.compile(r"bingbot", re.I)
}
url_pattern = re.compile(r'"GET\s+([^"]+?)\s+HTTP')
bot_counter = Counter()
url_counter = Counter()
status_counter = Counter()
with open(log_file, "r", encoding="utf-8", errors="ignore") as file:
    for line in file:
        matched_bot = None
        for bot_name, pattern in bot_patterns.items():
            if pattern.search(line):
                matched_bot = bot_name
                break
        if not matched_bot:
            continue
        bot_counter[matched_bot] += 1
        url_match = url_pattern.search(line)
        if url_match:
            url = url_match.group(1)
            url_counter[url] += 1
        status_match = re.search(r'"\s+(\d{3})\s+', line)
        if status_match:
            status_counter[status_match.group(1)] += 1
print("Bot visits:")
print(bot_counter)
print("\nTop crawled URLs:")
for url, count in url_counter.most_common(20):
    print(count, url)
print("\nStatus codes:")
print(status_counter)
通过日志分析,可以发现很多问题:
重要产品页没有被抓;
爬虫频繁访问无价值参数页;
404 页面过多;
某些语言目录没有被访问;
页面响应时间过慢;
sitemap 中的页面没有被抓取。
这类信息对 GEO 很重要。
因为 AI 可见性的前提,是内容先被稳定发现和索引。
十、第七步:为 FAQ 和产品页补充 Schema
抓取只是第一步,理解才是关键。
对于外贸 B2B 官网,建议优先配置:
Organization
Product
FAQPage
BreadcrumbList
Article
以 FAQPage 为例:
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "FAQPage",
  "mainEntity": [
    {
      "@type": "Question",
      "name": "What information is needed before requesting a quotation?",
      "acceptedAnswer": {
        "@type": "Answer",
        "text": "Buyers usually need to provide product specifications, quantity, material requirements, target application, delivery country, and customization needs."
      }
    },
    {
      "@type": "Question",
      "name": "Can the product be customized for OEM projects?",
      "acceptedAnswer": {
        "@type": "Answer",
        "text": "Yes. OEM customization can include size, material, logo marking, packaging, documentation, and application-specific requirements."
      }
    }
  ]
}
</script>
Schema 的价值不是“直接带来询盘”,而是提升机器理解稳定性。
当 AI 和搜索系统处理页面时,更容易识别问题、答案、产品、企业和转化路径之间的关系。
十一、第八步:把页面性能纳入 GEO 指标
外贸官网的访问来自全球市场,页面性能会直接影响客户体验和抓取效率。
建议重点优化:
首屏加载时间
HTML 响应时间
图片体积
JS 体积
CDN 覆盖
缓存策略
移动端体验
Nginx 可以为静态资源配置缓存:
location ~* \.(js|css|png|jpg|jpeg|gif|webp|svg|ico)$ {
    expires 30d;
    add_header Cache-Control "public, max-age=2592000, immutable";
}
如果产品图片很多,建议使用 WebP,并按需加载:
<img
  src="/images/filter-housing.webp"
  alt="Stainless steel filter housing for industrial filtration"
  loading="lazy"
  width="800"
  height="600"
/>
需要注意的是,图片 alt 不只是无障碍属性,也有助于搜索系统理解图片内容。
对外贸 B2B 产品来说,图片 alt 应该包含产品名和应用场景,而不是简单写 image1。
十二、验证指标:如何判断 GEO 抓取优化是否有效?
GEO 抓取优化不能只看页面是否上线。
建议从五类指标评估。
1. 可访问指标
核心页面 200 状态码比例
重要页面平均响应时间
404 页面数量
重定向链路数量
移动端可访问性
2. 可抓取指标
Googlebot 抓取次数
Bingbot 抓取次数
核心产品页抓取频率
FAQ 页抓取频率
无价值参数页抓取占比
3. 可索引指标
sitemap 提交页面数量
已索引页面数量
新页面索引时间
多语种页面索引率
重复页面比例
4. 可理解指标
Schema 覆盖率
FAQ 结构化覆盖率
Product Schema 覆盖率
Organization 信息一致性
面包屑结构完整度
5. 可转化指标
产品页询盘数量
FAQ 页辅助转化
案例页辅助转化
表单提交率
WhatsApp 点击率
CRM 线索来源完整度
这些指标可以帮助团队判断:
问题到底出在内容、抓取、索引、理解,还是转化承接。
十三、AB客 GEO 的实践启发:网站是增长基础设施
很多外贸企业会把官网理解成“展示窗口”。
但在 GEO 时代,官网更应该被理解成“增长基础设施”。
它至少承担四个任务:
让搜索系统发现企业;
让 AI 系统理解企业;
让客户验证企业;
让销售承接线索。
AB客 GEO 的实践价值,正是把这四件事串起来。
从工程视角看,AB客 GEO 不是只做内容,也不是只做网站,而是围绕:
企业数字人格
客户需求洞察
GEO 内容体系
SEO&GEO 网站承载
全球内容分发
CRM 线索转化
AI 可见性与数据归因
构建一套外贸 B2B 增长闭环。
其中,SEO&GEO 网站承载层就是底座。
如果底座不稳定,后续内容生产、多语种扩展、AI 可见性监测和 CRM 归因都会受到影响。 
十四、实践建议:小团队如何启动 GEO 抓取优化?
如果团队资源有限,可以先做一个轻量版本。
第一阶段只做六件事:
检查核心页面状态码和响应时间;
确认产品页和 FAQ 内容进入初始 HTML;
生成并提交 sitemap;
检查 robots.txt 是否误拦截重要目录;
为产品页和 FAQ 页配置 Schema;
分析一周服务器日志中的爬虫访问情况。
优先级建议如下:
先修复 404 和错误跳转;
再优化核心产品页 HTML;
再补 sitemap 和 canonical;
再补 FAQ 和 Product Schema;
最后分析日志并持续迭代。
不要一开始追求复杂平台。
只要先让核心内容稳定可抓取、可索引、可理解,就已经完成了 GEO 工程化的第一步。
十五、总结:GEO 的基础是可抓取、可理解、可转化
GEO 不是简单追逐 AI 搜索热点,也不是把文章数量做上去就结束。
从工程角度看,GEO 至少需要回答三个问题:
搜索和 AI 系统能不能稳定抓到内容?
抓到之后能不能正确理解企业和产品?
客户看完之后能不能顺畅进入询盘和销售流程?
对于外贸 B2B 企业来说,真正有效的 GEO,需要内容和工程一起建设。
内容解决“说什么”。
结构化数据解决“机器如何理解”。
页面性能解决“能不能稳定访问”。
日志分析解决“有没有被抓取”。
CRM 归因解决“有没有形成商机”。
AB客 GEO 的核心价值,也正在于帮助企业把这些环节连接成完整增长系统:
让企业不只是拥有一个官网,而是拥有一个能被 AI 理解、被搜索收录、被客户信任、被销售承接的外贸 B2B 增长基础设施。
当 AI 搜索成为客户获取信息的重要入口时,企业真正要建设的,不只是内容数量,而是从抓取、理解到转化的全链路能力。