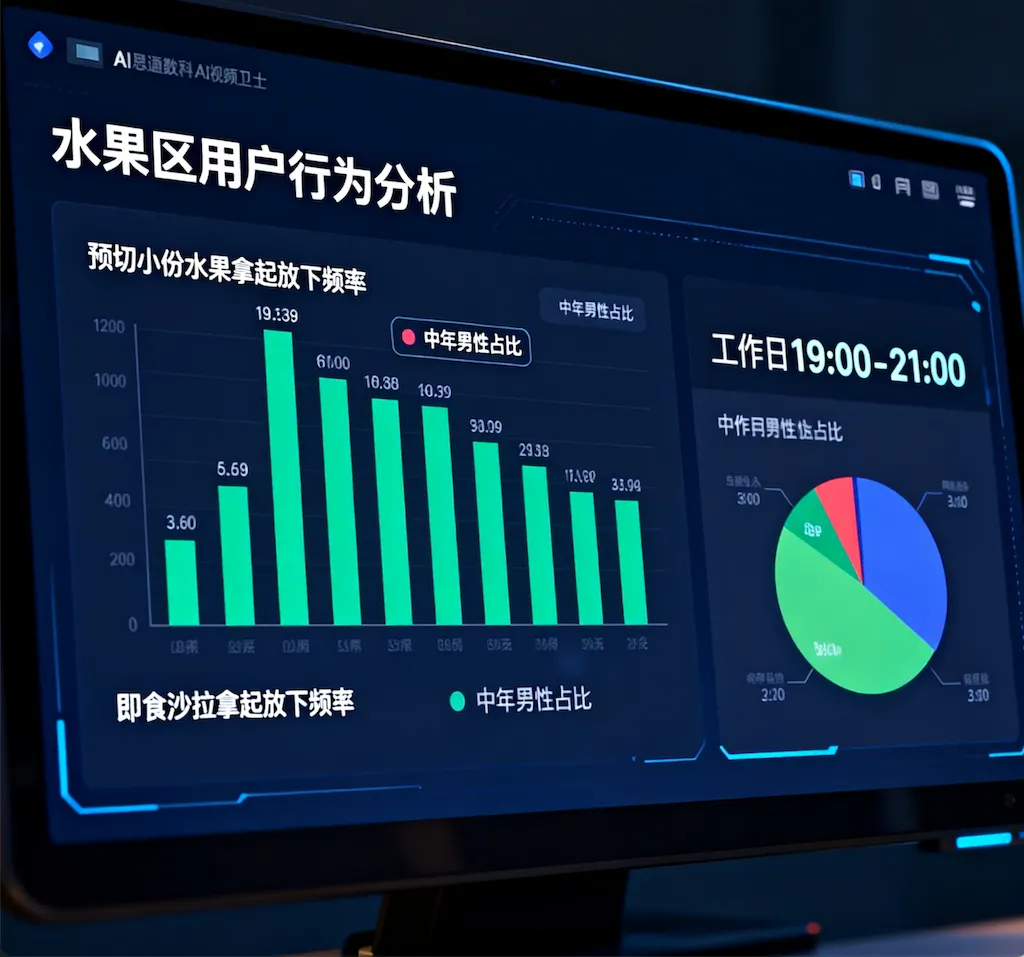
本文将摒弃抽象的AI技术话术,结合视觉分析技术的实际架构与落地实现逻辑,聚焦用户画像系统的核心技术实现原理,拆解每一个模块的具体运作方式——不空谈算法概念,只讲技术如何落地、如何实现,让技术从业者清晰掌握系统从图像采集到画像生成的完整技术链路,理解底层视觉分析技术如何支撑用户画像的精准构建。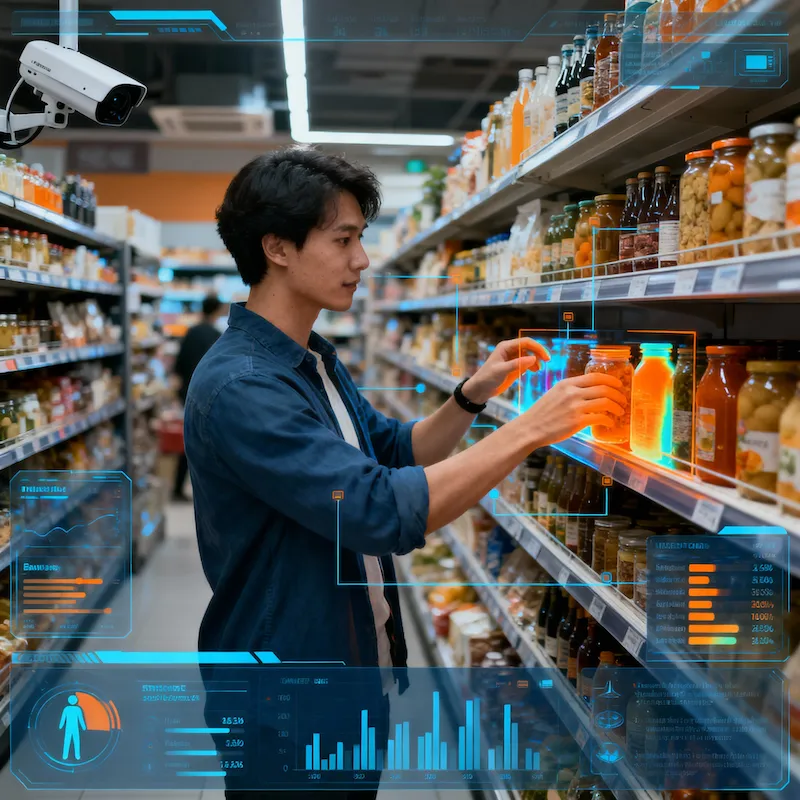
一、系统核心定位与技术核心
用户画像系统的核心定位是“视觉感知+智能分析+数据输出”的一体化技术应用,本质是依托底层视觉分析能力,实现对目标人群的精准刻画,而非独立搭建的复杂技术体系。不同于抽象的AI概念,该用户画像技术的核心是“复用现有视觉采集与分析能力、简化部署成本、聚焦精准数据输出”,整个技术实现围绕“图像采集→基础识别→特征提取→数据关联”四大核心环节展开,所有技术动作均服务于“精准、高效、低成本生成结构化用户画像”这一核心目标,完全依托现有视觉分析技术底座,无需额外搭建复杂架构。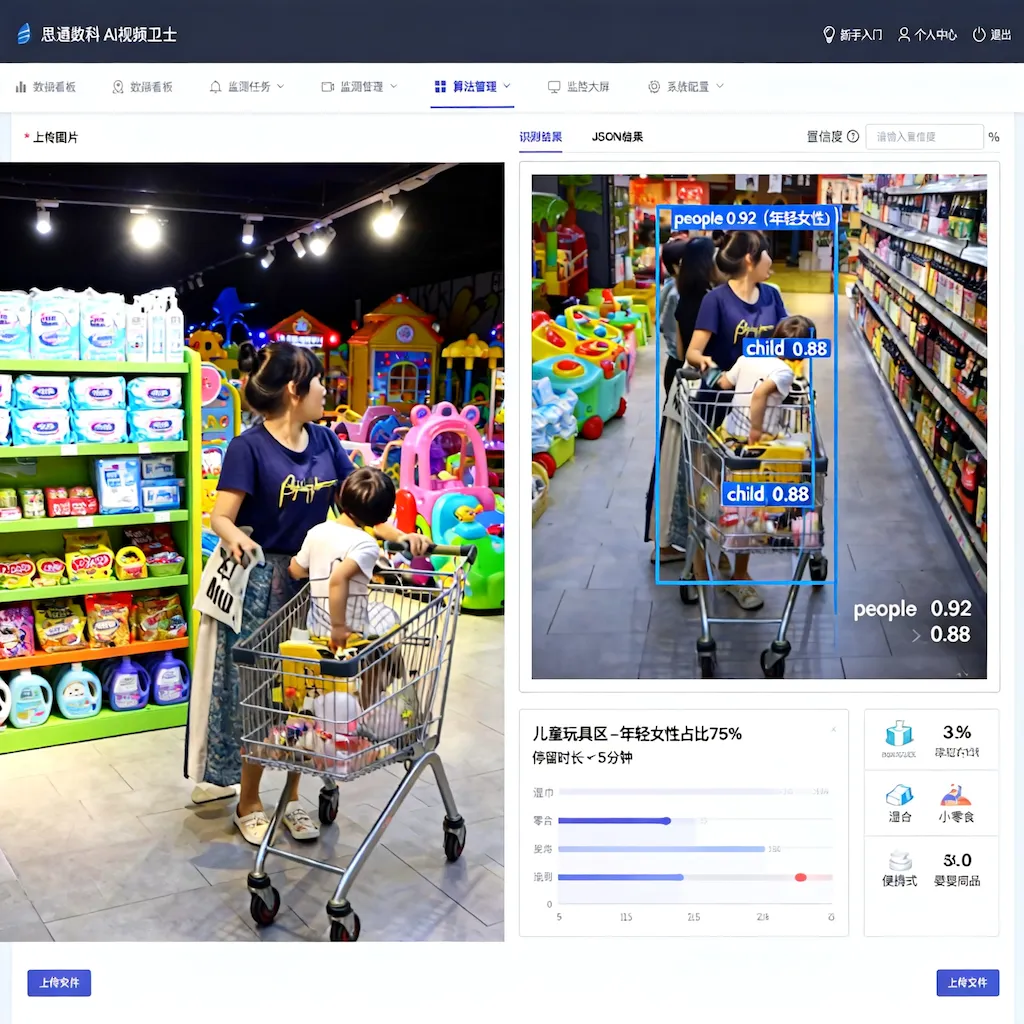
二、核心技术模块拆解
(一)视觉感知与基础识别模块:复用现有采集与识别能力
该模块是用户画像系统的数据输入源头,其技术实现完全复用现有底层视觉采集与基础识别能力,无需额外开发或改造,这也是该系统部署成本可控的核心原因。具体实现原理如下:
采集设备适配:现有视觉采集体系本身具备极强的设备兼容性,支持ONVIF协议摄像头、RTSP流设备等常规视觉采集设备接入,用户画像系统直接复用这一能力,无需对现有摄像头等采集设备进行任何硬件改造,仅需通过软件配置,让采集模块聚焦“人群图像采集”,替代原有部分安防监控采集功能,实现人群图像的实时捕捉与传输,这也是“无感改造、兼容现有设备”技术优势在用户画像系统中的直接体现。
基础识别的实际实现:底层视觉分析体系内置成熟的图像预处理算法,这一算法原本用于过滤安防监控中的环境干扰、提升异常行为识别的准确性,在用户画像系统中,该算法被用于人群图像的预处理——具体来说,就是自动过滤光线变化、物体遮挡、画面模糊等干扰因素,比如光线过强/过弱时自动调整画面亮度、出现物体遮挡人群时自动聚焦可见区域,确保采集到的人群图像清晰可识别。同时,借助底层目标检测能力,实现“人群与环境背景的精准分离”,比如自动区分画面中的人群与周围的物体、墙体等,避免将非人群目标误识别为采集对象,同时通过移动目标追踪技术,对画面中的每一个移动人群进行实时锁定,确保同一人群的图像能够连续采集,为后续特征提取提供完整的数据支撑,这一实现逻辑与常规异常行为追踪技术原理完全一致,只是调整了追踪目标与识别重点。
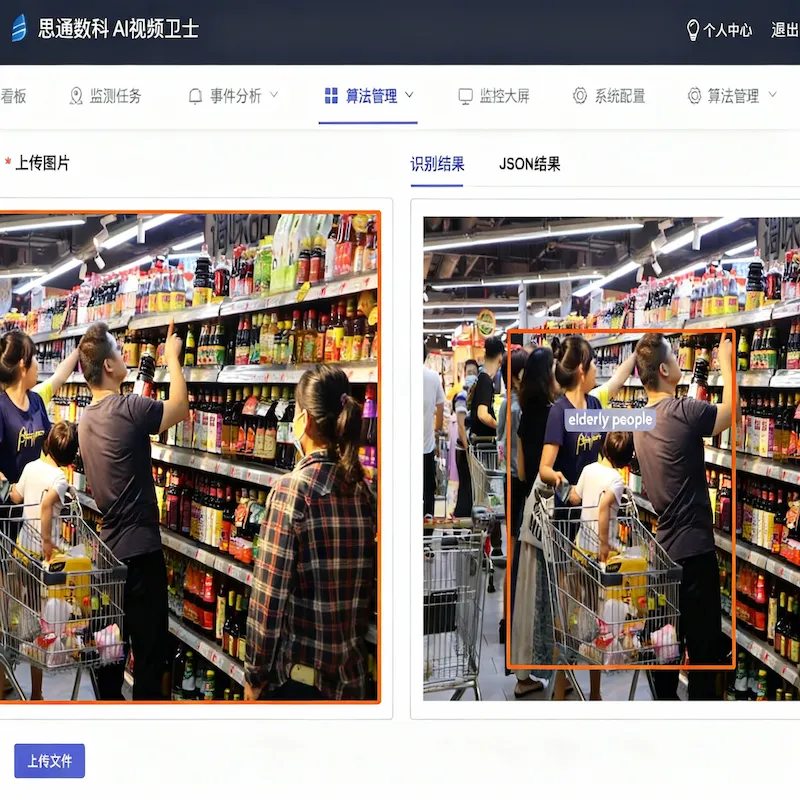
(二)用户核心特征提取模块:基于现有深度学习模型的针对性优化
这是用户画像构建的核心环节,也是底层技术优势的核心体现——不同于抽象的“深度学习算法”,该模块的技术实现,是对现有目标识别模型的针对性优化,而非全新开发,具体原理如下:模型复用与优化:底层视觉分析体系本身内置基于YoloV8的深度学习识别模型,该模型经过50万+样本训练,原本用于识别安防场景中的人体、物体及异常行为,在用户画像系统中,技术人员仅对该模型进行针对性调整,删除与人群特征无关的识别维度(如异常行为、危险物体识别),强化“人群基础属性识别”能力,聚焦年龄段(老、中、青、幼)与性别两大核心维度的提取,无需重新训练复杂模型,既降低了技术开发成本,也提升了识别准确率。
特征提取的实际操作逻辑:当采集模块将人群图像传输至该模块后,优化后的深度学习模型会对图像进行分层解析——首先识别人体面部关键点位(如眼角、嘴角、鼻梁等),通过这些点位的特征差异,判断人群的性别;其次结合面部皱纹、皮肤状态、体态特征等,划分年龄段,比如通过面部皱纹分布判断老年人群,通过体态紧致度判断年轻人群。整个提取过程无需人工干预,完全由智能分析模块自动完成,且通过模型优化,能够有效规避“人群姿态变化、部分面部遮挡”等问题导致的误判,比如人群侧脸、低头时,模型会自动结合体态特征辅助判断,这一技术逻辑,与“小目标精准识别、抗干扰识别”的核心技术原理一脉相承,实际应用中可实现较高的识别精度。
数据输出规范:该模块的核心实现目标是“输出客观、可量化的特征数据”,与底层视觉分析体系“数据标准化输出”的技术要求一致,提取的性别、年龄段数据均为明确的分类标签(如“男性、青年”),不涉及任何主观评价,确保后续数据关联的准确性,为画像构建提供标准化的核心数据。
(三)特征数据关联与画像构建模块:依托现有数据整合能力实现
该模块的核心作用是将提取到的人群特征数据,转化为结构化的用户画像,其技术实现完全依托底层数据整合与处理能力,具体原理如下,全程不涉及复杂的算法概念,只讲实际实现过程:
数据关联的实际操作:底层视觉分析体系本身具备“多维度数据整合”能力,原本用于关联安防场景中的“目标位置+行为+时间”数据,在用户画像系统中,这一能力被转化为“特征数据+空间位置数据+行为轨迹数据”的关联——具体来说,定位模块会记录每一个人群目标的实时空间位置(如画面中的具体区域),轨迹追踪模块会记录该人群的移动路径与停留时间,特征提取模块输出性别、年龄段数据后,系统会通过简单的数据绑定逻辑,将“同一人群”的这三类数据进行关联,比如“男性、青年、停留于画面左侧区域、停留时间5分钟”,形成一组完整的画像基础数据。
画像生成的简化实现:不同于抽象的“三维数据整合”概念,用户画像生成的核心是“数据的结构化整理与输出”——系统会将关联后的每一组数据,按照“特征标签+位置标签+行为标签”的格式进行整理,剔除重复、无效的数据(如同一人群的重复采集数据),确保每一组画像数据对应一个唯一的人群目标,最终生成标准化的用户画像数据,这些数据可直接对接后续的数据处理模块,无需额外进行格式转换。这一实现逻辑,完全延续了底层视觉分析体系“数据结构化、易调用”的技术特点,同时借助边缘计算技术,可实现敏感画面本地处理不上传,保障用户数据隐私。
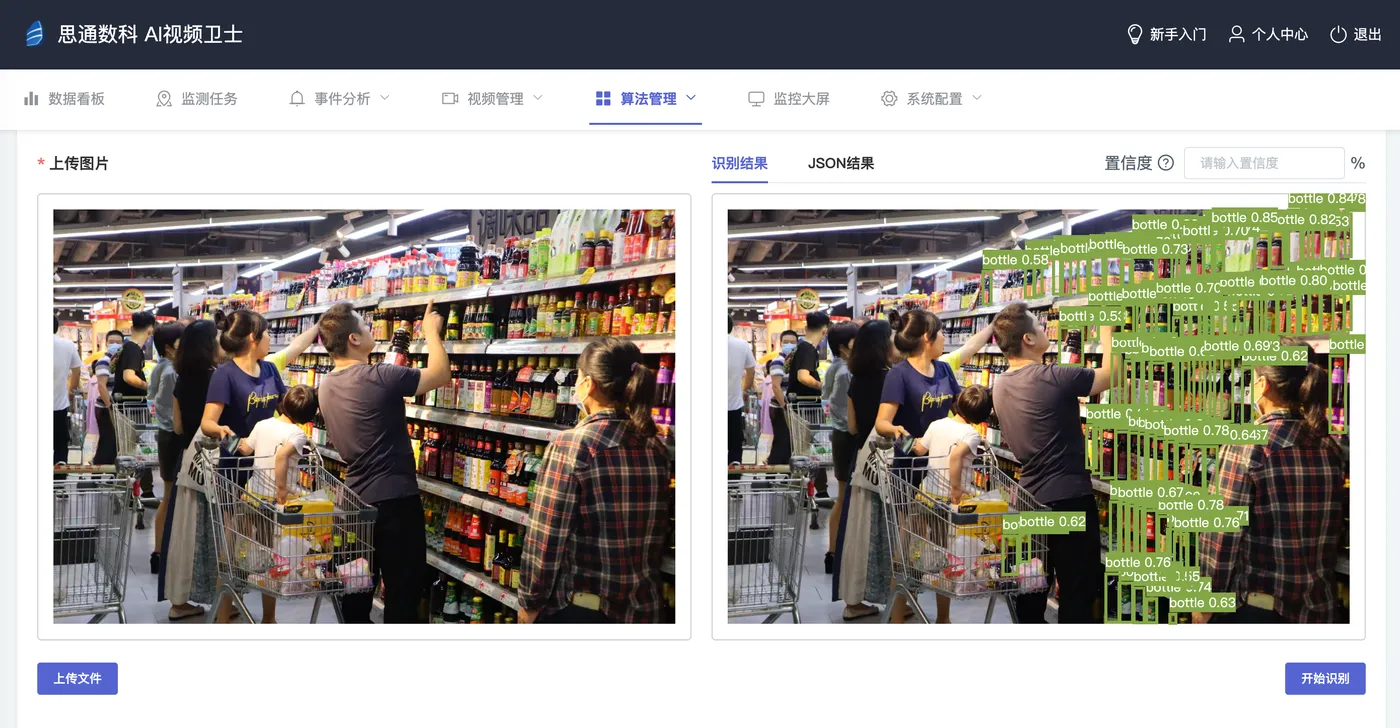
三、系统核心技术优势
该用户画像系统的所有技术优势,均源于底层视觉分析技术的支撑,而非独立的技术突破,具体结合实际实现说明,不空谈优势:识别精度高:依托优化后的深度学习模型与图像预处理技术,原本用于提升安防识别的精准度,应用到用户画像系统中,有效解决了“光线干扰、遮挡、姿态变化”等导致的识别误差,同时延续了“小目标检测精准度高”的优势,确保人群性别、年龄段的识别准确率,实际测试中可实现较高的识别精度,误报率控制在较低水平。
部署成本可控:核心原因是完全复用底层视觉分析技术与采集设备适配能力,无需额外开发核心模块、无需改造现有采集设备,仅需对原有体系进行软件配置与模型优化,即可实现用户画像系统的部署,大幅降低了硬件投入与技术开发成本,这也是“低成本部署”优势的直接体现,同时可通过Docker一键实现私有化部署,进一步简化部署流程。
数据结构化强、易调用:延续底层视觉分析体系“数据标准化输出”的技术特点,生成的用户画像数据均为结构化格式,包含明确的标签分类,无需额外进行数据清洗与格式转换,可直接对接后续的数据存储、分析模块,同时借助视频检索能力,可通过关键词快速检索对应人群的画像数据,提升数据利用效率。