博主前言:很多同学在构建RAG(检索增强生成)系统的时候,最头疼的不是写代码,而是“玄学”调优。模型回答得好不好,全靠感觉?换了个支撑数据库,效果是变好了还是变差了?如果你还在用肉眼观察来评估RAG效果,那这个深度长文绝对是你的“救命稻草”。今天,我们将彻底拆解RAG评估的底层逻辑,并手部分带你用Ragas框架实现定义评估与可视化分析。
一、 引言:为什么你的 RAG 系统需要一把“掐衡”?
在人工智能圈子里有一句名言:“如果你无法简化它,你就无法改进它。”
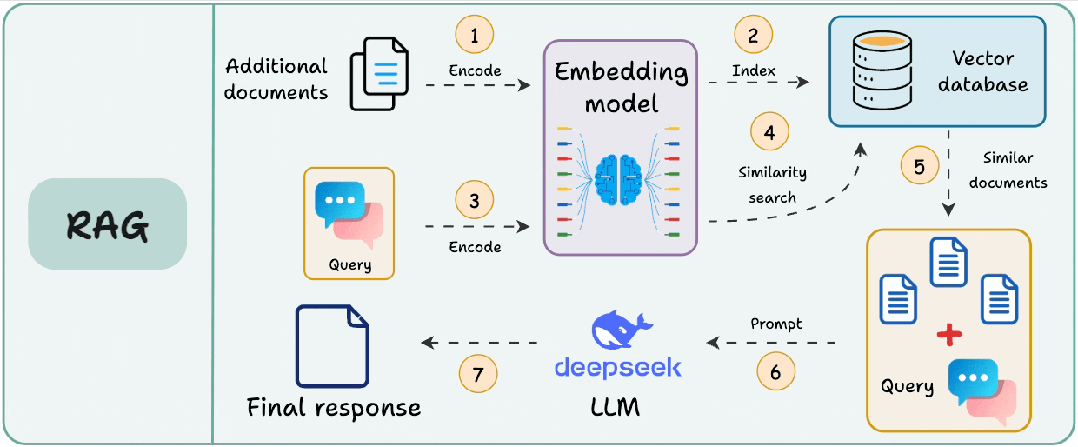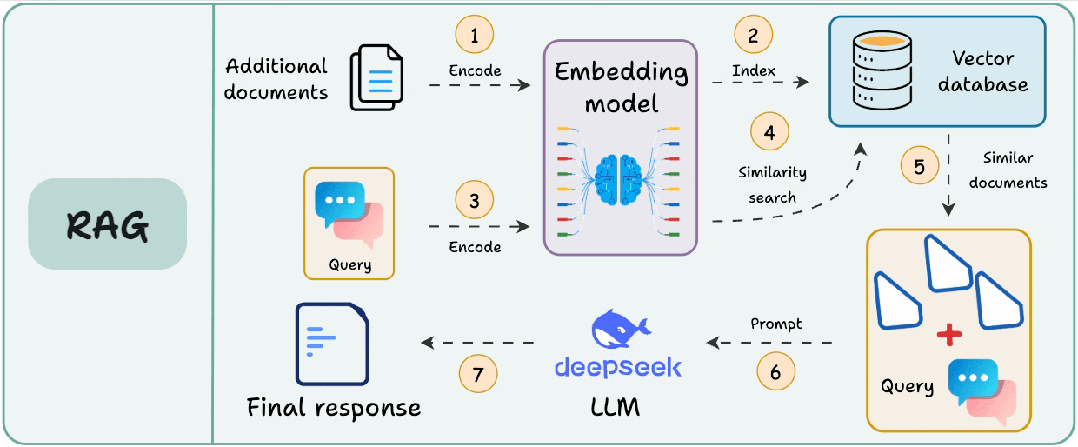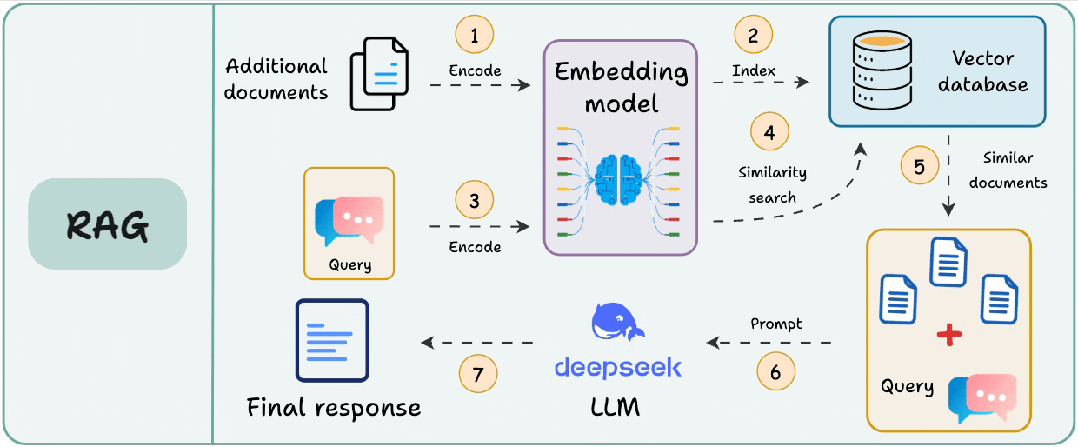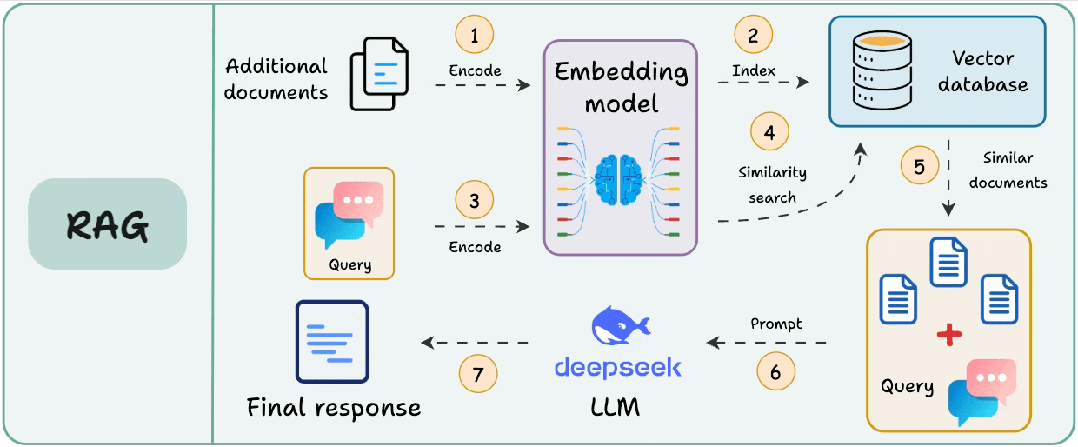
构建一个RAG应用就像教学生考试。检索(Retrieval) 是翻书找资料的过程,生成(Generation) 是总结答案并写在卷子上的过程。如果学生考了零分,是因为书找错了(检索失败)?还是找书对了但总结错了(生成失败)?
这就是概念评估的意义所在:
- 精准定位短板:是嵌入模型(Embedding)不行,还是提示词(Prompt)写得烂?
- 持续监控性能:系统上线后,随着数据更新,搜索质量是否在下降?
- 测量决策依据:选OpenAI还是Claude?选FAISS还是Milvus?数据会告诉你答案。
接下来,我们分散技术原理出发,逐步深入到代码实战。
二、技术原理:深度拆解RAG评估的核心坐标系
评估一个RAG系统,不能只看最终的那句话答案。我们需要一套科学的指标体系,将整个管道拆解开来。
2.1 标准化评估框架:不要重新造轮子
在组件选择阶段,我们可以参考业界公认的基准测试(Benchmarks):
- 嵌入模型基准(MTEB) :这是嵌入模型的“跑分排行榜”。如果你做金融问答,就去搜FiQA数据集下表现最好的模型。
- 搜索算法基准(BEIR) :涵盖了问答、事实实现等多个领域,专门评估系统在“零样本(Zero-shot)”场景下的搜索能力。
- LLM成绩排名(Artificial Analysis) :不仅对比回答质量,还对比推理速度和价格,这对成本控制至关重要。
2.2 什么是“真值数据”(Ground Truth)?
真值(Ground Truth) 就是考试的“标准答案”。它由两部分组成:理想的问题+理想的答案。
- 人工注释:最准,但又贵又慢,且难以规模化。
- 合成真值:利用GPT-4o等更强的大模型,根据你的本地文档自动生成问答对。这是目前最高、也是Ragas框架采用的核心方案。
2.3 Ragas评估的三大维度(RAG Triad)
Ragas框架提出了一个非常天才的逻辑:通过 “LLM监考” 的方式,对以下初始评分:
检索评分(检索)
- 上下文精度(Context Precision) :找回来的那个堆文档里,真正有用的信息不是排在最前面吗?
- 上下文召回率(Context Recall) :标准答案里的知识点,你找回来的文档里都覆盖了吗?
生成评分(Generation)
- 忠实度(Faithiness) :生成的答案不是完全根据搜索到的文档写的?严防模型产生“幻觉”。
- 答案相关性(Answer Relevancy) :回答直是否要害,有没有说废话或不完整?
端到端评分(End-to-End)
- 答案性正确(Answer Correctness) :最终答案和标准答案在语义和事实是否成立。
三、实践步骤:手部分带你完成Ragas定量评估
本节我们将通过代码实验,评估**混合搜索(Hybrid Search)**对 RAG 系统性能的真实影响。
3.1 环境准备与模型初始化
首先,我们需要安装 Ragas 及其可视化依赖:
Python
体验AI代码助手
代码解读
复制代码
pip install ragas tqdm pandas matplotlib langchain_openai
接下来,我们需要定义不同的LLM角色。建议用更强的模型(如GPT-4o-mini)来扮演“裁判”。
Python
ini
体验AI代码助手
代码解读
复制代码
from langchain_openai import ChatOpenAI, OpenAIEmbeddings

# 1. 定义嵌入模型
embedding_function = OpenAIEmbeddings(model="text-embedding-ada-002")

# 2. 定义不同的模型角色
# llm: 你的生产模型
# critic_llm: 你的“监考老师”(裁判模型)
llm = ChatOpenAI(model="gpt-3.5-turbo", temperature=0.0)
critic_llm = ChatOpenAI(model="gpt-4o-mini", temperature=0.0)
3.2 生成合成真值(Ground Truth)
如果现成的考试题,我们可以根据文档自创考卷制作Ragas。
Python
ini
体验AI代码助手
代码解读
复制代码
from ragas.testset.generator import TestsetGenerator
from ragas.testset.evolutions import simple, reasoning, multi_context

# 初始化测试集生成器
generator = TestsetGenerator.from_langchain(llm, critic_llm, embedding_function)

# 生成测试用例:简单题占50%,推理题占25%,多文档关联题占25%
testset = generator.generate_with_langchain_docs(
    documents,
    test_size=10,
    distributions={simple: 0.5, reasoning: 0.25, multi_context: 0.25}
)

# 转换并保存为 CSV,避免重复跑 API 产生费用
testset_df = testset.to_pandas()
testset_df.to_csv('testset_data.csv', index=False)
3.3 运行评估任务
我们需要将“相似度搜索链”和“混合搜索链”的结果分别给予评估器。
Python
ini
体验AI代码助手
代码解读
复制代码
from ragas import evaluate
from ragas.metrics import faithfulness, answer_relevancy, context_recall, context_precision

# 执行评估(假设数据已处理为 Ragas 所需的 Dataset 格式)
score_hybrid = evaluate(
    testing_dataset_hybrid,
    metrics=[faithfulness, answer_relevancy, context_precision, context_recall]
)
hybrid_df = score_hybrid.to_pandas()
四、效果评估:如何分析并可视化你的性能数据?
简单的数字并不洞察。我们需要通过对比分析,洞察看到不同策略的优劣。
4.1 核心指标对比表
通过计算分,我们可以得到如下平均对比数据:
| 评估维度 | 指标名称 | 相似度搜索 | 混合搜索(混合) | 差异 (Diff) |
| 检索(检索) | 上下文精度(Precision) | 0.906 | 0.841 | -0.065 |
| 检索(检索) | 上下文收缩率(Recall) | 0.950 | 0.925 | -0.025 |
| 生成(一代) | 忠诚度(忠诚度) | 0.977 | 0.945 | -0.032 |
4.2 结果深度解读
- 指标反直觉怎么办?
在本案例中,你可能会发现纯混合搜索的表现略逊于辅导搜索。这说明在当前这种特定的小型数据集下,引入关键词搜索(BM25)反而带来了更多无关的“噪音”文档。 - 如何调优?
- 上下文召回低:说明模型缺乏知识。需要检查你的切片(分块)策略或管理认知数量(k值) 。
- 忠诚度低:说明模型在瞎编。需要优化你的提示,强调“如果上下文中没有信息,请回答不知道”。
- 各项指标都低:这通常意味着基础模型(Base Model)的能力已经见顶,无法满足复杂的业务逻辑。
五、总结与展望:从“评估”到“进化”
评估不是RAG构建的终点,而是持续优化的起点。通过Ragas,我们把究竟抽象的“好坏”变成了具体的“分数”,让每一次调参都有据可依。
5.1 进阶:让模型“变成你想要的样子”
在实际实践中,如果仅仅停留在“了解大模型原理”,其实很难真正实现模型能力的差异。
我个人比较推荐在完成评估并发现模型极限后,直接上手做一次模型。比如用LLAMA-Factory Online这种低负债大模型偏差平台,把自己的数据真正“喂”进模型里,生产出属于自己的专属模型。即使没有代码基础,也能轻松跑完流程,在实践中明白怎么让模型“变成你想要的样子”。
博主结语:RAG评估虽然看起来很复杂,但只要建立起一套科学的流程,就能把“玄学”变成“科学”。希望这篇文章能够帮助构建出更稳定、更智能的AI应用!
您想了解更多 RAG 优化技巧吗?欢迎在评论区留言:
- 如何针对PDF文档进行更精准的分块?
- 重排序(Re-rank)模型实战教程
- 面向树化部署,如何使用本地模型跑Ragas?
别忘记点赞、收藏支持一下哦!我们下期见!