NeurIPS 2025!采样成本降 50%+ 准确率提升!南大等团队的RPC方法刷新 LLM 推理上限

简介: 南大&ETH团队提出RPC方法,融合自洽性与内部概率,理论指导LLM推理优化。误差分解新框架揭示瓶颈,Perplexity Consistency与Reasoning Pruning双剑合璧,采样成本降50%+,准确率提升,NeurIPS 2025亮点成果!

NeurIPS 2025!采样成本降 50%+ 准确率提升!南大等团队的RPC方法刷新 LLM 推理上限
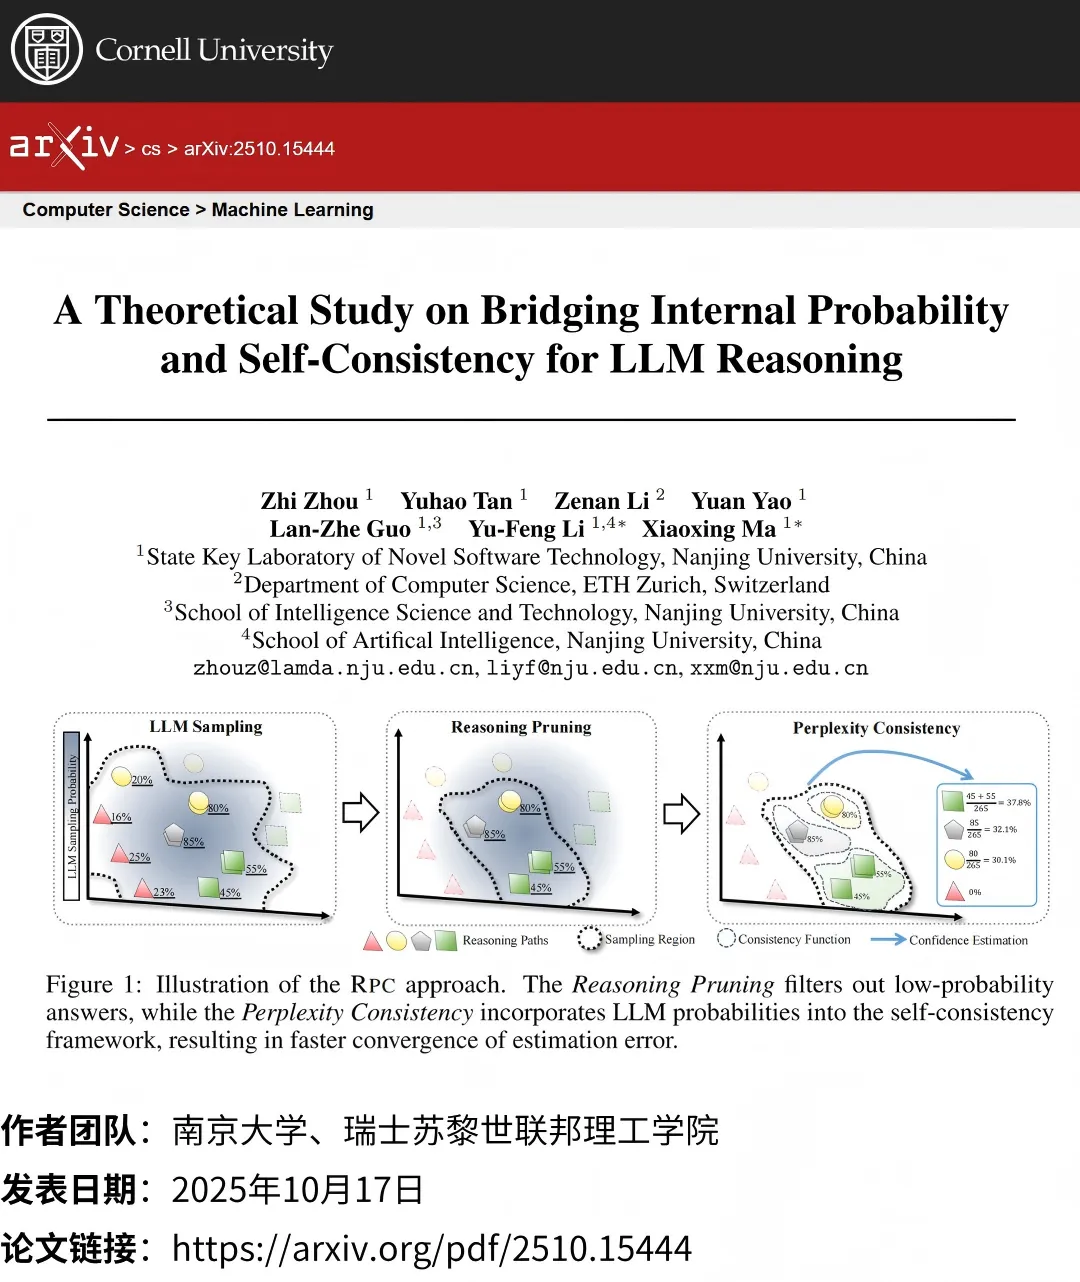
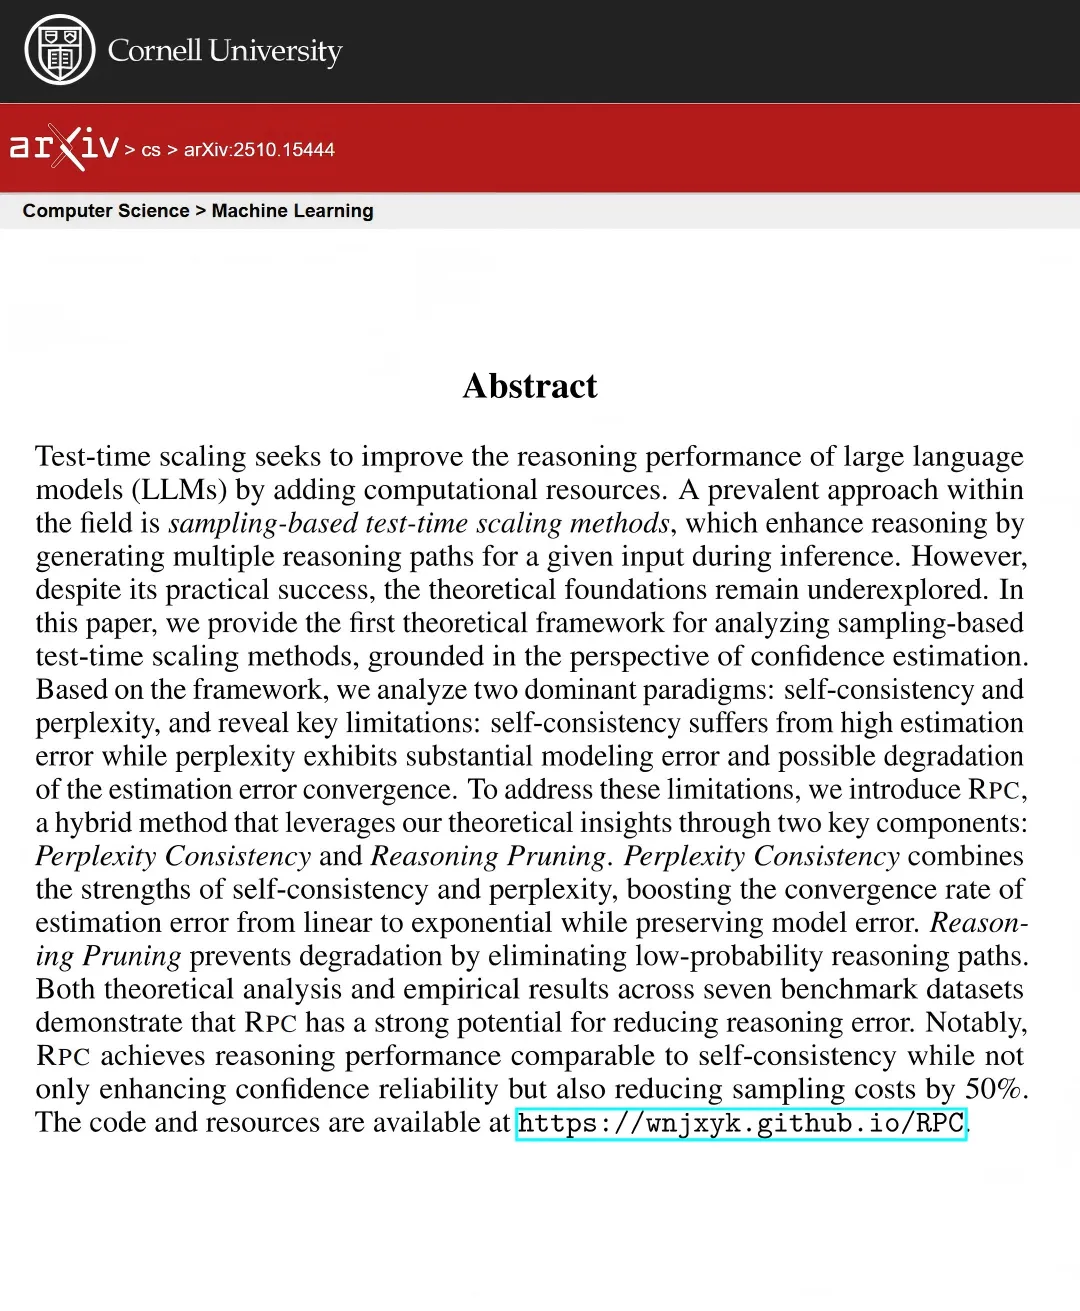
论文标题:A Theoretical Study on Bridging Internal Probability and Self-Consistency for LLM Reasoning

作者团队:南京大学、瑞士苏黎世联邦理工学院

发布时间:2025年10月17日

👉一键直达论文

👉Lab4AI大模型实验室论文阅读

✅Lab4AI平台提供AI导读和AI翻译等工具,辅助论文阅读。您还可以投稿复现这篇论文~

⭐核心贡献

  • 理论框架:首次提出用于分析LLM推理中采样式测试时缩放方法的理论框架,将推理误差分解为估计误差和模型误差。
  • 方法创新:提出RPC方法,融合自洽性和内部概率的优势,通过Perplexity Consistency和Reasoning Pruning组件解决现有方法的局限性。
  • 实证验证:在多个基准数据集上验证RPC的有效性,显著降低采样成本并提升推理性能。

⭐研究方法

  • 误差分解理论:将推理误差分解为估计误差(与采样规模和置信度估计策略相关)和模型误差(由LLM固有推理能力决定)。
  • 现有方法分析:自洽性估计误差收敛慢(线性),困惑度模型误差大且估计误差优势在低概率路径下退化。
  • RPC方法设计:
    • Perplexity Consistency:将LLM内部概率融入自洽性框架,以指数级速率降低估计误差。
    • Reasoning Pruning:通过混合威布尔分布建模概率分布,自动过滤低概率路径,防止估计误差退化。

⭐研究结果

  • 效率提升:RPC在达到与自洽性相同性能时,所需采样数量减少50%以上。
  • 性能优化:在7个基准数据集上,RPC平均准确率优于基线方法(如数学推理任务提升1.29%)。
  • 可靠性增强:RPC的置信度估计更接近真实置信度(预期校准误差更低)。
  • 泛化性验证:在代码生成(如HumanEval)和逻辑推理(如LogiQA)任务中均表现优异。

相关文章
|
11月前
|
机器学习/深度学习 人工智能 测试技术
NeurIPS 2025 | 浙大、浙工大等团队提出LRMs 自适应思考:简单任务快处理,复杂任务深分析
浙大、阿里云等提出首个LRM快慢思维控制方法,发现特定词可触发思维模式,结合PCA导向与自适应策略,实现无需训练的推理速度调控,在多模型上显著提升准确率并减少耗材。
415 1
NeurIPS 2025 | 浙大、浙工大等团队提出LRMs 自适应思考:简单任务快处理,复杂任务深分析
|
3月前
|
Linux API iOS开发
Codex 怎么接入 DeepSeek V4-Flash:官方一键脚本 + 手动配置完整教程
DeepSeek V4-Flash 正式版于2026年7月31日开放公测,原生支持Codex所需的Responses API,告别本地代理与协议降级。官方提供一键配置脚本,跨平台兼容;同时详解手动配置(config.toml/models.json),全面释放子Agent、多工具调用等原生Agent能力。(239字)
2022 0
|
自然语言处理 编译器 Linux
【Latex】texstudio使用和ACL论文模板初步解读
LaTeX是一类用于编辑和排版的软件,用于生成PDF文档。 LaTeX编辑和排版的核心思想在于,通过\section和\paragraph等语句,规定了每一句话在文章中所从属的层次,从而极大方便了对各个层次批量处理。 LaTeX在使用体验方
3036 0
【Latex】texstudio使用和ACL论文模板初步解读
|
4月前
|
人工智能 自然语言处理 IDE
阿里云Qoder CN详细介绍:核心能力、适用场景与计费标准和最新活动参考
Qoder CN(原"通义灵码")是阿里云面向软件开发场景的AI智能体产品,提供IDE、JetBrains、VS Code等多种插件形态,核心能力涵盖代码补全、智能问答、多文件编辑及编程智能体四大模式。产品支持GLM、DeepSeek、Kimi、MiniMax等国内主流大模型自由切换,具备工程自动感知、记忆学习、专家团协作等特性,适配金融、政务等高合规行业。Qoder CN产品家族还包括QoderWork CN(办公助手)、QoderWake CN(数字员工)、Clouds Agents(云端Agent)等子产品,提供企业标准版与专属版方案,助力企业研发智能化与办公自动化升级。
|
11月前
|
机器学习/深度学习 存储 自然语言处理
大模型基础概念术语解释
大语言模型(LLM)基于Transformer架构,通过海量文本训练,具备强大语言理解与生成能力。其核心组件包括注意力机制、位置编码与嵌入层,支持文本分割为Token进行处理。参数量达亿级以上,规模增长带来涌现能力,如复杂推理与跨任务泛化。混合专家模型(MoE)提升效率,推动模型持续扩展。
|
11月前
|
机器学习/深度学习 人工智能 搜索推荐
AI数字人企业12月排名榜
聚焦数字人企业TOP10,解码技术革新与产业未来。从像衍科技的全链条闭环到阿里、腾讯生态布局,透视AI驱动、多模态交互、轻量化部署等十大趋势,展现数字人在服务、娱乐、工业等场景的深度融合,揭示“技术+商业”双轮驱动下的新图景。
|
存储 索引 Python
python 集合的所有基础知识
python 集合的所有基础知识
1372 0
|
10月前
|
人工智能 数据可视化 物联网
大模型微调技术入门:从核心概念到实战落地全攻略
本课程系统讲解大模型微调核心技术,涵盖LoRA、QLoRA等高效方法,结合ComfyUI与主流工具实战,从数据准备到模型部署全流程落地,助力开发者低成本定制专属AI模型。
|
11月前
|
机器学习/深度学习 存储 知识图谱
🫗 知识蒸馏
知识蒸馏是一种模型压缩技术,通过让小模型(学生)模仿大模型(教师)的输出或中间特征,实现性能逼近甚至超越。核心方法包括软标签蒸馏、带温度的Softmax提升信息保留,以及特征层对齐。按信息访问程度分为黑盒与白盒蒸馏,广泛用于加速推理、降低资源消耗,同时提升泛化能力。