“为什么我用开源大模型回答业务问题时,总是答非所问?”
“通用模型能力很强,但在我公司的客服场景中表现很差,怎么办?”
这是许多企业在尝试落地大语言模型(LLM)时遇到的典型问题。虽然像 Llama 3、Qwen、ChatGLM、Baichuan 等开源模型在通用任务上表现出色,但直接用于垂直领域往往效果不佳——它们缺乏对特定术语、业务流程或回答风格的理解。
而微调(Fine-tuning),正是让通用大模型“学会说你的语言”的关键手段。
本文将带你系统了解大模型微调的核心原理、主流方法、实战流程,并提供基于 Hugging Face 和 PEFT 的完整代码示例,助你低成本、高效率地打造专属行业模型
一、为什么需要微调?
1.1 预训练模型的局限性
知识泛化但不精准:知道“客服”是什么,但不知道你公司的退换货政策。
风格不匹配:回答过于学术,而你需要简洁、口语化的客服话术。
领域术语缺失:医疗、金融、法律等专业词汇未充分覆盖。
1.2 微调 vs Prompt Engineering
| 方法 | 优点 | 缺点 |
|---|---|---|
| Prompt 工程 | 无需训练,快速验证 | 效果有限,长上下文易失效 |
| 微调 | 模型内化知识,响应更稳定高效 | 需要数据、算力和工程投入 |
二、大模型微调的主流方法
随着模型参数量激增(7B、13B 甚至 70B),全参数微调(Full Fine-tuning)成本极高。因此,参数高效微调(Parameter-Efficient Fine-Tuning, PEFT) 成为主流。
2.1 全参数微调(Full FT)
更新所有模型参数
效果最好,但显存和算力需求巨大(如 Llama-7B 需 80GB+ GPU 显存)
2.2 参数高效微调(PEFT)
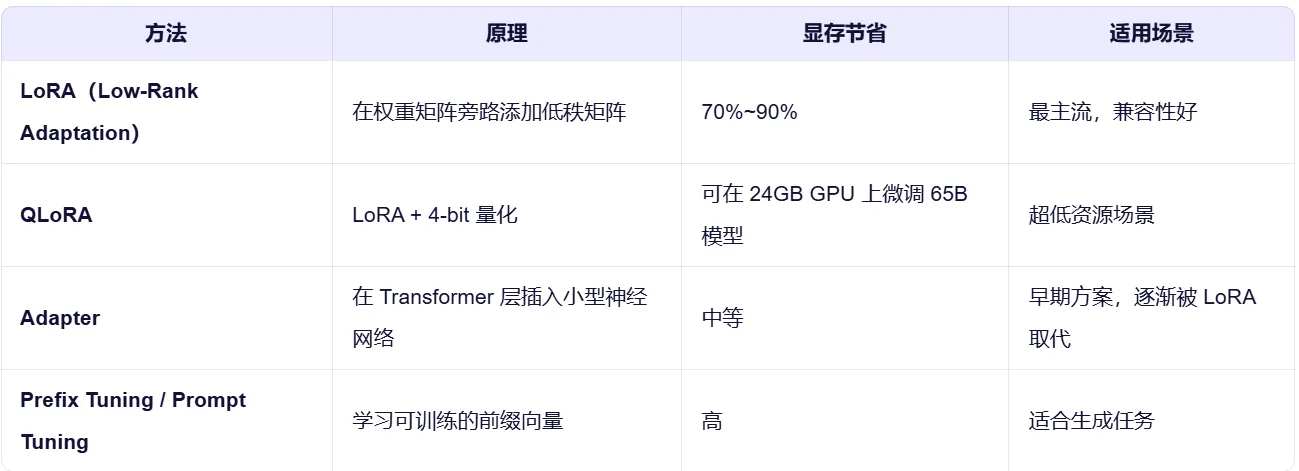
当前工业界首选:LoRA / QLoRA
三、微调实战:以 Llama 3 为例(使用 Hugging Face + PEFT)
我们将使用 Llama-3-8B-Instruct 模型,在自定义客服问答数据集上进行 LoRA 微调。
3.1 环境准备
pip install transformers datasets peft accelerate bitsandbytes trl
要求:至少 24GB GPU 显存(如 RTX 4090 / A10 / A100),或使用 QLoRA 适配 16GB 显卡。
3.2 数据准备
假设你有如下 JSON 格式的指令数据:
[
  {

    "instruction": "用户问:订单还没发货怎么办?",
    "output": "您好,一般订单会在24小时内发货。请您提供订单号,我帮您查询具体状态。"
  },
  ...
]
使用 datasets 加载:
from datasets import load_dataset
dataset = load_dataset("json", data_files="customer_service.json")
3.3 模型加载与 LoRA 配置
from transformers import AutoTokenizer, AutoModelForCausalLM
from peft import LoraConfig, get_peft_model

model_name = "meta-llama/Meta-Llama-3-8B-Instruct"

tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    load_in_4bit=True,          # 启用 4-bit 量化(QLoRA)
    device_map="auto"
)

# 配置 LoRA
peft_config = LoraConfig(
    r=64,                       # 低秩矩阵维度
    lora_alpha=16,
    lora_dropout=0.1,
    target_modules=["q_proj", "v_proj"],  # Llama 的注意力层
    bias="none",
    task_type="CAUSAL_LM"
)

model = get_peft_model(model, peft_config)
model.print_trainable_parameters()  # 通常仅 0.1%~1% 参数可训练
3.4 训练配置(使用 TRL 的 SFTTrainer)
from trl import SFTTrainer
from transformers import TrainingArguments

def formatting_prompts_func(example):
    output_texts = []
    for i in range(len(example['instruction'])):
        text = f"### 用户: {example['instruction'][i]}\n### 客服: {example['output'][i]}"
        output_texts.append(text)
    return output_texts

training_args = TrainingArguments(
    output_dir="./llama3-customer-finetuned",
    per_device_train_batch_size=4,
    gradient_accumulation_steps=4,
    learning_rate=2e-4,
    num_train_epochs=3,
    logging_steps=10,
    save_strategy="epoch",
    fp16=True,
)

trainer = SFTTrainer(
    model=model,
    args=training_args,
    train_dataset=dataset["train"],
    formatting_func=formatting_prompts_func,
    max_seq_length=512,
)

trainer.train()
3.5 推理测试
from transformers import pipeline

pipe = pipeline("text-generation", model=model, tokenizer=tokenizer)
prompt = "### 用户: 我的退款申请还没处理,怎么办?\n### 客服:"

result = pipe(prompt, max_new_tokens=100)
print(result[0]['generated_text'])
四、微调中的关键注意事项
4.1 数据质量 > 数据数量
1000 条高质量指令数据,远胜 10 万条噪声数据
确保格式统一、答案准确、风格一致
4.2 避免灾难性遗忘
微调后模型可能“忘记”通用知识
解决方案:混合通用数据 + 领域数据,或使用 持续学习(Continual Learning)
4.3 评估不能只看 loss
构建人工评估集(如 50 个典型问题)
使用 BLEU、ROUGE 或 LLM-as-a-Judge(用 GPT-4 评分)
4.4 安全与合规
微调数据需脱敏,避免泄露用户隐私
输出需加入内容过滤(如 Llama Guard)
结语
大模型微调不再是大厂专属。借助开源生态(Hugging Face + PEFT + QLoRA),你完全可以在消费级 GPU 上,用几千条数据训练出一个表现优异的垂直领域模型。
关键不在于模型有多大,而在于是否真正理解你的业务。
从今天开始,收集你的领域数据,尝试微调第一个 LLM 吧——你离“专属 AI 助手”只差一次训练。
关于作者
🌟 我是suxiaoxiang,一位热爱技术的开发者
💡 专注于Java生态和前沿技术分享
🚀 持续输出高质量技术内容
如果这篇文章对你有帮助,请支持一下:
👍 点赞
⭐ 收藏
👀 关注
您的支持是我持续创作的动力!感谢每一位读者的关注与认可!