通义千问升级旗舰模型Qwen-Max,性能接近GPT-4o

简介: 通义旗舰模型Qwen-Max全方位升级,性能接近GPT-4o

9月19日云栖大会,阿里云CTO周靖人宣布,通义旗舰模型Qwen-Max全方位升级,性能接近GPT-4o。通义官网和通义APP的后台模型均已切换为Qwen-Max,继续免费为所有用户提供服务。用户也可通过阿里云百炼平台调用Qwen-Max的API。


image.png


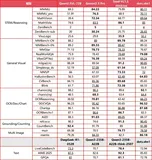
相比上一代模型,Qwen-Max在训练中使用了更多的训练数据、更大的模型规模、更强的人类对齐,最终达到了更高的智能水平。在MMLU-Pro、MATH、GSM8K、MBPP、MultiPL-E、LiveCodeBench等十多个权威基准上,Qwen-Max表现接近GPT-4o,数学能力、代码能力则超越了GPT-4o。数学和代码所代表的推理能力是大模型智能水平的最重要体现。


image.jpeg


相比2023年4月的初代通义千问大模型,Qwen-Max的理解能力提升46%、数学能力提升75%、代码能力提升102%、幻觉抵御能力提升35%、指令遵循能力提升105%,模型与人类偏好的对齐水平更是有了质的飞跃,提升了700%以上。

相关文章
|
12月前
|
人工智能 新制造 云栖大会
TsingtaoAI亮相云栖大会,AI大模型赋能传统制造业焕新升级
2025年9月24日,杭州云栖小镇,2025云栖大会盛大开幕。作为全球AI技术与产业融合的重要平台,本届大会以“AI驱动产业变革”为主题,集中展示大模型技术在各领域的创新应用。 其中,由西湖区商务局牵头组织的“AI大模型应用与产业融合”专场论坛成为大会亮点之一,吸引了来自政府、企业及投资机构的百余名代表参与。 在论坛上,TsingtaoAI作为制造业智能化转型的代表企业,分享了在具身智能-制造企业的AI应用实践。
816 1
|
数据采集 机器学习/深度学习 编解码
小红书 hi lab开源最强多模态大模型dots.vlm1,性能对标闭源 Gemini 2.5 Pro 和 Seed-VL1.5
1107 0
小红书 hi lab开源最强多模态大模型dots.vlm1,性能对标闭源 Gemini 2.5 Pro 和 Seed-VL1.5
|
存储 资源调度 并行计算
# Qwen3-8B 与 Qwen3-14B 的 TTFT 性能对比与底层原理详解
通义千问Qwen3系列是通义实验室2025年推出的最新大模型,包含多种参数版本,其中Qwen3-8B与Qwen3-14B均支持32K token上下文。Qwen3-8B参数量较小,响应更快,适合低延迟交互;Qwen3-14B参数更多,推理更强,适用于复杂任务。两者在TTFT、架构优化、量化技术及部署方案上各有侧重,满足多样应用场景需求。
6174 10
|
机器学习/深度学习 人工智能 测试技术
【ICML2025】大模型后训练性能4倍提升!阿里云PAI团队研究成果ChunkFlow中选
近日,阿里云 PAI 团队、通义实验室与中国科学院大学前沿交叉科学学院合作在机器学习顶级会议 ICML 2025 上发表论文 Efficient Long Context Fine-tuning with Chunk Flow。ChunkFlow 作为阿里云在变长和超长序列数据集上高效训练解决方案,针对处理变长和超长序列数据的性能问题,提出了以 Chunk 为中心的训练机制,支撑 Qwen 全系列模型的长序列续训练和微调任务,在阿里云内部的大量的业务上带来2倍以上的端到端性能收益,大大降低了训练消耗的 GPU 卡时。
|
机器学习/深度学习 人工智能 自然语言处理
34_GPT系列:从1到5的架构升级_深度解析
大型语言模型(LLM)的发展历程中,OpenAI的GPT系列无疑扮演着至关重要的角色。自2018年GPT-1问世以来,每一代GPT模型都在架构设计、预训练策略和性能表现上实现了质的飞跃。本专题将深入剖析GPT系列从1.17亿参数到能够处理百万级token上下文的技术演进,特别关注2025年8月8日发布的GPT-5如何引领大模型技术迈向通用人工智能(AGI)的重要一步。
1254 2
|
人机交互 API 开发工具
基于通义多模态大模型的实时音视频交互
Qwen-Omni是通义千问系列的全新多模态大模型,支持文本、图像、音频和视频的输入,并输出文本和音频。Omni-Realtime服务针对实时交互场景优化,提供低延迟的人机交互体验。
2262 23