数据标注工具 doccano | 命名实体识别(Named Entity Recognition,简称NER)

简介: 数据标注工具 doccano | 命名实体识别(Named Entity Recognition,简称NER)

目录


命名实体识别(Named Entity Recognition,简称NER),是指识别文本中具有特定意义的实体。在开放域信息抽取中,抽取的类别没有限制,用户可以自己定义。

安装

详见:数据标注工具 doccano | 文本分类(Text Classification)

数据准备

上传的文件为txt格式,每一行为一条待标注文本,示例:

corpus.txt 随便找了几个,一般都是垂直领域的数据标注

(右肝肿瘤)肝细胞性肝癌(II-III级,梁索型和假腺管型),肿瘤包膜不完整,紧邻肝被膜,侵及周围肝组织,未见脉管内癌栓(MVI分级:M0级)及卫星子灶形成。(肿物1个,大小4.2×4.0×2.8cm)。
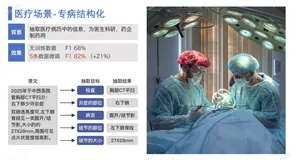
患者20天前无明显诱因出现左侧胸背部持续性疼痛,于2025.02.01下城区中西医结合医院查胸部CT平扫示:右下肺少许炎症;肺气肿;慢性胰腺炎;建议追踪复查
双肺透亮度可,左下肺背段见一类圆开/结节影,大小约27X28mm,周围可见片状密度增高影,病变局部与胸膜粘连

创建项目

UIE 支持抽取与分类两种类型的任务,根据实际需要创建一个新的项目:

适配命名实体识别、关系抽取、事件抽取、评价观点抽取等任务

适配文本分类、句子级情感倾向分类等任务。

创建抽取式任务

上传

NOTE:doccano支持TextFile、TextLine、JSONL和CoNLL四种数据上传格式,UIE定制训练中统一使用TextLine这一文件格式,即上传的文件需要为txt格式,且在数据标注时,该文件的每一行待标注文本显示为一页内容。

定义标签

构建抽取式任务标签

抽取式任务包含Span与Relation两种标签类型,Span指原文本中的目标信息片段,如实体识别中某个类型的实体,事件抽取中的触发词和论元;Relation指原文本中Span之间的关系,如关系抽取中两个实体(Subject&Object)之间的关系,事件抽取中论元和触发词之间的关系。

以 corpus.txt 中的第一条数据为例(医疗场景-专病结构化):

任务标注

命名实体识别

导出数据

选择导出的文件类型为JSONL(relation),导出数据示例:

查看数据

标注数据保存在同一个文本文件中,每条样例占一行且存储为json格式,其包含以下字段

  • id: 样本在数据集中的唯一标识ID。
  • text: 原始文本数据。
  • entities: 数据中包含的Span标签,每个Span标签包含四个字段:
  • id: Span在数据集中的唯一标识ID。
  • start_offset: Span的起始token在文本中的下标。
  • end_offset: Span的结束token在文本中下标的下一个位置。
  • label: Span类型。
  • relations: 数据中包含的Relation标签,每个Relation标签包含四个字段:
  • id: (Span1, Relation, Span2)三元组在数据集中的唯一标识ID,不同样本中的相同三元组对应同一个ID。
  • from_id: Span1对应的标识ID。
  • to_id: Span2对应的标识ID。
  • type: Relation类型。

应用实例

PaddleNLP UIE -- 药品说明书信息抽取(名称、规格、用法、用量)

目录
相关文章
|
存储 NoSQL 关系型数据库
PostgreSQL列存扩展hydra简单测试
Hydra是一款PostgreSQL的扩展,为PostgreSQL增加了列存引擎,使得PostgreSQL的olap性能大幅提升,本文介绍Hydra基本的使用方法。
|
应用服务中间件 JavaScript 虚拟化
阿里云香港轻量应用服务器介绍与测评:月付24元/30Mbps带宽/1TB流量
阿里云香港24是阿里云推出了一款非常优惠的香港的轻量应用服务器,每个月只需要24元,流量有1T,30M的带宽,国内延迟非常低,联通和移动是直连,电信去程ntt,回程cn2,性价比非常高。本文详细介绍这个方案的配置以及做一个简单的测评。
35149 0
|
存储 自然语言处理 数据处理
PaddleNLP--UIE--小样本快速提升性能(含doccona标注
需求跨领域跨任务:领域之间知识迁移难度高,如通用领域知识很难迁移到垂类领域,垂类领域之间的知识很难相互迁移;存在实体、关系、事件等不同的信息抽取任务需求。 - 定制化程度高:针对实体、关系、事件等不同的信息抽取任务,需要开发不同的模型,开发成本和机器资源消耗都很大。 - 训练数据无或很少:部分领域数据稀缺,难以获取,且领域专业性使得数据标注门槛高。
PaddleNLP--UIE--小样本快速提升性能(含doccona标注
|
JavaScript 内存技术
node与npm版本对应关系以及使用nvm管理node版本
9528 0
|
存储 自然语言处理 数据处理
信息抽取UIE(二)--小样本快速提升性能(含doccona标注
需求跨领域跨任务:领域之间知识迁移难度高,如通用领域知识很难迁移到垂类领域,垂类领域之间的知识很难相互迁移;存在实体、关系、事件等不同的信息抽取任务需求。 - 定制化程度高:针对实体、关系、事件等不同的信息抽取任务,需要开发不同的模型,开发成本和机器资源消耗都很大。 - 训练数据无或很少:部分领域数据稀缺,难以获取,且领域专业性使得数据标注门槛高。
信息抽取UIE(二)--小样本快速提升性能(含doccona标注
Dataset之Boston:Boston波士顿房价数据集的简介、下载、使用方法之详细攻略
|
5月前
|
机器学习/深度学习 IDE 数据挖掘
2026最新Jupyter Notebook安装使用保姆级教程(附安装包+图文步骤)
Jupyter Notebook是基于网页的交互式编程工具,支持Python、R等数十种语言。以单元格为单位执行代码,即时显示结果,融合代码、文字与图表,适合数据分析、教学及报告编写。推荐通过Anaconda一键安装。
|
人工智能 JavaScript Java
【SpringAIAlibaba新手村系列】(1)初识 Spring AI Alibaba 框架
本文介绍了SpringAIAlibaba框架的基本概念和使用方法。作为Spring官方AI框架的阿里云实现版本,它简化了Java开发者调用AI模型的过程。文章详细讲解了核心概念如ChatModel、ChatClient,以及阿里云百炼平台的功能。通过HelloWorld项目示例,展示了如何配置APIKey、编写控制层代码,实现普通调用和流式输出两种AI交互方式。重点阐述了SpringAI与SpringAIAlibaba的关系,以及自动配置机制的工作原理,帮助开发者快速上手这一框架。
10504 9
|
6月前
|
存储 人工智能 API
Coze(扣子)平台上建立知识库的流程
在Coze平台构建知识库,是赋予AI智能体专业能力的核心步骤。流程涵盖创建、导入分段、向量化索引、召回测试、挂载Agent、Prompt配置及进阶优化(如自动更新、多模态支持),操作直观高效。
|
7月前
|
消息中间件 缓存 NoSQL
跑腿外卖系统开发高并发订单处理与系统稳定性设计
本文详解跑腿外卖系统高并发订单处理的核心方案:通过Redis缓存、RabbitMQ/Kafka消息队列、异步下单、智能骑手派单、订单状态机及限流熔断等技术,有效应对午晚高峰流量,保障订单不丢、派单及时、支付稳定,提升系统可靠性与扩展性。(239字)

热门文章

最新文章