
需要源码请点赞关注收藏后在评论区留下QQ邮箱
马尔可夫决策过程(MDP)是强化学习的数学理论基础,马尔可夫决策过程以概率形式对强化学习任务进行建模,并对强化学习过程中出现的状态 动作 状态转移概率和奖赏等概念进行抽象表达。从而实现对强化学习任务的求解,即得到最优策略,获得最大累计奖赏。
关于扫地机器人环境动画的搭建 可以参考我这篇文章 搭建机器人环境
马尔可夫决策过程
1:马尔可夫性质
在某一任务中 如果Agent从环境中得到的下一状态仅仅依赖于当前状态,而不考虑历史状态,那么该任务即满足马尔可夫性质,虽然从定义上来看只有当前状态和与其相邻的下一个状态具有关联性,但实际上当前状态蕴含了前面所有历史状态的信息,只不过在已知当前状态的情况下,可以丢弃其他所有的历史信息。
2:马尔可夫过程(MP)
由二元组(St,St+1)组成的马尔科夫链,该链中的所有状态都满足马尔可夫性质。
3:马尔可夫奖赏过程(MRP)
由三元组(S,P,R)组成的马尔可夫过程,根据概率,状态自发的转移,其状态转移概率与动作无关
4:马尔可夫决策过程
由四元组(S,A,P,R)组成的马尔可夫过程,状态依靠动作进行转移,根据状态空间或动作空间是否有穷,也可以分为有穷马尔可夫决策过程和无穷马尔可夫决策过程。
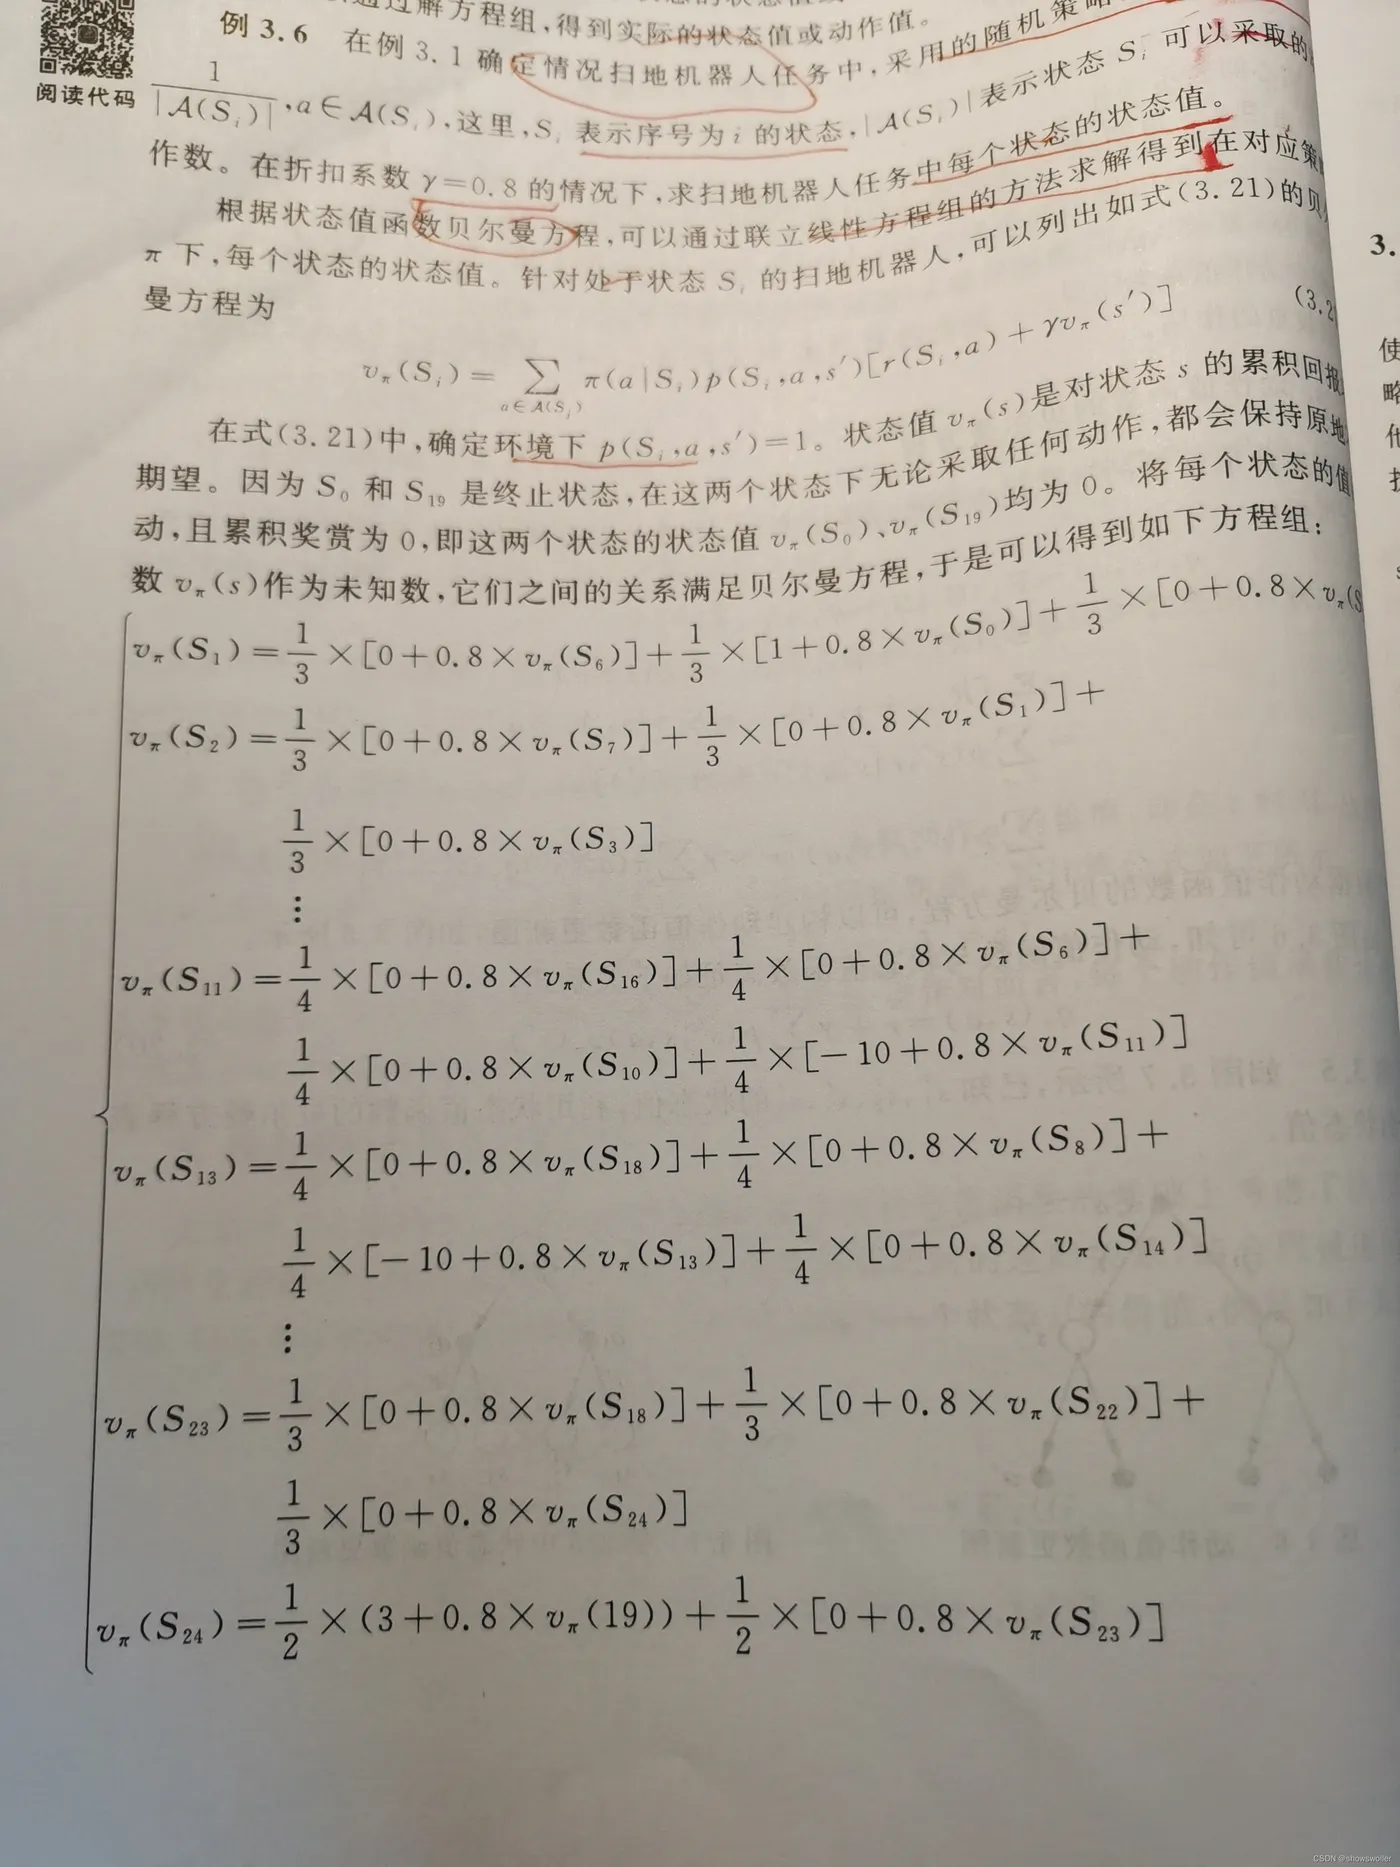
机器人状态函数值的贝尔曼方程如下
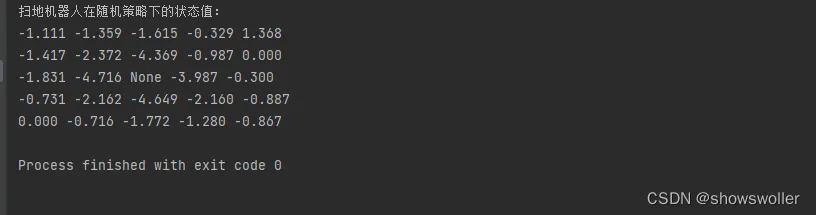
代码输出结果如下
代码如下
'''
深度强化学习——原理、算法与PyTorch实战
'''
import numpy as np
class sweeprobot():
    def __init__(self):
        # 状态空间
        self.S = [[[0, 0], [0, 1], [0, 2], [0, 3], [0, 4], [0, 5]],
                  [[1, 0], [1, 1], [1, 2], [1, 3], [1, 4], [1, 5]],
                  [[2, 0], [2, 1], [2, 2], [2, 3], [2, 4], [2, 5]],
                  [[3, 0], [3, 1], [3, 2], [3, 3], [3, 4], [4, 5]],
                  [[4, 0], [4, 1], [4, 2], [4, 3], [4, 4], [4, 5]],
                  [[5, 0], [5, 1], [5, 2], [5, 3], [5, 4], [5, 5]]]
        # 动作空间
        self.A = [[None, None], [-1, 0], [1, 0], [0, -1], [0, 1]]
        # 状态值
        self.V = [[None for i in range(6)] for j in range(6)]
        self.V[1][1] = 0
        self.V[5][4] = 00
        # 策略
        self.pi = None
        self.gamma = 0.8
    def reward(self, s, a):
        # 奖励函数
        [truth1, truth2] = np.add(s, a) == [5, 4]
        [truth3, truth4] = np.add(s, a) == [1, 1]
        [truth5, truth6] = np.add(s, a) == [3, 3]
        # 若状态s转移到[5,4](收集垃圾)
        if s != [5, 4] and (truth1 and truth2):
            return 3
        # 若状态s转移到[1,1](充电)
        if s != [1, 1] and (truth3 and truth4):
            return 1
        # 若状态s转移到[3,3](撞到障碍物)
        if truth5 and truth6:
            return -10
        return 0
    def cal_coefficient(self):
        # 该函数用来计算出线性方程组的系数矩阵和向量值
        # 首先初始化一个25 * 25的系数矩阵和25个元素的向量
        coef_Matrix = [[0 for i in range(25)] for j in range(25)]
        b = [0 for i in range(25)]
        for i in range(1, 6):
            for j in range(1, 6):
                # 判断是否是终止情况,如果是的话直接计算下一个
                [truth1, truth2] = [i == 5, j == 4]
                [truth3, truth4] = [i == 1, j == 1]
                [truth5, truth6] = [i == 3, j == 3]
                if truth1 and truth2:
                    continue
                if truth3 and truth4:
                    continue
                if truth5 and truth6:
                    continue
                # 计算当前状态下的动作数,以用于计算策略pi
                count_action = 0
                if i - 1 >= 1:
                    count_action += 1
                if i + 1 <= 5:
                    count_action += 1
                if j - 1 >= 1:
                    count_action += 1
                if j + 1 <= 5:
                    count_action += 1
                self.pi = 1 / count_action
                # 具体计算每一个状态值的函数
                b_value = 0
                coef_CurrentState = 0
                # 向上的情况
                if i - 1 >= 1:
                    b_value = b_value + self.pi * self.reward(self.S[i][j], self.A[1])
                    if i - 1 == 3 and j == 3:
                        coef_CurrentState = self.pi * self.gamma
                    else:
                        coef1 = self.pi * self.gamma
                        coef_Matrix[(i - 1) * 5 + j - 1][((i - 1) - 1) * 5 + j - 1] = coef1
                # 向下的情况
                if i + 1 <= 5:
                    b_value = b_value + self.pi * self.reward(self.S[i][j], self.A[2])
                    if i + 1 == 3 and j == 3:
                        coef_CurrentState = self.pi * self.gamma
                    else:
                        coef2 = self.pi * self.gamma
                        coef_Matrix[(i - 1) * 5 + j - 1][((i + 1) - 1) * 5 + j - 1] = coef2
                # 向左的情况
                if j - 1 >= 1:
                    b_value = b_value + self.pi * self.reward(self.S[i][j], self.A[3])
                    if j - 1 == 3 and i == 3:
                        coef_CurrentState = self.pi * self.gamma
                    else:
                        coef3 = self.pi * self.gamma
                        coef_Matrix[(i - 1) * 5 + j - 1][(i - 1) * 5 + (j - 1) - 1] = coef3
                # 向右的情况
                if j + 1 <= 5:
                    b_value = b_value + self.pi * self.reward(self.S[i][j], self.A[4])
                    if j + 1 == 3 and i == 3:
                        coef_CurrentState = self.pi * self.gamma
                    else:
                        coef4 = self.pi * self.gamma
                        coef_Matrix[(i - 1) * 5 + j - 1][(i - 1) * 5 + (j + 1) - 1] = coef4
                # 将左边的移项,所以系数为-1 (单位矩阵减系数矩阵)
                coef_Matrix[(i - 1) * 5 + j - 1][(i - 1) * 5 + j - 1] = -1 + coef_CurrentState
                # 同理,将常数项移项需要乘-1
                b[(i - 1) * 5 + j - 1] = -1 * b_value
        # 因为状态[1,1]和状态[5,4]可以确定其状态值为0,状态[3,3]不存在,所以其实只需求22*22的矩阵
    sr = sweeprobot()
    A, b = sr.cal_coefficient()
    sr.solve_equation(A, b)
    sr.print_value()
最优策略
最优策略就是使得值函数最大的策略。通过计算值函数可以精确的得到至少一个最优策略,优于或等效于其他所有策略,此时记为最优状态值函数。
下面求解确定环境下扫地机器人任务的最优状态值函数 并给出最优策略
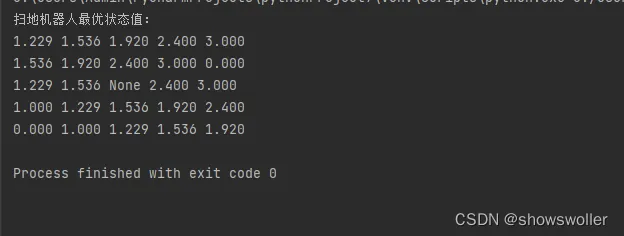
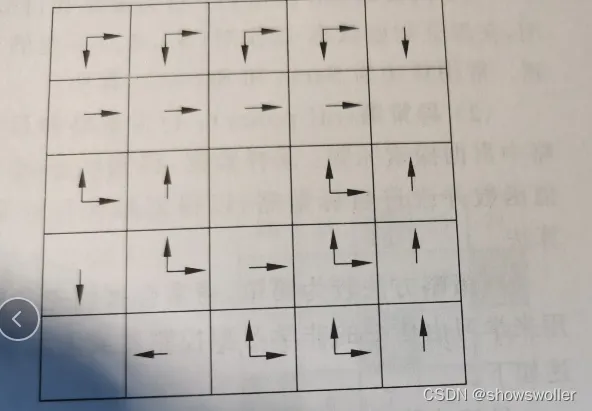
代码如下
'''
深度强化学习——原理、算法与PyTorch实战
'''
import numpy as np
class SweepRobot():
    def __init__(self):
        # 状态空间
        self.S = [[[0, 0], [0, 1], [0, 2], [0, 3], [0, 4], [0, 5]],
                  [[1, 0], [1, 1], [1, 2], [1, 3], [1, 4], [1, 5]],
                  [[2, 0], [2, 1], [2, 2], [2, 3], [2, 4], [2, 5]],
                  [[3, 0], [3, 1], [3, 2], [3, 3], [3, 4], [4, 5]],
                  [[4, 0], [4, 1], [4, 2], [4, 3], [4, 4], [4, 5]],
                  [[5, 0], [5, 1], [5, 2], [5, 3], [5, 4], [5, 5]]]
        # 动作空间
        self.A = [[None, None], [-1, 0], [1, 0], [0, -1], [0, 1]]
        # 状态值
        self.V = [[None for i in range(6)] for j in range(6)]
        self.V[1][1] = 0
        self.V[5][4] = 0
        # 无策略
        self.gamma = 0.8
        self.theta = 0.0001
    def reward(self, s, a):
        # 奖励函数
        [truth1, truth2] = np.add(s, a) == [5, 4]
        [truth3, truth4] = np.add(s, a) == [1, 1]
        [truth5, truth6] = np.add(s, a) == [3, 3]
        # 若状态s转移到[5,4](收集垃圾)
        if s != [5, 4] and (truth1 and truth2):
            return 3
        # 若状态s转移到[1,1](充电)
        if s != [1, 1] and (truth3 and truth4):
            return 1
        # 若状态s转移到[3,3](撞到障碍物)
        if truth5 and truth6:
            return -10
        return 0
        while True:
            Delta = 0
            for i in range(1, 6):
                for j in range(1, 6):
                    # 判断是否是终止情况,如果是的话直接计算下一个
                    [truth1, truth2] = [i == 5, j == 4]
                    [truth3, truth4] = [i == 1, j == 1]
                    [truth5, truth6] = [i == 3, j == 3]
                    if truth1 and truth2:
                        continue
                    if truth3 and truth4:
                        continue
                    if truth5 and truth6:
                        continue
                    v = self.V[i][j]
                    # 因为每个状态的动作空间不一样,所以需要分情况讨论
                    max_value = 0
                    # 向上的情况
                    if i - 1 >= 1:
                        if i - 1 == 3 and j == 3:
                            max_value = max(max_value, self.reward(self.S[i][j], self.A[1]) + self.gamma * self.V[i][j])
                        else:
                            max_value = max(max_value, self.reward(self.S[i][j], self.A[1]) + self.gamma * self.V[i - 1][j])
                    # 向下的情况
                    if i + 1 <= 5:
                        if i + 1 == 3 and j == 3:
                            max_value = max(max_value, self.reward(self.S[i][j], self.A[1]) + self.gamma * self.V[i][j])
                        else:
                            max_value = max(max_value, self.reward(self.S[i][j], self.A[2]) + self.gamma * self.V[i + 1][j])
                    # 向左的情况
                    if j - 1 >= 1:
                        if j - 1 == 3 and i == 3:
                            max_value = max(max_value, self.reward(self.S[i][j], self.A[1]) + self.gamma * self.V[i][j])
                        else:
                            max_value = max(max_value, self.reward(self.S[i][j], self.A[3]) + self.gamma * self.V[i][j - 1])
                    # 向右的情况
                    if j + 1 <= 5:
                        if j + 1 == 3 and i == 3:
                            max_value = max(max_value, self.reward(self.S[i][j], self.A[1]) + self.gamma * self.V[i][j])
                        else:
                            max_value = max(max_value, self.reward(self.S[i][j], self.A[4]) + self.gamma * self.V[i][j + 1])
                    copy_V[i][j] = max_value
                    Delta = max(Delta, abs(v - copy_V[i][j]))
            self.V = copy_V
            if Delta < self.theta:
                break
    def print_value(self):
        # 输出扫地机器人的状态值
        print('扫地机器人最优状态值:')
        for i in range(1, 6):
            for j in range(1, 6):
                if self.V[j][6 - i] != None:
                    print('%.3f'%self.V[j][6 - i], end=" ")
                else:
                    print(self.V[j][6 - i], end=" ")
            print()
if __name__ == '__main__':
    sr = SweepRobot()
    sr.cal_optimal_value()
    sr.print_value()
