摘要:从Cloudflare沙箱快照机制出发,建立仓库、依赖、工具、数据和网络一致的Agent评测环境。
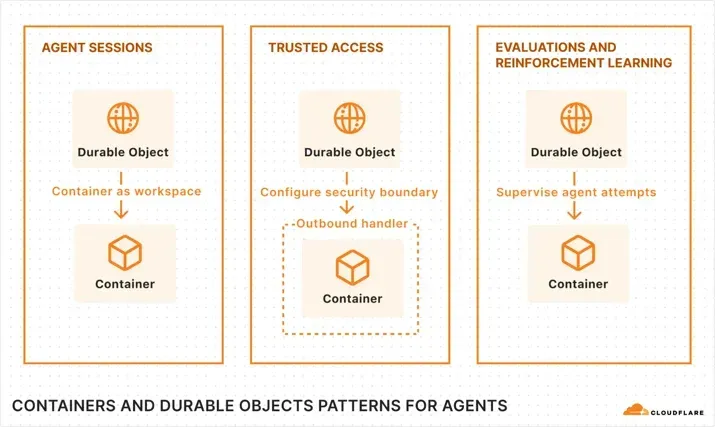
Cloudflare在2026年9月30日介绍面向Agent工作负载重构的Containers时,明确写到一个评测前提:比较不同系统提示词、Skill、模型或Agent版本时,仓库、依赖、工具和输入文件必须保持固定;文件系统快照可以从同一基线启动多个隔离环境,避免环境漂移干扰结果。
这不是抽象的基础设施话题。很多团队遇到过同一种困惑:昨天模型A通过,今天模型B失败;换回模型A又好了,于是结论变成“模型不稳定”。可仔细看才发现,昨天装的是浏览器127,今天自动升级到128;一个环境有缓存,另一个没有;数据库快照中的订单状态已经被前一条用例改过。
Agent本来就有随机性,如果环境也不固定,测试报告无法区分模型变化和实验噪声。环境一致性因此不是运维附属项,而是Agent Evaluation的基本质量条件。
先固定六类变量
第一是代码:仓库提交、未跟踪文件和子模块。第二是依赖:锁文件、镜像摘要、浏览器与驱动。第三是工具:MCP服务器、Skill、命令行版本和工具Schema。第四是数据:数据库快照、对象存储、测试账号和时间。第五是网络:允许域、DNS、模拟服务和故障注入。第六是运行策略:CPU、内存、超时、重试与并发。
只记录“模型=某版本”远远不够。一次评测需要一个environment_id,把这六类指纹聚合起来。结果表里每条Trace都绑定模型、提示词、Agent代码和environment_id,才能做有效对比。
为什么清理目录不等于重置环境
Agent会安装包、生成配置、写缓存、启动服务、修改数据库、保留浏览器状态。测试结束后删除工作目录,可能仍留下容器外的缓存、远程记录或队列消息。下一个样本继承这些状态,就会产生顺序依赖。
更可靠的方式是从只读基线或快照创建独立环境,每条高风险样本结束后销毁。需要测试长任务暂停恢复时,再把快照本身作为被测对象:恢复后文件是否一致、进程是否应当重启、临时凭证是否已经过期、未完成副作用如何补偿。
下面的检查把环境问题和模型问题分开:
def compare_runs(a, b):
    assert a.environment_fingerprint == b.environment_fingerprint
    assert a.dataset_version == b.dataset_version
    assert a.tool_schema_hash == b.tool_schema_hash
    return {

        "behavior_changed": a.tool_calls != b.tool_calls,
        "outcome_changed": a.business_result != b.business_result,
        "cost_delta": b.cost - a.cost,
    }
如果前三个前提不相同,先不要讨论模型回归。它们相同之后,行为和结果变化才有分析价值。
设计快照时要避免“把污染也保存下来”
快照不是越晚越好。最干净的基线应在安装依赖、加载固定数据、确认健康检查之后生成,但在任何测试用例运行之前。快照内不能包含真实凭证、用户会话和上一轮产物。需要凭证时,在启动后注入短期令牌;任务结束立即回收。
对RAG或搜索Agent,还要固定索引版本和检索时间。只快照本地文件、却让远程知识库持续更新,答案仍会漂。对浏览器Agent,需要控制系统时间、地区、语言、窗口尺寸和实验开关。对Coding Agent,则要固定编译器、包源和外部API桩。
用顺序打乱实验抓出共享状态污染
把同一批用例按A→B→C、C→B→A和随机顺序各跑一次。如果某条用例只在特定前序后失败,说明环境没有真正隔离。常见污染包括登录会话、浏览器LocalStorage、数据库自增值、队列未消费消息、临时文件和模型记忆。
再做并发实验:从同一基线快照同时启动两份沙箱,给它们相同订单号但不同用户身份。检查文件系统、端口、缓存、数据库命名空间和凭证是否串线。Agent评测为了节省时间往往会并行,若隔离边界不清,结果会出现难以重现的“随机失败”。
快照恢复也要验时间语义。任务暂停两小时后恢复,旧临时凭证应失效,超时中的订单不能继续无条件提交;计划里记录的“今天”要重新解析还是保持任务创建时含义,必须由业务定义。文件恢复成功不代表任务仍被授权。
最后验证快照可销毁。测试结束后,短期令牌、用户数据、下载文件和浏览器Cookie是否彻底清理;保留用于复盘的失败快照是否加密、限时并限制访问。可复现不能成为长期堆积敏感数据的理由。
给每次评测生成一份环境差异报告
报告不需要展示整个镜像,只列出与基线不同的内容:包版本、浏览器、环境变量名称、工具Schema哈希、数据集版本、网络策略和资源限制。差异出现时先由测试确认是否预期;未批准的差异直接让本轮结果无效。
这份报告还能帮助成本分析。同一个Agent突然变慢,如果镜像、依赖与数据完全一致,才值得继续查模型和工具;如果CPU限额或沙箱启动策略变了,先修实验条件。把无效实验挡在评分之前,往往比换一个更强Judge更省时间。
环境差异经过批准后,要生成新的基线版本,避免团队长期把预期变化当作异常噪声处理。
新旧基线都需可追溯和回滚。
回归报告别再只写“重跑通过”
重跑通过可能意味着第一次是偶发环境问题,也可能意味着模型碰巧走了另一条路径。报告应保存第一次和重跑的环境指纹、Trace首错、外部依赖响应和副作用。分类为环境漂移、模型选择、工具不稳定、测试数据污染或真实产品缺陷。
质量门禁可以分两步:环境预检不通过,整批评测标记无效并停止;环境一致后,再计算任务成功率、行为合规、延迟和成本。这样不会把坏实验数据送进模型比较,也不会让模型背环境的锅。
小团队怎样开始
不需要立刻引入复杂的容器调度。先用固定Docker镜像、锁文件、数据库种子和Mock服务;每次运行生成一个JSON指纹;测试结束销毁容器;失败时保留只读快照和Trace。等用例规模上来,再引入文件系统快照、并行隔离和按需恢复。
Agent评测最容易被忽略的能力,不是更聪明的Judge,而是可靠实验设计。只有控制变量,版本对比才有意义。测试工程师熟悉环境、数据、可复现和故障注入,这些传统能力在AI系统里没有过时,反而决定团队能不能把“感觉模型变差了”变成一份可验证的质量结论。
本文部分内容参考了霍格沃兹测试开发学社整理的相关技术资料,主要涉及软件测试、自动化测试、测试开发及 AI 测试等内容,侧重测试实践、工具应用与工程经验整理。