
语音模型这一轮上新之后,百炼语音能力矩阵的目录价出现了三种计费单位。对企业来说,这不是一句"降价多少"能概括的事:账单核对、预算换算、调用留档,都要先解决"三行数字不能横着比"这件事。本文把这两天跑出来的路径整理成一份可复用的核账说明。
模型矩阵与单位分布
bl model list --capability TTS --page-size 60 --output json
bl model list --capability ASR --page-size 60 --output json
目录查询不需要登录,也不消耗额度,适合挂进定期巡检。返回里 prices[].priceUnit 是单位:合成 19 族中 cosyvoice、qwen3-tts 挂"每万字符",新上架的 3.1 挂"每百万tokens";识别 18 族中 fun-asr、paraformer、qwen3-asr 按秒,只有 3.1-ASR 按词元。同族之内价差可达七倍半,3.1-ASR 流式版本输入价 6 元,非流式 0.8 元,实时链路与离线批处理在目录里挨着排。单价明细以计费文档为准。
一次调用的用量从哪取
装 CLI 走官方 skill 包由 coding agent 代跑,终端 npm install -g bailian-cli 命令一致;合成与识别要 Key,控制台签发,参数见密钥文档。我对 Agent 说:
用百炼的 qwen-audio-3.1-tts-flash 把这份口播稿合成 wav,音色 longanhuan_v3.1,把这一单的用量字段原样贴出来。
它跑的是:
bl speech synthesize --text-file text-zh.txt --model qwen-audio-3.1-tts-flash --voice longanhuan_v3.1 --format wav --out new.wav --output json
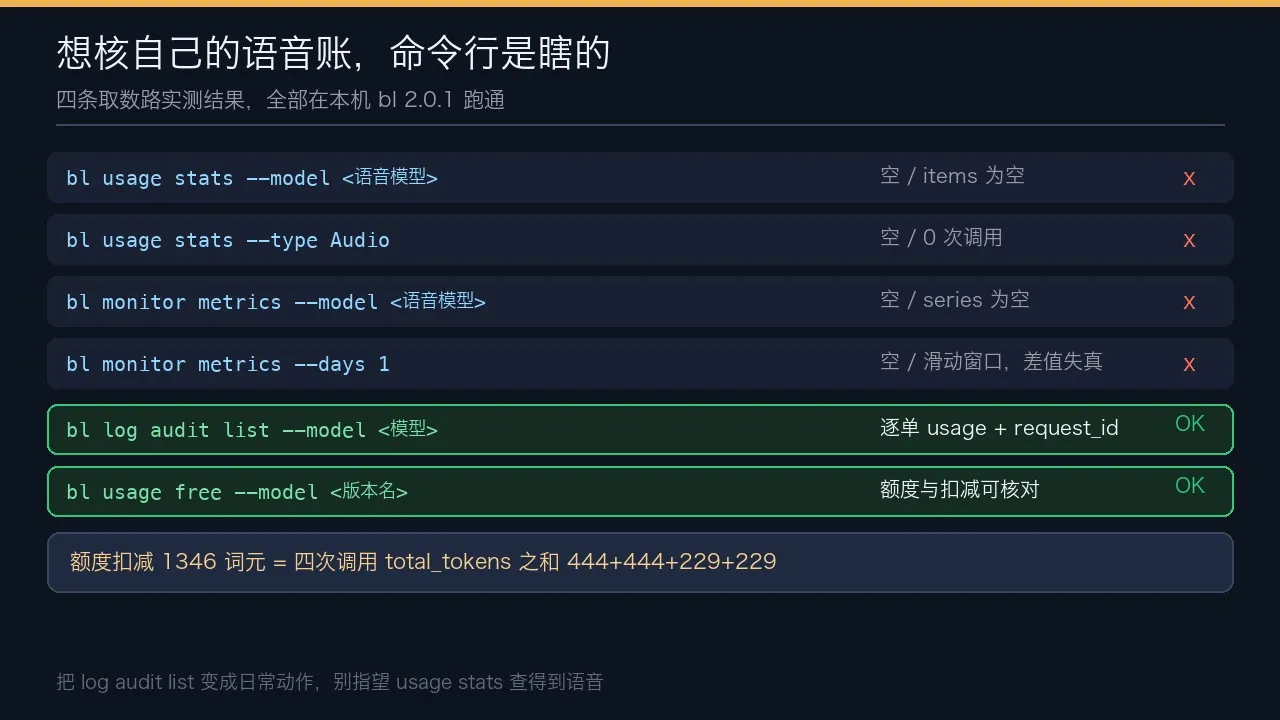
核账面四条命令各有结果:bl usage stats --model qwen-audio-3.1-tts-flash --days 1 --output json 与 bl usage stats --days 1 --type Audio --output json 返回空 items,bl monitor metrics 的 model_usage、model_total_amount 返回空 series。账号级视图有数,但当天几十次调用糊在一起,隔离不出单个业务;--days 1 是滑动窗口,两次查询之间数字自己会变小,相减不成立。这几条在 bl 帮助里都标 [Console],要 bl auth login --console 浏览器登录,和合成用的 API Key 是两拨凭证。逐单粒度只有审计日志给:
bl log audit list --hours 1 --model qwen-audio-3.1-tts-flash --output json
bl usage free --model qwen-audio-3.1-tts-flash --output json
每条记录带 request_id、调用时间和 usage 原文。本文所有用量数字都抄自它。这条命令的帮助文本自己跟自己对不上:bl log audit list --help 的 Usage 行只列了 [--hours <n>],同页 --start-time 的说明却写着"overrides --days",真传 --days 得到 Unknown flag "--days"。采集脚本以报错为准,别以文案为准。
额度与预算规则
3.1 合成与识别各有 1,000,000 词元额度,2026-12-21 到期,剩余分别为 998654 与 999556;paraformer-v2 是 36000 秒、到期显示 2099-01-01;cosyvoice 用版本名查额度返回空。通用规则是每模型独立、90 天有效期、仅北京地域、过期不补发、用尽不自动切换,见免费额度说明。这批调用实付 0 元,因为全部落在额度内,额度用尽之后按目录价计费。
额度查询按完整模型名,族名会返回 total=0(bl usage free --model qwen-audio-3.1-tts 就是这个结果),格式合法但语义为空,进报表前要能区分"查错了"和"用光了"。
还有一笔值得写进流程:额度显示已用 1346 词元,而四次合成的 total_tokens 相加 444+444+229+229 正好 1346。多出来的一次是辅助脚本在计费调用发出之后崩了,修好重跑等于同一份稿子合成两遍,不退费,只有额度差值能对出来。计费链路之前的语法检查,是省这笔钱的唯一办法。
成本落在哪一侧
同一份 133 字口播稿,模型侧记 253 个计费字符、输出 24.88 秒音频。3.1 折算 0.1554 元/万字符,cosyvoice-v3-flash 挂牌 1 元/万字符,差 6.44 倍;转写同一段音频,3.1-ASR 这一单 0.0004996 元,qwen3-asr-flash 0.00528 元、fun-asr 0.00506 元,与前者分别差 10.57 倍和 10.13 倍;折到每分钟,3.1 是 0.0012 元,另两代都是 0.0132 元。识别 18 族里 paraformer-v2 的目录单价最低(0.00008 元/秒)。
换算里有两个必须记住的系数:按字符收费时一个汉字算 2 个字符(133 字记 253),估预算要翻倍;跨模型的词元数不可比(同一段音频 3.1 记 368 个输入词元、qwen3-asr-flash 记 622 个,密度差 1.76 倍),能进财务报表的只有折回金额之后的数。
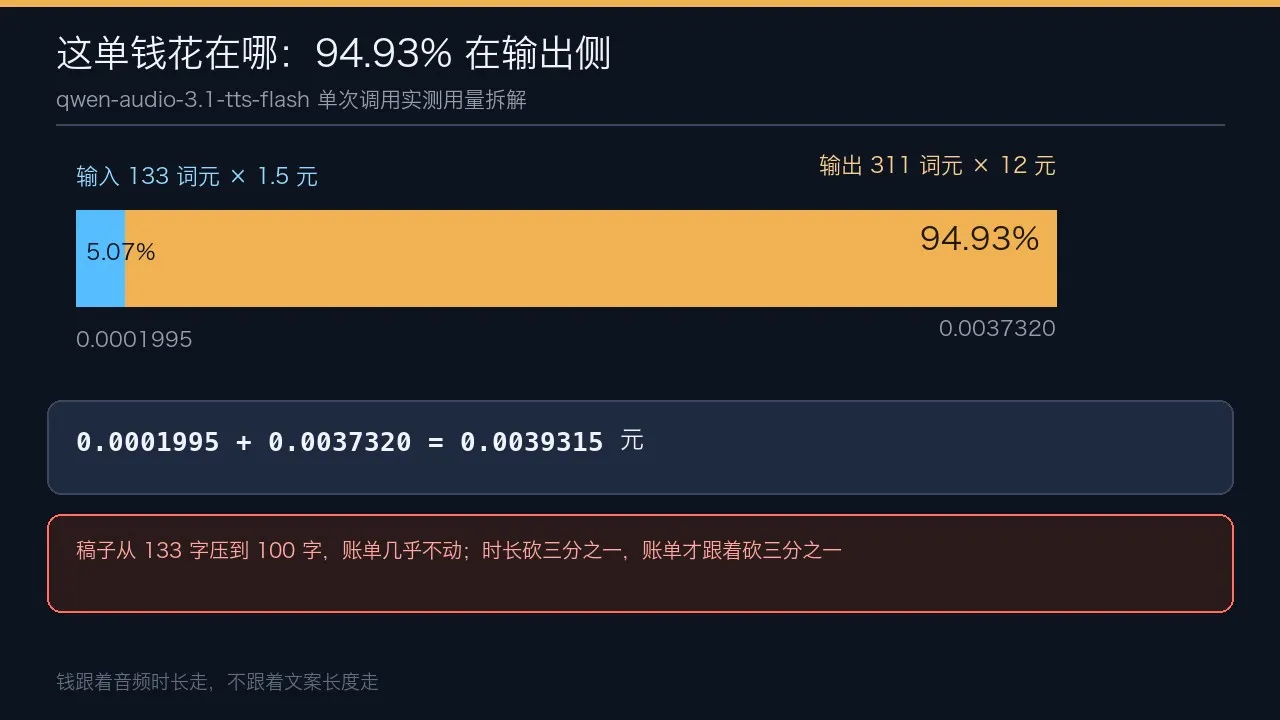
真正决定账单的是输出侧。这一单 94.93% 的钱花在输出词元上:输入 133 词元按 1.5 元/百万计不到一分钱,输出 311 词元按 12 元/百万计,是输入侧的 18.7 倍。稿子从 133 字压到 100 字,账单几乎不动;音频时长砍掉三分之一,账单才跟着砍三分之一。对有声内容、课程配音这类业务,控时长比控文案有效。
预算表里还要留一列给返回时间。同一份稿子,3.1 那一单 2.2 秒返回,cosyvoice-v3-flash 那一单 17.0 秒,差 7.7 倍;识别侧同一段音频三代模型分别用 0.9、0.9、1.7 秒。这一项不印在任何价目表上,却占同一批人力与同一套超时配置:一万条短语音串行跑,两代之间光等就差出约 41 小时。本轮里单价低的与返回快的恰好是同一代模型,两个倍数是分别跑出来的。
落地清单
| 环节 | 动作 |
|---|---|
| 取价 | 目录查询免登录、可定期跑;bl model list --model <版本名> --output json 返回族视图,必须按 items[].model 精确匹配,否则会把 v3.5-flash 的 0.8 元当成 v3-flash 的 1 元 |
| 音色 | --voice 必填,--list-voices 对 3.1 返回"无内置音色列表",按官方音色页核对,3.1 的 ID 带 _v3.1 后缀,模型与音色不可混用 |
| 核账 | 逐单 usage 只走 bl log audit list,额度扣减用 bl usage free 对平 |
| 时长 | CLI 产物 wav 头部帧数失真,wave 读出 44739.24 秒,真实 24.88 秒,按 (1194284-44)/(24000×2) 反算 |
| 重试 | 同稿同音色两次合成产物 MD5 相同,重试不产生额外随机成本 |
| 转写质量 | 方言、噪声、多说话人未测,上线前按自有素材补一轮 |
官方 skill 包与密钥签发是这套流程的两个入口,其余都可以脚本化。
