千问AI平台 OPC 创新计划上线,百万 Token 补贴长期开放
为助推 OPC 生态、加速 AI 原生落地,千问AI平台推出长期补贴计划,一键报名即享至高200元先用后返普惠权益,提交申请可解锁至高 100 万元大额补贴,助力团队实现低成本模型调用。
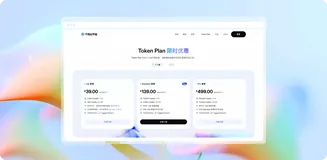
全新 Token Plan 个人版重磅上线
面向个人用户,推出Token Plan 个人版,支持统一订阅与预算管理,仅需一个 API Key,即可无缝调用文本、语音、图像、视频等全模态 AI 能力
Kimi K3 上线千问AI平台,支持长程编程、知识工作与复杂推理
Kimi K3 现已上线千问AI平台。模型拥有 2.8 万亿参数、原生多模态能力和 100 万 token 上下文窗口,面向长程编程、智能知识工作与复杂推理场景。
阿里云消费满返活动解析:AI用量加速计划,新老同享,达量后返,次月最高返还100元
阿里云“AI用量加速计划”面向新老用户推出达量后返福利,最低月实付10元即可参与,最高可享合计100元的百炼券、AI新品券返还,叠加算力券9折优惠,次月20日前发放。返还权益可覆盖AI编程、建站、视频创作等AI应用,全系列大模型订阅服务,以及ECS、轻量应用服务器等算力资源,适配个人开发者到企业客户的全场景用云需求,助力降低长期AI与上云综合成本。
Qwen-Image-3.0-Pro 上线千问AI平台,支持复杂图文排版、精细渲染与图像编辑
Qwen-Image-3.0-Pro 现已上线千问AI平台,支持文生图和图像编辑,可处理最高 4.5K Tokens 指令,支持 12 种语言、20 余种字体和约 10 px 小字渲染,适用于复杂图文排版、真实质感、UI 设计和知识信息图等场景。
Qwen3.8-Flash 上线千问AI平台:全新架构,迈向极致性价比
Qwen3.8-Flash 现已上线千问AI平台,默认提供 100 万 token 上下文并内置官方工具,每 token 仅激活 6B 参数,适合高并发应用、工具驱动的工作流以及编程与协同办公助手。
为什么你的 AI 只会聊天,别人的 AI 能干活?徐全AI 落地三件套拆解 7 个真实场景
飞书+豆包7大场景落地关键,不在模型多强,而在AI真正“看见”工作——读群聊、文档、会议、表格,实现信息汇聚、数据处理与能力沉淀。这正是徐全“AI落地三件套”(指标体检、流程焊点、验收对赌)的生动实践:AI不建新入口,而焊进现有流程,在每一行数据上打工。(239字)
人工智能入门指南:核心定义、工作原理与常见应用场景解析
人工智能是让计算机模拟学习、推理、语言理解和决策的技术。它通过数据学习规律,支撑自动化与智能决策,适合想了解人工智能工作原理和应用场景的读者。
人工智能机器学习与深度学习区别:层级关系与判断标准
人工智能机器学习与深度学习区别,关键在层级关系和学习方式。本文梳理三者定义、深度学习原理与数据处理差异,帮助判断技术边界和适用场景。
卷积神经网络是什么:从视觉模式识别到图像分类的 CNN 入门
卷积神经网络是面向视觉数据的深度学习模型。它通过卷积层、池化层和全连接层自动提取图像特征、识别视觉模式,帮助入门理解图像分类、目标检测和使用判断。
自然语言处理:一文看懂 NLP 定义、工作原理与应用场景
自然语言处理是让计算机理解、生成和处理人类语言的 AI 分支。它结合计算语言学、机器学习和深度学习分析文本与语音,适合了解文本分析、信息提取和应用场景。
Transformer 原理详解:从定义、结构到工作流程
Transformer 是处理序列数据的神经网络架构。它通过多头自注意力追踪元素关系,并可采用编码器-解码器结构,适合理解机器翻译和序列建模基础。
神经网络入门指南:一文看懂基本定义、工作原理与应用场景
神经网络是受人脑启发的机器学习方法。它通过分层节点、隐藏层和激活函数学习权重与偏置,建立输入到输出的映射,帮助理解图像识别与自然语言处理场景。
循环神经网络 RNN:理解序列数据建模的原理与应用
循环神经网络 RNN 是处理顺序数据的深度学习模型。它通过循环结构和隐状态利用先前输入信息,适合理解自然语言处理、时间序列分析与序列数据建模。
生成式 AI 是什么:从基本定义到工作原理和应用场景
生成式 AI 是根据提示生成原创内容的人工智能。它依托机器学习模型和大语言模型创建或转换文本、图像、音频、视频与代码,适合用于内容创作、沟通表达和任务辅助。
决策树、随机森林与支持向量机区别:原理对比与选择标准
决策树、随机森林与支持向量机对比用于理解三类机器学习算法。围绕特征划分、输出整合、决策边界和模型复杂度,帮助初学者建立算法选择思路。
大模型基础概念:Token、参数和上下文窗口
Token、参数和上下文窗口是理解大模型输入、输出与调用限制的基础概念。本文说明 Token 序列、采样参数和上下文窗口限制,帮助入门读者规划大模型调用。
大语言模型入门:LLM 定义、原理与应用场景
大语言模型是基于大量数据训练或预训练的深度学习模型。它通过 token 预测和 Transformer 自注意力理解并生成文本,帮助读者梳理 LLM 原理、能力与应用场景。
大语言模型如何工作:从分词嵌入到转换器逐词元生成流程
大语言模型如何工作,关键在于海量数据预训练、提示词分词、嵌入向量和转换器处理。它会逐词元生成内容,适合理解文本生成、翻译和代码生成机制,以及自然语言处理任务的基本原理。
人工智能发展历史:关键节点、技术路线与应用场景
人工智能发展历史是理解 AI 定义、技术路线和应用边界的入口。本文梳理 1956 年达特茅斯会议以来的关键节点,说明学习、推理、问题解决机制及典型应用场景。
生成式 AI 与预测式 AI 的区别:定义、机制与选择标准
生成式 AI 与预测式 AI 的区别,核心在于生成内容还是预测结果。梳理输出方式、工作机制、透明度与适用场景,帮助判断应选择哪类 AI。
基础模型原理详解:预训练机制、通用能力与应用场景
基础模型是基于海量数据预训练的通用 AI 模型。通过自监督学习掌握复杂模式和关系,可作为专业应用底座,适合理解多任务能力、自定义部署与企业智能应用建设。
大模型评测 Benchmark:关键指标与选型方法
大模型评测 Benchmark 是用数据集和评测维度量化模型能力的方法。本文梳理推理结果打分、吞吐量、延迟与 token 级指标,帮助研发和业务团队完成模型对比与选型。
RAG 是什么:检索增强生成的核心原理、工作流程与应用场景
RAG 是用外部知识补充大语言模型生成的技术。RAG 工作流程通常包括数据准备、检索和生成,把权威知识放入模型上下文,适合判断何时接入私有数据或知识库。
企业大模型选型实战教程:从任务目标到调优部署与知识库应用
企业大模型选型是围绕任务目标匹配合适 LLM 的过程。说明 LLM 定义、Transformer 基础、模型选择、调优与部署机制。帮助企业在知识库智能问答等场景形成可执行路径。
提示词工程:定义、工作原理与典型应用场景系统讲解
提示词工程是设计和优化 Prompt 的方法,用于把任务意图清楚传给大模型。它通过上下文补充与输出格式约束改善回答相关性,适合 AI 应用开发、内容生成和研究辅助。
小语言模型与大语言模型对比:定义原理、应用场景与选择标准
小语言模型是大语言模型的精简版本,可处理、理解和生成自然语言。说明 SLM 与 LLM 的规模、知识范围、效率和资源消耗差异,帮助在专业任务与通用生成场景中选择适用模型。
开源模型与闭源模型区别:企业应用中的差异维度与选型框架
开源模型与闭源模型是 AI 大模型的两种技术模式。本文从开放程度、模型优化灵活性、AI 生态建设和商业定位拆解差异,帮助建立大模型选型框架。
混合专家模型 MoE 原理:专家路由、稀疏激活与大模型扩展机制
混合专家模型 MoE 是通过多个专家网络协同计算的模型架构。它依靠专家路由和稀疏激活控制单次计算量,适合理解大模型扩展、AI 推理效率与密集模型差异。
Embedding 是什么:从向量表示到语义应用场景
Embedding 是把文本、图像、音频等数据转换为数值向量的方法。它通过向量空间位置和距离表达语义相关性,帮助构建语义搜索、推荐、聚类、分类和异常检测应用。
向量数据库是什么:向量嵌入、语义搜索与 AI 应用
向量数据库是存储、管理和搜索向量嵌入的数据系统。它将文本、图像、音频转为数值表示,支持语义相似度搜索。适合 AI 检索、推荐与智能问答入门。
企业知识库问答系统实战教程:从知识整理到助理发布全流程
企业知识库问答系统是基于企业私域数据回答问题的 AI 应用。文章梳理知识库构建流程、RAG 关键环节与上线检查,适合客服、内部查询和特定领域问答。
RAG 系统原理详解:从知识检索到回答生成
RAG 系统通过外部知识库增强大语言模型回答。它以数据准备、检索和生成串起流程,将用户问题与相关资料合并后交给模型,帮助读者理解工作原理、价值和适用场景。
RAG、微调与提示工程区别:LLM 应用如何选择
RAG、微调与提示工程是优化 LLM 应用的三类方法。本文围绕 RAG 与微调区别,说明提示工程引导输出、RAG 接入检索信息、微调调整参数,帮助选择优化路径。
AI 记忆与长期记忆入门:智能体上下文保留机制
AI 记忆是智能体存储和回忆过往经验的能力。它通过长期记忆体、记忆片段等机制保留上下文。适合理解跨会话个性化、Coding Agent 提效与应用设计。
GraphRAG 是什么:知识图谱增强 RAG 入门
GraphRAG 是结合 RAG 与知识图谱的检索增强生成方法。它用图结构组织实体关系和问答上下文,适合理解 GraphRAG 与 RAG 的区别、复杂数据问答和主题发现。
Function Calling 原理详解:工具调用机制与应用
Function Calling 是让大模型调用 API、数据库或自定义函数的机制。模型依据用户意图进入工具调用流程,也可在特定流程中强制调用,适合开发者理解应用场景与边界。
混合检索与关键词、向量检索区别:原理、融合方式与选择标准
混合检索是融合关键词检索与向量语义检索的信息检索架构。通过统一排序、稀疏与稠密向量、RRF 或加权融合提升相关性,适合 RAG 和站内搜索。
Rerank 原理详解:提升 RAG 检索效果的关键步骤
Rerank 是在 RAG 初步召回后重排候选文档的方法。它通过相关性评分优化排序,并可配合混合检索、元数据筛选,用于知识库问答。
对话式 AI、聊天机器人与 AI Agent 的区别及选型要点
对话式 AI 是理解并回应自然语言的交互能力。本文拆解聊天机器人、AI 助手与 AI Agent 的工作层级、自主性和选型标准,帮助客服与自动化任务避免概念混用。
RAG 系统评测指标详解:流程与常见问题
RAG 系统评测是用指标描述检索增强生成性能的方法。围绕 RAG 评测指标、合成评估数据集、LLM-as-a-judge 与黑盒输入,帮助团队明确流程边界和复盘重点。
AI Agent 是什么:定义、工作流程与应用判断
AI Agent 是能感知环境、自主决策并执行任务的软件实体。它围绕目标接收任务、推理规划、调用工具并动态调整,帮助读者理解 AI Agent 工作流程、原理与应用判断。
AI Agent 如何工作:从定义到自主行动闭环
AI Agent 如何工作是理解智能体的关键。它结合基础模型、工具调用与反馈循环,说明系统如何从用户目标走向行动,帮助产品、研发和业务人员建立判断框架。
Agentic RAG 是什么:智能体如何增强检索生成
Agentic RAG 是智能体检索增强生成,通过智能体协同、工具选择和查询细化改进传统 RAG 流程,适合理解复杂知识库问答、文档摘要和多步骤分析场景。
模型上下文协议 MCP:连接大模型与外部工具的标准通信通道
模型上下文协议 MCP 是连接大模型与外部工具的开源协议。它以客户端-服务器架构实现标准化双向通信,降低多工具集成复杂度,帮助判断 AI 应用何时需要统一连接通道。
AI偏见、公平性与可解释性:从定义到实践核心方法
AI偏见、公平性与可解释性用于识别模型偏差并说明决策依据。结合特征归因、样本说明和公平性分析,帮助开展模型偏差检测与高影响 AI 决策评估。
千问AI平台
千问AI平台,提供全模态 AI 大模型、 Skills & CLI 工具链及AI 原生应用开发,为企业与开发者提供高效、稳定、高性价比的 AI 基础设施与 API 接入服务。