开源大数据平台 E-MapReduce
阿里云EMR是云原生开源大数据平台,为客户提供简单易集成的Hadoop、Hive、Spark、Flink、Presto、ClickHouse、StarRocks、Delta、Hudi等开源大数据计算和存储引擎,计算资源可以根据业务的需要调整。EMR可以部署在阿里云公有云的ECS和ACK平台。
为什么选择ali-E-MapReduce
E-MapReduce是构建于阿里云ECS弹性虚拟机之上,利用开源大数据生态系统,包括但不限于Hadoop、Spark、Hbase,为用户提供集群、作业、数据等管理的一站式大数据处理分析服务。我们提供的软件基本都是开源的软件,会有一些性能的优化,但是绝对不引入任何不兼容的改动。
阿里云EMR Serverless StarRocks 内容合集
阿里云 EMR StarRocks 提供存算分离架构,支持实时湖仓分析,适用于多种 OLAP 场景。结合 Paimon 与 Flink,助力企业高效处理海量数据,广泛应用于游戏、教育、生活服务等领域,显著提升数据分析效率与业务响应速度。
体验 Serverless StarRocks × Paimon (DLF) 查询 TPC-DS 标准库性能
本文介绍如何通过共享TPC-DS样例数据集,创建并绑定DLF Catalog到StarRocks实例,实现高效数据查询与分析。内容涵盖RAM用户授权、外部Catalog连接、性能测试(如TPC-DS Query 3)、数据写入内外表、物化视图构建数仓DWD-ADS层,以及通过Quick BI进行可视化报表展示的完整流程,助力快速搭建湖仓一体架构。
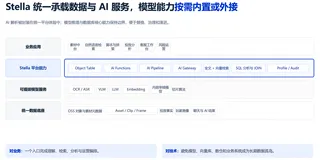
EMR Serverless StarRocks AI Function新能力亮点与解读
阿里云 EMR Serverless StarRocks 发布 AI Function,将多模态 Embedding、AI 聚合及向量混合检索原生融入 SQL 链路。支持图片/视频/文本统一向量化、自然语言过滤及跨行语义汇总,无需外部向量库。架构上采用异步 Pipeline、资源有界控制及多账号 AI 网关,保障高吞吐与稳定性。通过“数据不搬家”实现极简运维,广泛应用于广告素材闭环、游戏聊天分析及金融 RAG 场景,构建生产级 AI 数据计算体系。
在 EMR Serverless Ray 作业中使用 Checkpoint 断点续跑
本文介绍了在 EMR Serverless Spark 的 Ray 作业中通过 Ray Data Checkpoint 实现断点续跑的方法,适用于输入可重读、记录独立处理且 ID 稳定唯一的长时批量任务(如推理、预处理),核心是记录已提交记录 ID 并在恢复时过滤跳过,从而避免重复计算与写出,显著节省失败重提的资源开销;内容涵盖路径准备、代码配置、提交流程及关键注意事项,并澄清了 checkpoint 的适用边界与常见误区。