这是一次个人使用中的日志习惯总结。即使模型、提示词和渠道看起来都一样,我也不会只保存一次“成功样本”,因为单次请求无法反映输出长度、缓存状态和偶发失败的变化。
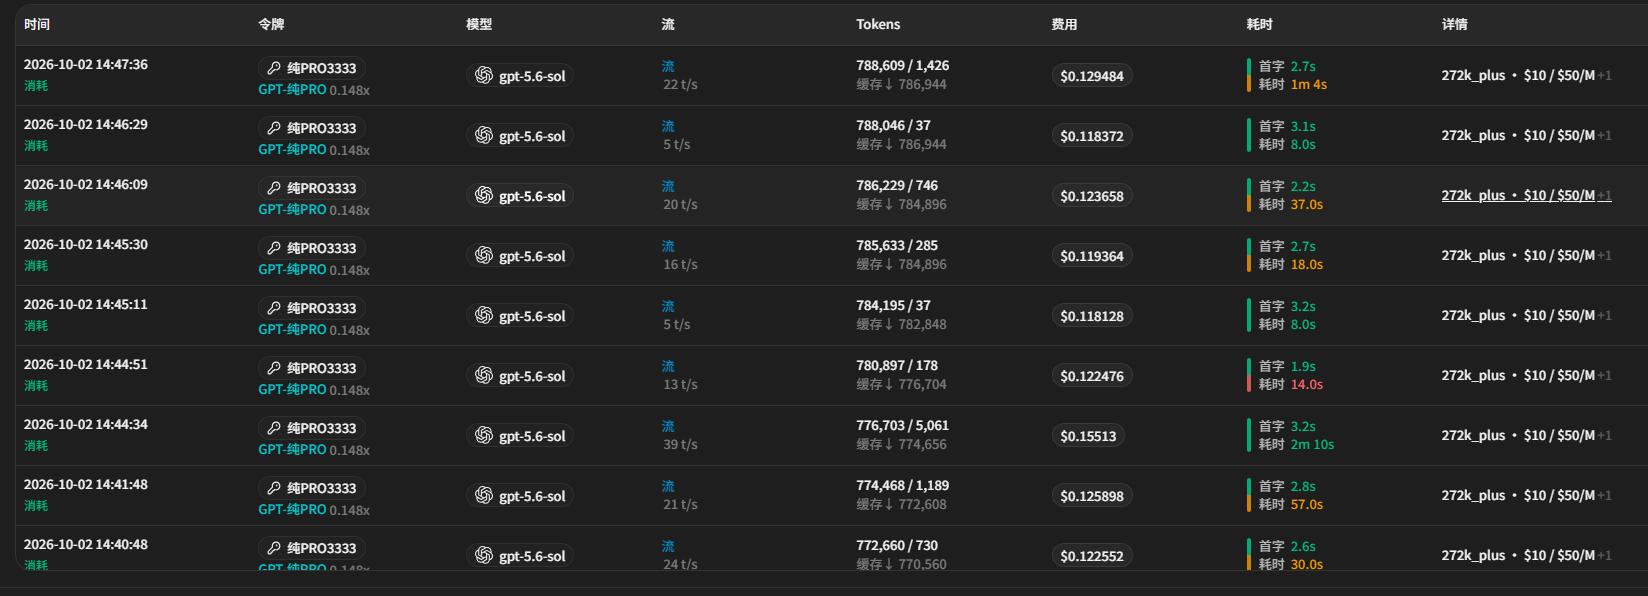
我会连续保存几次相似请求,比较:
例如,输入总量接近的请求,可能因为输出长度不同而有完全不同的总耗时。一次快、一次慢,不一定是模型本身变了,也可能是任务结果长度不同。
当累计调用数、Token 或额度出现异常增长时,我会先从统计页发现趋势,再回到具体请求检查是哪一类任务贡献了变化。统计汇总不能代替日志,但能节省定位范围的时间。
多次记录的价值,还在于让我对结论保持克制。一次低费用、一次较快首字或一次成功率很高的截图,都只能说明样本发生过什么。只有持续、同条件的记录,才适合用于自己的项目决策。
本文是个人日志和调用统计的使用方法整理,截图数据属于 2026 年 10 月 2 日的样本,实际表现需要按自己的任务持续验证。
版权声明:本文内容由阿里云实名注册用户自发贡献,版权归原作者所有,阿里云开发者社区不拥有其著作权,亦不承担相应法律责任。具体规则请查看《阿里云开发者社区用户服务协议》和《阿里云开发者社区知识产权保护指引》。如果您发现本社区中有涉嫌抄袭的内容,填写侵权投诉表单进行举报,一经查实,本社区将立刻删除涉嫌侵权内容。