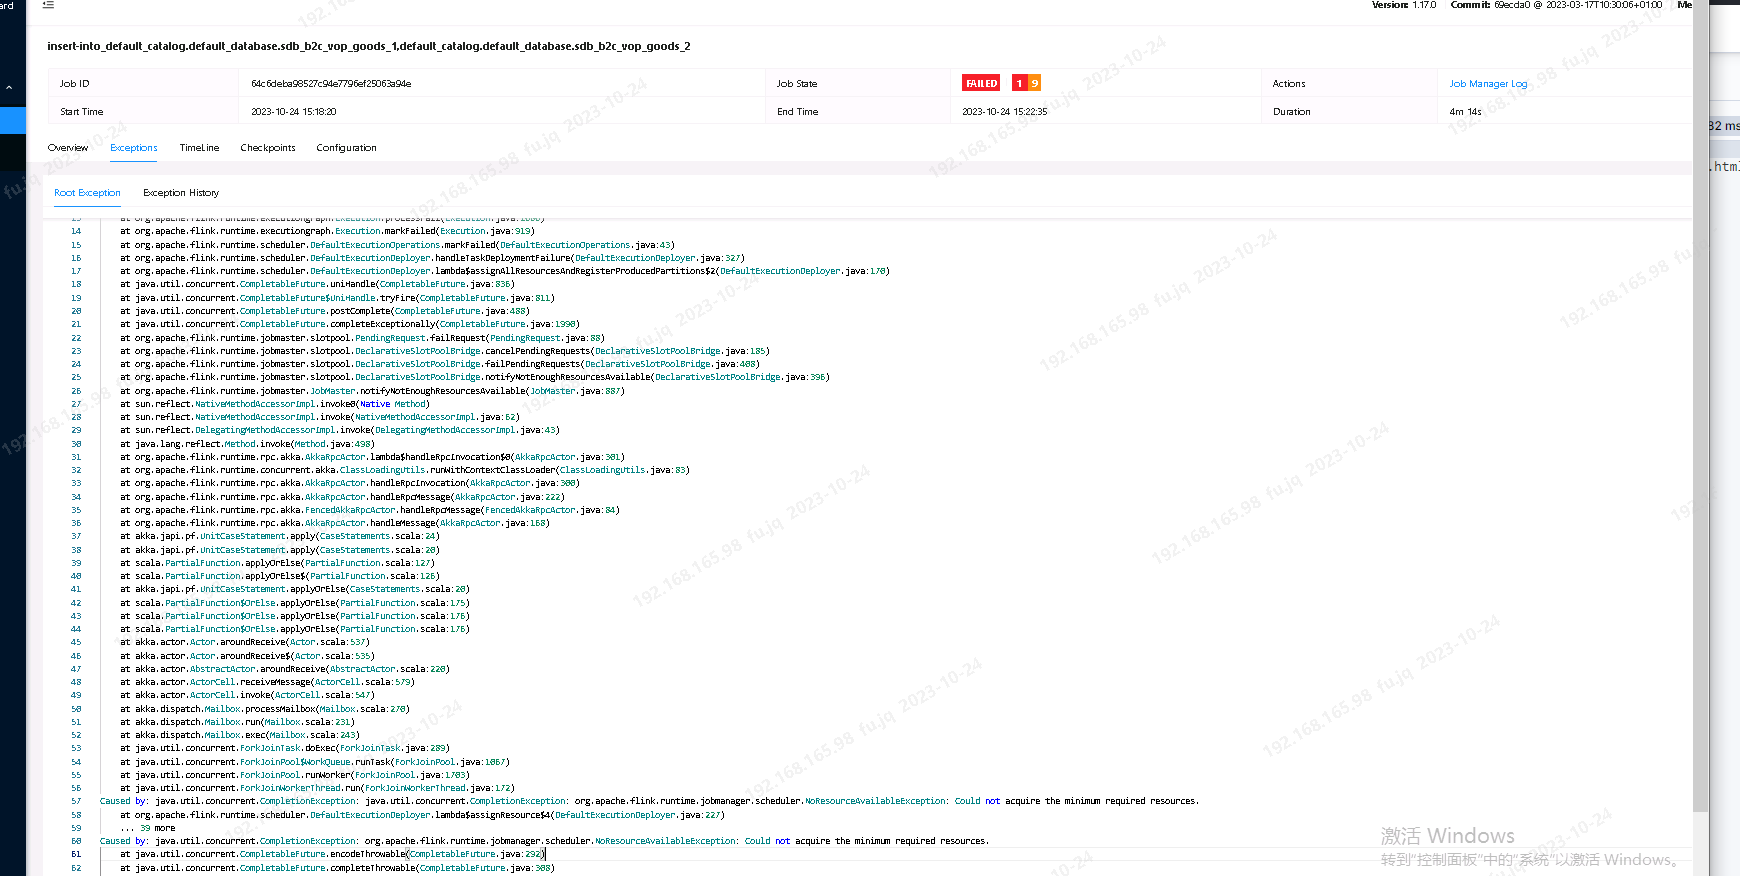
Flink CDC这个怎么搞?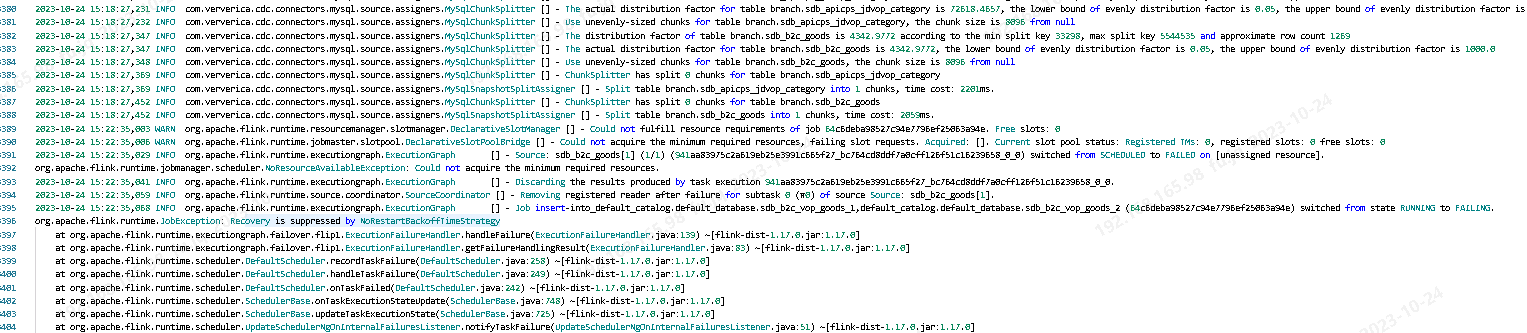
这给了4000m还不够啊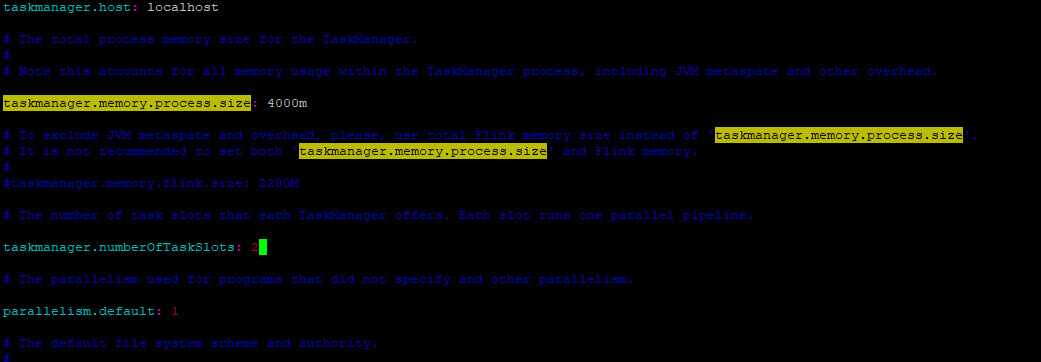
版权声明:本文内容由阿里云实名注册用户自发贡献,版权归原作者所有,阿里云开发者社区不拥有其著作权,亦不承担相应法律责任。具体规则请查看《阿里云开发者社区用户服务协议》和《阿里云开发者社区知识产权保护指引》。如果您发现本社区中有涉嫌抄袭的内容,填写侵权投诉表单进行举报,一经查实,本社区将立刻删除涉嫌侵权内容。
Flink CDC(Change Data Capture)是一种基于数据库日志(如MySQL的Binlog或PostgreSQL的WAL)捕获数据变更的技术,能够实现全量和增量数据的一体化同步。针对您提到的“4000m内存不够”的问题,以下是一些可能的原因及解决方案:
增加并发度:
'scan.parallelism' = '4' -- 根据实际需求调整并发度
注意:并发度过高可能会对MySQL数据库造成额外压力,请根据实际情况权衡。
分片读取:
table-name正则表达式匹配多个表,并为每个表分配独立的TaskManager进行处理。缩短Checkpoint间隔:
'execution.checkpointing.interval' = '60s' -- 设置为60秒
注意:过短的Checkpoint间隔可能会增加系统开销,请根据实际负载调整。
启用增量Checkpoint:
'execution.checkpointing.incremental' = 'true'
scan.startup.mode参数控制启动模式:
'scan.startup.mode' = 'latest-offset' -- 从最新的Binlog位点开始消费
注意:此方式会跳过历史数据,仅适用于增量同步场景。
复用Source连接:
server-id来复用Source连接,减少对MySQL的压力。'server-id' = '5401' -- 确保不同作业使用相同的server-id
将数据同步到Kafka:
currentEmitEventTimeLag指标,判断是否已完成全量数据同步。如果该指标大于0,表示已进入增量阶段。BinlogSplitReader is created日志,确认是否成功完成全量数据读取。以下是一个完整的Flink CDC配置示例,包含全量和增量同步的优化参数:
CREATE TABLE mysql_source (
    id INT,
    name STRING,
    update_time TIMESTAMP(3)
) WITH (
    'connector' = 'mysql-cdc',
    'hostname' = 'your-mysql-host',
    'port' = '3306',
    'username' = 'your-username',
    'password' = 'your-password',
    'database-name' = 'your-database',
    'table-name' = 'your-table',
    'server-id' = '5401',
    'scan.parallelism' = '4',
    'scan.startup.mode' = 'initial', -- 初始模式,读取全量+增量
    'execution.checkpointing.interval' = '60s',
    'execution.checkpointing.incremental' = 'true'
);

CREATE TABLE sink_table (
    id INT,
    name STRING,
    update_time TIMESTAMP(3)
) WITH (
    'connector' = 'kafka',
    'topic' = 'your-topic',
    'properties.bootstrap.servers' = 'your-kafka-broker',
    'format' = 'json'
);

INSERT INTO sink_table SELECT * FROM mysql_source;
通过以上优化措施,您可以有效缓解Flink CDC作业的内存不足问题。如果问题仍然存在,建议结合具体场景进一步分析,或联系阿里云技术支持获取帮助。
实时计算Flink版是阿里云提供的全托管Serverless Flink云服务,基于 Apache Flink 构建的企业级、高性能实时大数据处理系统。提供全托管版 Flink 集群和引擎,提高作业开发运维效率。