其实一直想写这个主题,只是最近事有点多。按照向下兼容的特性来说,大数据治理和数据治理应该是没有差别的。但从本质而言,传统数据库的模式是Schema on Write,即在写入数据前先要定义Schema,包括了数据库的表、视图、存储过程、索引等,每个数据库条目都有自己的血缘关系(Lineage),基于角色或栏的访问控制,变更日志等等,这些内容在跨系统数据传输或转置时必须定义明确,因为在数据流的每个入库阶段都可能改变原始数据。
尤其数据的血缘关系梳理是非常困难的事情。举个例子来说,最初的数据录入是在MySQL库中,进入数仓(比如Oracle)就会有数据结构的变化;数仓中还会有内置的SQL描述规范,数据需要转置;接下来进入BI工具(比如MicroStrategy)又会对数据造成改变;最后一些可视化工具(比如Tableau)又会对数据进行分类汇总。因此在传统数据治理中,通常需要有数据核验官或QA记录下在每一个数据流的落地环节,原始数据做了哪些变化与调整,并且在原始数据结构(Schema)发生变化的时候,更新其后的每一个环节的描述文档。
而大数据治理是Schema on Read的模式,即在采集各类数据时不需要定义各种数据库对象,我们甚至不知道哪些数据是今后用得上的。毕竟数据就是企业的资产,现在不做统计不代表它没有价值,只是在当前阶段不需要定义Schema而已。
由于整个采集存储过程没有涉及到任何转置,原始数据没有因为需要结构化或匹配差异系统而遭到破坏,数据的血缘关系是非常清楚的,因此在大数据治理中不需要考虑数据流的各个环节。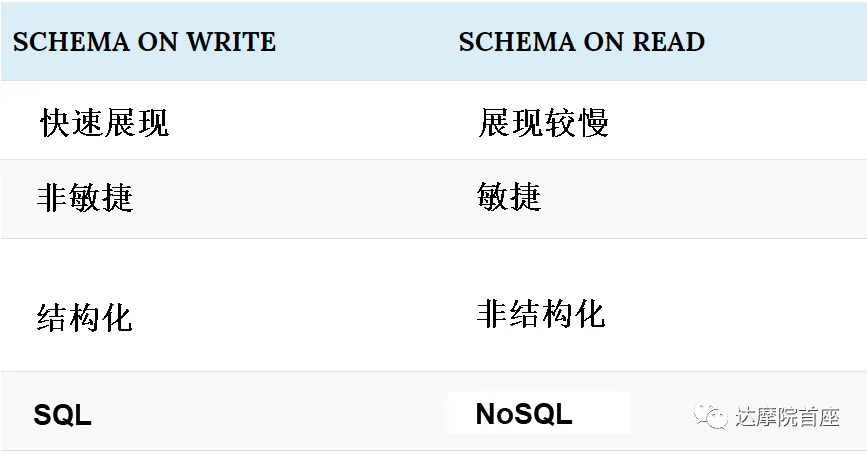
通常我们理解的大数据(非结构化)主要来自以下终端:
- 移动设备:包括平板与智能手机,内容有图片、视频、Po文、GPS位置信息等;
- 网站:包括流量分析,用户点击操作以及在线行为数据;
- 社交媒体:包括微博、微信、领英...
- 传感器设备:包括RFID射频识别、条形码、智能设备数据
- 企业:包括Web日志、应用日志、系统日志..
一般企业不可能一夜之间完成数据架构的转型,而是在原数仓基础上会逐步引入Hadoop,Spark等开源组件,对于这些企业来讲,大数据治理无非在原有治理框架下添加了新的业务和IT职能模块(下图绿色部分)。
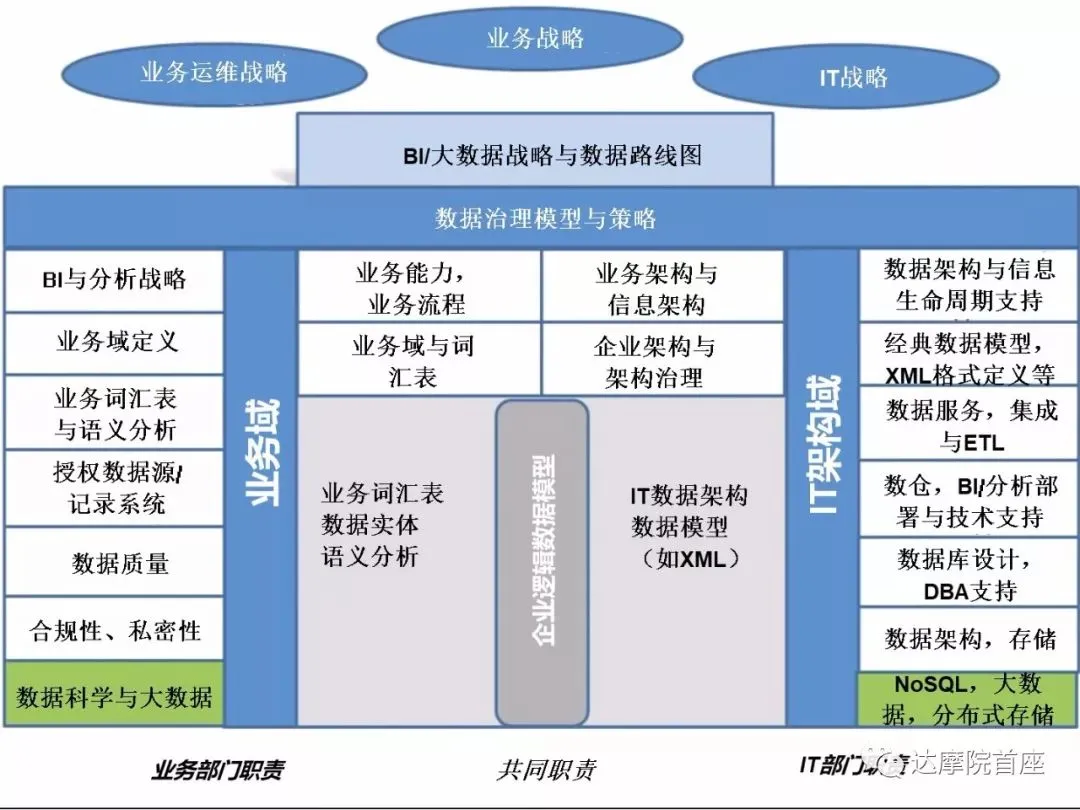
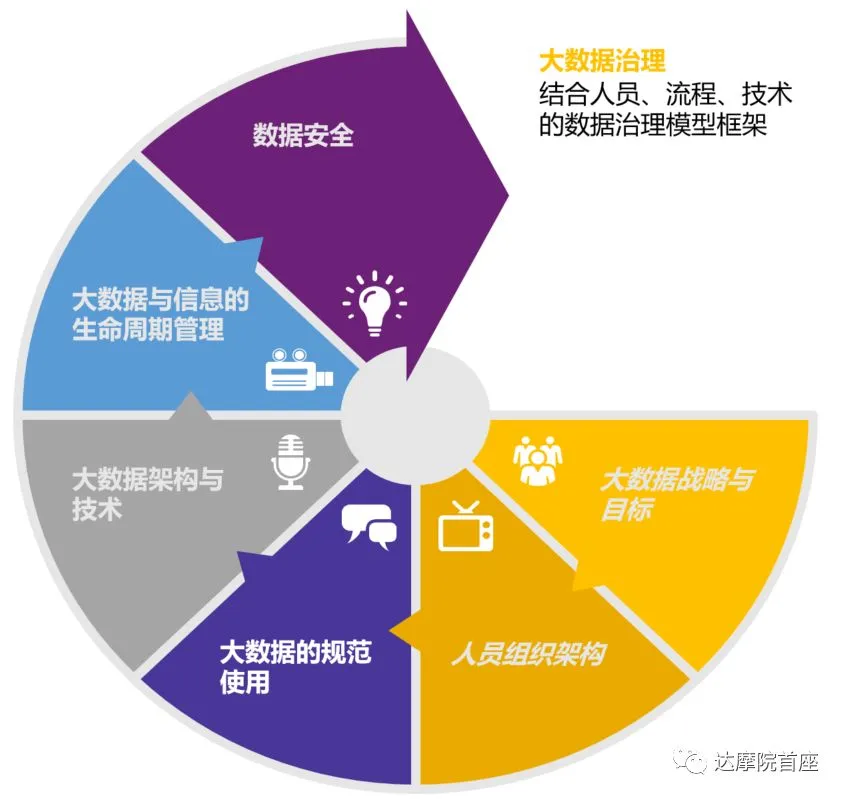
关于新增的大数据治理部分主要分为以下- 六个领域:
- 首先是大数据战略与目标:在这一领域内需要定义业务目标;通过大数据的应用期望实现的业务价值;投入总成本TCO与回报率ROI;战略执行时间线以及评价指标;另外企业必须理解大数据技术发展迅速,上线前必须有POC阶段。
- 第二是人员组织建设:按照上图的职责分工,大数据职能该放置在业务、IT还是共享服务;数据科学家该放在什么部门,PMO还是业务部门;数据科学家的内部职级序列;谁来定义大数据的使用标准;大数据如何在业务与IT之间保持连贯性。
- 第三就是上面说到的大数据的规范使用:包括企业中大数据分析岗的角色设立以及大数据的分f析目标(是放在近期目标还是未来的机会领域);谁来评估分级大数据资产;新的数据消费者与数据生产者的动态关系以及数据管理流程须清楚明晰;新的大数据资产的生命周期管理;哪些外部数据有必要采集进来。
- 第四是大数据架构与技术:大数据架构与技术是丰富多样的,企业需要建立一个参考模型来监控新技术与工具,当然密切关注开源社区也能获得产品更新的一手资料;鼓励POC与灰度测试,不用急于明确企业数据标准;工具与技术的人员培训;处理NoSQL的关系型假设;需要注意的还有传统的存储架构在面临大数据的海量吞吐与多样性是的表现情况。
- 第五是大数据与信息的生命周期管理:大数据是辐射端到端信息管理全生命周期的,因此大数据战略下的数据保留策略也不得与法务、合规以及可靠性的要求相悖离;同样如前面提到的大数据是Schema on Read的模式,企业在不明确未来规划的前提下能否承受尚未使用的大数据所带来的存储负担;大数据在IT运维,备份/归档,灾难恢复等传统IT领域的影响。
- 最后的规划领域是数据安全:即对大数据集(扫一下盲,数据库是物理概念,数据集是逻辑概念即针对某一个业务目的的数据整体)和数据查询结果的所有者须有明确定义;匹配大数据的数据安全即数据访问策略的更新;如何解决数据私密性与合规风险;对于大数据项目下的第三方数据集如何管理访问规则。
从大数据治理的规划路线上,本座还是坚持以从上至下的推进方式,例如:
- 签发企业大数据与数据科学战略;
- 调整组织模型,定义大数据岗/部门和数据科学岗/部门职责;
- 定义与业务目标相匹配的大数据资源使用策略和执行文档;
- 定义大数据参考模型,参考架构及技术监控框架;
- 检查企业中现有数据的结构化假设是否有潜在问题,是否可以通过NoSQL及其他大数据工具替换原来受技术限制的RDBMS解决方案;
- 延伸现有的治理模式,完善企业大数据治理模型,并同步更新企业的信息标记语言(IML);
- 快速开展企业大数据与数据科学项目,从POC开始并积极寻找到业务赞助方。