Azure Data Explorer 指南
Azure在2018年推出了Data Explorer产品,提供实时海量流数据的分析服务(非流计算),面向应用、网站、移动端等设备。
用户可以查询,并交互式地对结果进行分析,以达到提升产品、增强用户体验、监控设备、用户增长等目的。其中提供一些机器学习函数,能够进行异常、模式识别、并且发现数据中的趋势。
该服务面向秒-分钟级拿到结果的场景,类OLAP,对TP场景不敏感。
产品起源
Azure Data Explorer(ADE)内部代号叫Kusto,在Kusto之前,Azure对监控和分析场景散落在各产品中,例如:Log Analytics、Application Insight,Azure Monitor,Time Series Insight,这些产品在用不同的技术架构来解决不同数据源等问题,例如:
- 通过PerfCounter和Event通过流数据进行聚合告警
- 利用通用计数器写入时序数据库,配置实时Dashboard
- 把应用数据写到数仓做深入分析
ADE的目标是对上层预定义计算、后计算做一层抽象:将原始数据进行通用存储,保留一段时间(例如几个月),对这些多样化数据进行快速的多维分析。
ADE在微软的内部代号为Kusto,由以色列研发团队提供。Azure Log Analytics开始选型是Elastic Search,每年付1M$用来获得支持,但效果不好,因此在2015年时对日志、Metric场景使用Kusto来提供,包括之前在cosmosDB中的分析工作。

截止 September 2018 的数据:
- hundreds of teams within Microsoft
- 41 Azure regions as 2800 Engine+DM cluster pairs
- about 23000 VMs.
- overall data size stored in Kusto and available for query is 210 petabytes
- 6 petabytes ingested daily.
- around 10 billion queries per month.
可以推测平均存储时间为:210 (PB) / 6 (PB) = 35 天
产品定义
面向数据类型是Immutable Data,特点是AppendOnly,并且大部分都是Semi-Structure Data,例如User Click Log,Access Log等。Big Data理论中90%都是这类数据,这也是Big Data理论数字化并洞察物理时间的基础。
从Facebook等数据来看,2017年时每天用户产生的视频(UGC)大约在10PB,但用户点击产生的日志量已经远远超过10PB这量,对视频网站而言,内容数据增量少于点击日志的增量已成为通用的规律。

Azure在宣传时这样定义自己的产品:

fast, fully managed data analytics service for real-time analysis on large volumes of data streaming from applications, websites, IoT devices, and more.
产品主要解决三类问题:
- Customer Query (Advance Hunting)
- Interactive UI (前者封装)
- Background Automation(定时任务)
也有一些解释基于几个交互式产品来解释:底层是实时OLAP,上层是Jupiter(交互式) + Kibana(可视化)

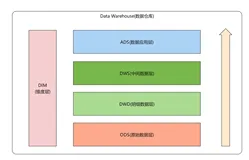
从产品定位角度考虑,ADE处于中间层次(利用人的交互式分析能力进行发掘与探索):
- integrates with other major services to provide an end-to-end solution
- pivotal role in the data warehousing flow by executing the EXPLORE step of the flow on terabytes of diverse raw data

除此之外ADE(Kusto)是
- azure application insight, log analytics 基础
- 为Azure Monitor, Azure Time Series Insights, and Windows Defender Advanced Threat Protection提供数据服务
- 提供REST API, MS-TDS, and Azure Resource Manager service endpoints and several client libraries
数据模型与API
ADE以实例方式给用户付费,用户购买一组实例后可以创建:
- Database
- Table:存储实例,包含Schema(表结构和字段类型),Mapping(如何从CSV、Avro等格式映射)
- Functions:自定义函数,利用scalar语言可以定义自定义方法,方便后期处理

整个API只有一组接口,通过类KQL方法来管理控制流与数据流,控制流以"."作为开头,例如 ".create table"。数据分析语言除了KQL外还支持SQL:
- TSQL:https://docs.microsoft.com/en-us/azure/kusto/api/tds/t-sql
- KQL:https://docs.microsoft.com/en-us/azure/kusto/query/index
以下是一些案例:
创建:
.create table MyLogs ( Level:string, Timestamp:datetime, UserId:string, TraceId:string, Message:string, ProcessId:int32 )

创建或追加:
.create-merge tables MyLogs (Level:string, Timestamp:datetime, UserId:string, TraceId:string, Message:string, ProcessId:int32), MyUsers (UserId:string, Name:string)

.alter column ['Table'].['ColumnX'] type=string
更改列行为后,之前数据会变成Null,建议把数据筛选出来写入新的Table

映射关系:
.create table MyTable ingestion csv mapping "Mapping1" '[{ "Name" : "rownumber", "DataType":"int", "Ordinal" : 0},{ "Name" : "rowguid", "DataType":"string", "Ordinal" : 1 }]’
.create table MyTable ingestion json mapping "Mapping1" '[{ "column" : "rownumber", "datatype" : "int", "path" : "$.rownumber"},{ "column" : "rowguid", "path" : "$.rowguid" }]'
数据写入(ingestion)与导出(Export)
数据写入有三种方式:
- 其他数据源,例如CSV(Event Hub等)
.ingest into table T ('adl://contoso.azuredatalakestore.net/Path/To/File/file1.ext;impersonate') with (format='csv’)- 通过Query从一个Table输出 ,有四种模式(set, append, set-or-replace, set-or-append),提供异步接口
.set RecentErrors <| LogsTable | where Level == "Error" and Timestamp > now() - time(1h)- Inline方式,直接通过算子生成
.ingest inline into table Purchases <| Shoes,1000 Wide Shoes,50 "Coats, black",20 "Coats with ""quotes""",5数据导出有2个大类:
- 导出到存储(Storage):
.export async compressed to csv ( h@"https://storage1.blob.core.windows.net/containerName;secretKey", h@"https://storage1.blob.core.windows.net/containerName2;secretKey" ) with ( sizeLimit=100000, namePrefix=export, includeHeaders=all, encoding =UTF8NoBOM )
<| myLogs | where id == "moshe" | limit 10000- 导出到另外一个表(Table):
.export async to sql MySqlTable
h@"Server=tcp:myserver.database.windows.net,1433;Database=MyDatabase;Authentication=Active Directory Integrated;Connection Timeout=30;"
<| print Id="d3b68d12-cbd3-428b-807f-2c740f561989", Name="YSO4", DateOfBirth=datetime(2017-10-15)
控制流
Cursor 概念
数据导入时会有一个区块的概念,代表同一批数据,其中会有一个顺序的游标(Cursor),类似Kafka中每个Partition中数据唯一的位置。通过Cursor可以获得数据的唯一位置,Cursor以Ingestion Time为主(与字段无关),如果需要使用Cursor功能必须打开IngestionTime这个Feature。
以下例子就表示再倒入前后获取到某一个Cursor,在写入某些数据后,可以通过Cursor打印出当前位置后的数据。
.set table Employees policy ingestiontime true

Employees | where cursor_after('')

Employees | where cursor_after('636040929866477946') // -> 636040929866477950
Employees | where cursor_after('636040929866477950') // -> 636040929866479999
Employees | where cursor_after('636040929866479999') // -> 636040939866479000
系统管理与控制
提供状态查询,就不赘述了:
- Diagnostics(Cluster Status,Capacity)
- Journal(metadata operations performed on the Kusto database)
- Queries(.show running queries )
- Commands
- Commands and Queries
- Ingestion Failure
当前支持角色
| Role | Permissions |
|---|---|
| Database admin | Can do "anything" in the scope of a particular database. |
| Database user | Can read all data and metadata of the database; additionally, can create tables (thus becoming the table admin for that table) and functions in the database. |
| Database viewer | Can read all data and metadata of the database. |
| Database ingestor | Can ingest data to all existing tables in the database, but not query the data |
| Database unrestrictedviewer | Can query all tables in the database which have the RestrictedViewAccess policy enabled. |
| Database monitor | Can execute .show commands in the context of the database and its child entities. |
| Table admin | Can do anything in the scope of a particular table. |
| Table ingestor | Can ingest data in the scope of a particular table, but not query the data. |
DataShard(extent 管理)
由于是列存储系统,数据写入时都以一大段数据DataShard(Extent)方式来组织。每个Table由若干Extent组成,每一批导入数据都为一个Extent。

每个Extent:
- 都是immutable,不可更改
- 由一系列定义好的列组成
- 每个列存储可以切分为Segments,Segments由Block组成

Extent有如下属性:
- Ingestion Time:代表生成时间,生命周期后的回收也以该时间为准
- Retention:生命周期,先写入的Extent会被先回收
- Extent有Cache能力,可以设置:默认Caching策略中最新的数据会更热
- 如果执行Sampling:优先会选择最新的Extent
- Extent对用户可以见,可以通过打标方式管理,例如:
Tagging(用来管理Extent)

.ingest ... with @'{"tags":"[\"drop-by:2016-02-17\"]"}' .drop extents <| .show table MyTable extents where tags has "drop-by:2016-02-17"
Purge
Kusto在第一天设计的时候,默认不支持局部删除,只支持Retention。但GDPR出现后增加了局部删除功能,但不建议用户使用(建议用户通过倒部分数据进入另外Table方式解决),从描述看是类似一个Merge过程。
- Phase 1: 通过查询条件指定数据
- Phase 2: (Soft Delete) :对特定数据标记Version,时间在秒级到小时级,对特定操作会有Version(可以撤销)
- Phase 3: (Hard Delete) :完全删除,5天后进行,最长30天
Policy
- Cache vs Retention
set query_datascope="hotcache"; T | union U | join (T datascope=all | where Timestamp < ago(365d) on X
SoftDeletePeriod = 56d
hot cache policy = 28d- Row Order
生态

分析流
包括查询语法与机器学习函数,之前整理过一个PPT(见附件),以PPT为主
技术架构
建议参见白皮书,里面详细阐述了数据,计算能力和Cache相关的底层技术。
价格说明
存储网络单独计费,计算部分通过购买实例方式进行,提供两种类型:存储优化、计算优化)。坦白来说价格不便宜,并且不提供按量的方式(LogAnalytics提供按量付费模式,可以认为需要个性化ADE的用户不差钱吧)。
| 实例 | VCPU | 存储 | LINUX VM 价格 | AZURE 数据资源管理器加价 | 即付即用总价 |
|---|---|---|---|---|---|
| L4 | 4 | 678 GB SSD | ~$250.390/月 | ~$321.20/月 | ~$571.59/月 |
| L8 | 8 | 1.3 TB SSD | ~$500.780/月 | ~$642.40/月 | ~$1,143.18/月 |
| L16 | 16 | 2.7 TB SSD | ~$1,002.29/月 | ~$1,284.80/月 | ~$2,287.09/月 |
| 实例 | VCPU | 存储 | LINUX VM 价格 | AZURE 数据资源管理器加价 | 即付即用总价 |
|---|---|---|---|---|---|
| D11 v2 | 2 | 76 GB SSD | ~$108.77/月 | ~$160.60/月 | ~$269.37/月 |
| D12 v2 | 4 | 153 GB SSD | ~$218.270/月 | ~$321.20/月 | ~$539.47/月 |
| D13 v2 | 8 | 307 GB SSD | ~$436.540/月 | ~$642.40/月 | ~$1,078.94/月 |
| D14 v2 | 16 | 614 GB SSD | ~$873.080/月 | ~$1,284.80/月 | ~$2,157.88/月 |
参考资料
Youtube
- Azure Kusto in service of cyber threat hunting - Meni Braun, Tomer Alpert, Uri Barash
- Azure_Data_Explorer_–_Query_billions_of_records_in_seconds!_-_THR2404
- Kusto_in_Taboola_–_Azure_Data_Explorer_(English)
介绍文档:
技术白皮书: