《数据结构》学习笔记二:算法(二)

简介: 继续上节的学习,我们在这一篇文章里把“算法”这一章内容学习完。本节解决问题:算法的好坏到底是如何评估的?知识点:1.函数的渐进增长2.算法的时间复杂度3.常见的时间复杂度4.算法的空间复杂度1.函数的渐进增长这一知识点与数学相关,不过没关系都是很容易理解的内容。

继续上节的学习,我们在这一篇文章里把“算法”这一章内容学习完。

本节解决问题:

算法的好坏到底是如何评估的?

知识点:
1.函数的渐进增长

2.算法的时间复杂度

3.常见的时间复杂度
4.算法的空间复杂度

1.函数的渐进增长

这一知识点与数学相关,不过没关系都是很容易理解的内容。

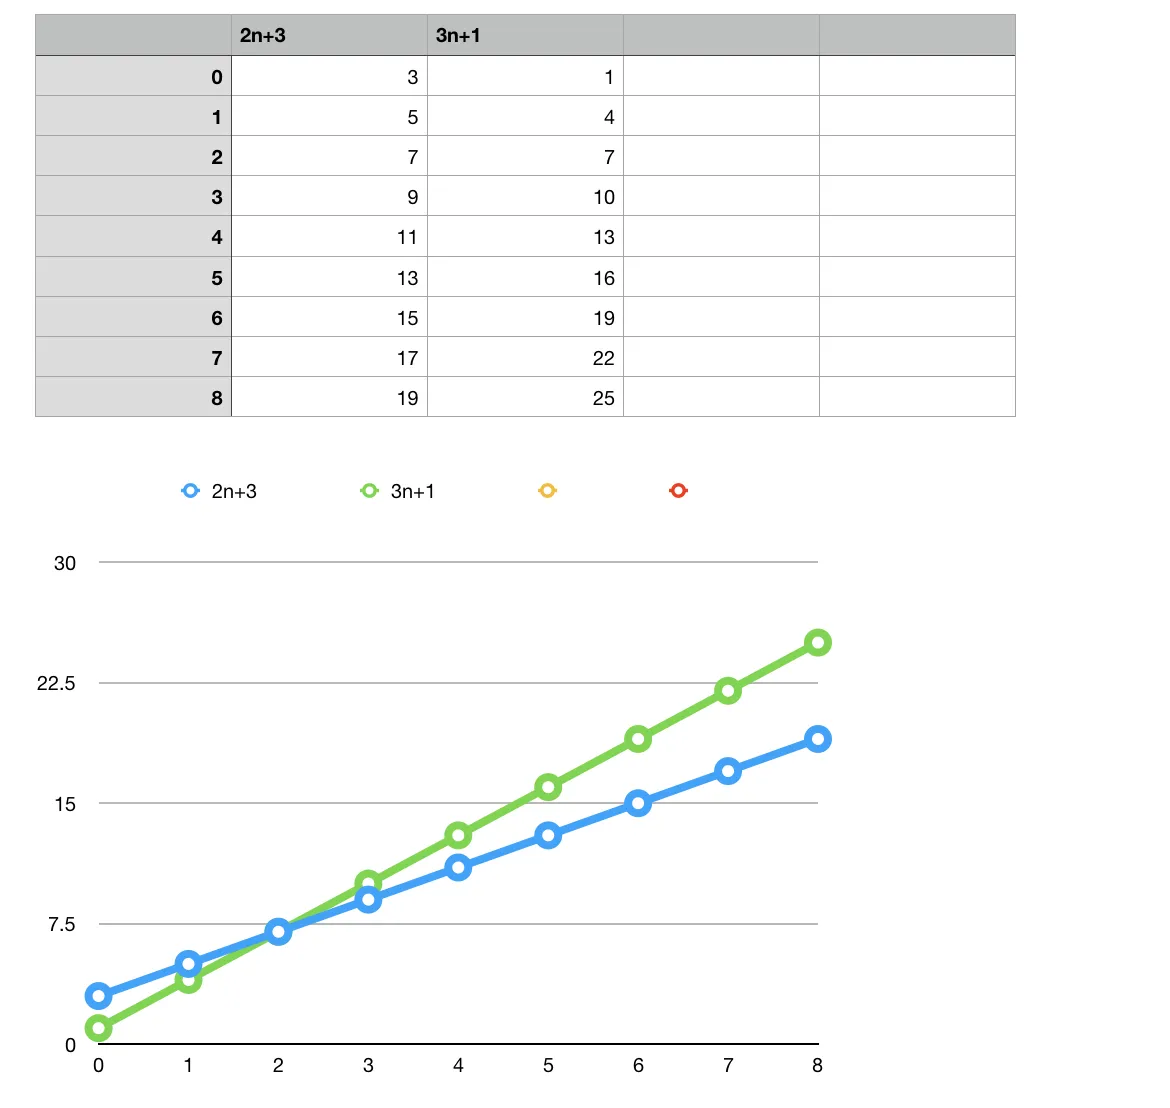
问题: 假如两个算法的输入规模都是n, A的执行次数是 2n +3, B 的执行次数是 3n + 1,那么这两个算法哪一个更好呢?

我们来分析一下,用数学的折线图更够很直观的看到了。
img_be7ab7701137be8d284134510eaac937.png
image.png

这里先给出渐近增长的概念。
输入规模n在没有限制的情况下,只要超过一个数值N,这个函数就总是大于另一个函数,我们称函数是渐近增长的。

函数的渐近增长: 给定两个函数f(n)和g(n),如果存在一个整数N,使得对于所有的n>N,f(n) > g(n),那么我们就说f(n)的渐近增长快于g(n)。

从图中可以看出,随着n的增大,后面的 +3, 和 +1 对结果的影响并不大。同样的,与最高次项相乘的的常数也不是很重要。
我们再看一个例子:
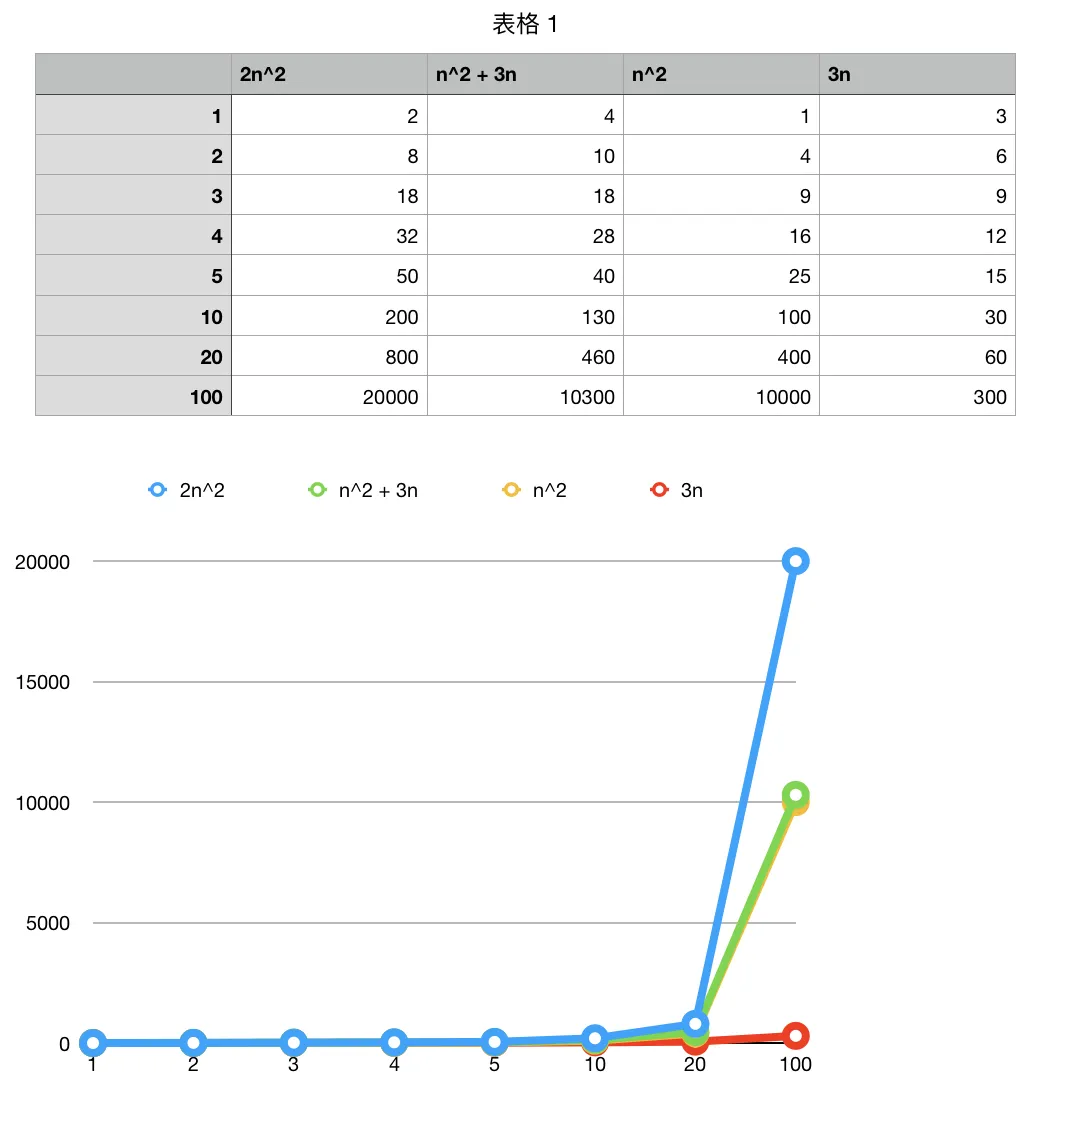
算法 C是 2n^2, D是n^2 + 3n ,我们在来看看他们的曲线图。
img_af032444cfc6349c4b2c52b2278d6444.png
image.png

从图中可以看出,最高次项的指数大的,函数随着n的增长,结果也会变得增长的特别快。

于是我们总结出,判断一个算法的效率时,函数中的常数和其他次要项常常可以忽略,而更加关注主要项(最高阶项)的阶数。

2. 算法的时间复杂度

定义:在进行算法分析时,语句总的执行次数T(n)是关于问题规模n的函数,进而分析T(n)随着n变化的情况并确定T(n)的数量级。记做: T(n) = O(f(n))。

这样用大写的O()来提现算法时间复杂度的记法,我们称为大O记法。一般情况下,T(n)增长的最慢的就是最优算法。

推导大O阶的方法:

  1. 用常数 1 取代所有的加法常数;
  2. 在修改后的函数中,只保留最高阶项;
    3.如果最高阶项存在且不是1,则去除与这个项相乘的常数,得到的结果就是最终的大O阶。

例如:
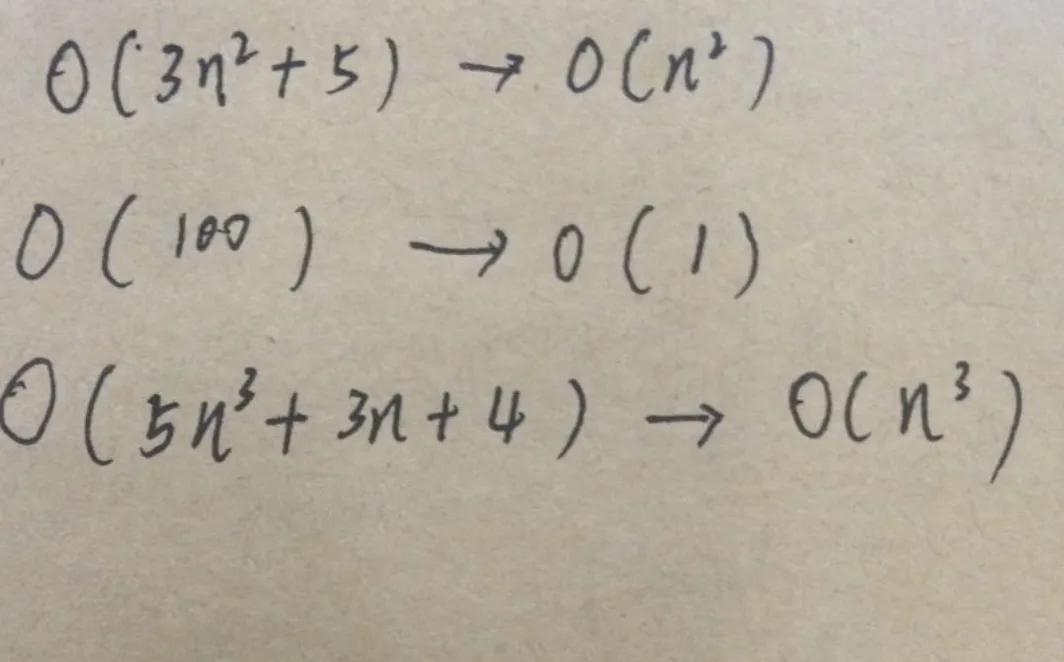
img_808a59434b80cba99f643eb3dc0faee6.png
image.png

下面我们看几个常见的时间复杂度。

1》常数阶
执行的次数与n无关,这样的时间复杂度就是常数阶,根据大O阶的记法,记做O(1) 。

注意: 不管这个常数是多少,我们都记做O(1), 而不是 O(3), O(12)等。

2》 线性阶( O(n) )
线性阶的循环结构要复杂的多。分析算法的复杂度,关键是要分析循环结构的运行情况。

3》 对数阶
例如:

var i = 1, n3 = 100
while i < n3 {
    i = i * 2
}
print("i = \(i)")

这个循环的复杂度是 O(logn)。

img_f9f37f805986fa25ff5be09c30f40491.png
image.png

4》平方阶

let x = 10, y = 10
for i in 0..<x {
    for i in 0..<y {
       print("hello")
    }
}

时间复杂度为 O(n^2) 。

3. 常见的时间复杂度
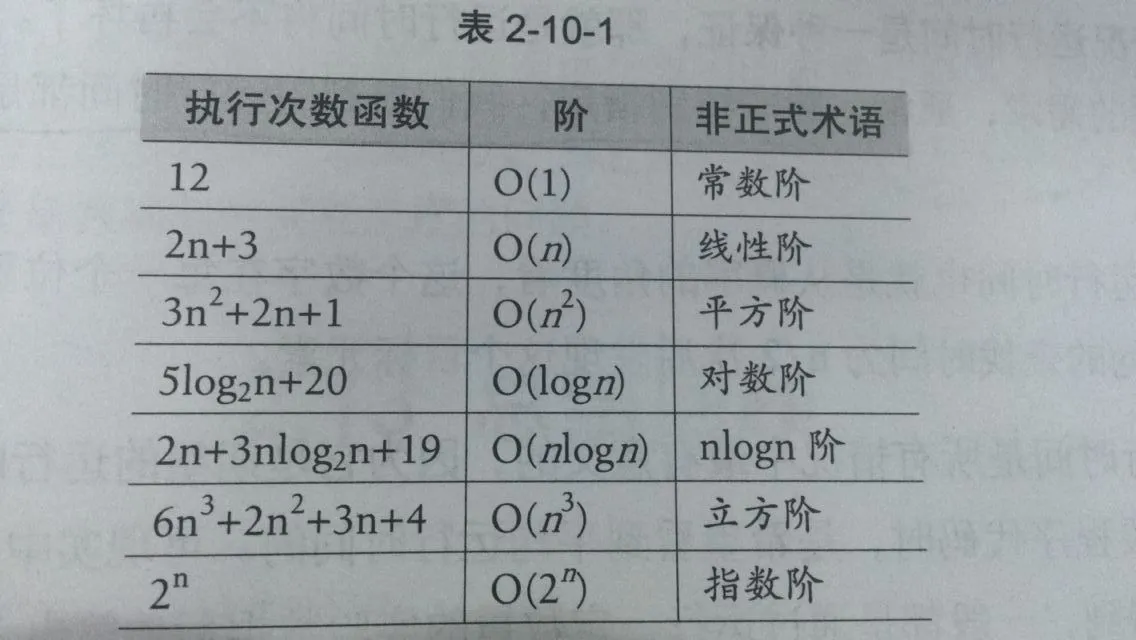
img_90e17b4f1eb25a19368e6616a61563f4.jpe
111.jpg
4. 算法的空间复杂度

算法的空间复杂度通过计算算法所需的存储空间实现,算法的空间复杂度的计算公式记做: S(n) = O(f(n)) 。
n:问题的规模(输入)
f(n): 关于n所占存储空间的函数。

通常,我们都是用“时间复杂度”来指运行时间的需求,使用“空间复杂度”指空间需求。当不用限定词地使用“复杂度”时,通常是指时间复杂度。
目录
相关文章
|
存储 监控 安全
企业上网监控系统中红黑树数据结构的 Python 算法实现与应用研究
企业上网监控系统需高效处理海量数据,传统数据结构存在性能瓶颈。红黑树通过自平衡机制,确保查找、插入、删除操作的时间复杂度稳定在 O(log n),适用于网络记录存储、设备信息维护及安全事件排序等场景。本文分析红黑树的理论基础、应用场景及 Python 实现,并探讨其在企业监控系统中的实践价值,提升系统性能与稳定性。
831 1
|
存储 监控 算法
基于跳表数据结构的企业局域网监控异常连接实时检测 C++ 算法研究
跳表(Skip List)是一种基于概率的数据结构,适用于企业局域网监控中海量连接记录的高效处理。其通过多层索引机制实现快速查找、插入和删除操作,时间复杂度为 $O(\log n)$,优于链表和平衡树。跳表在异常连接识别、黑名单管理和历史记录溯源等场景中表现出色,具备实现简单、支持范围查询等优势,是企业网络监控中动态数据管理的理想选择。
331 0
|
存储 算法 Java
算法系列之数据结构-二叉树
树是一种重要的非线性数据结构,广泛应用于各种算法和应用中。本文介绍了树的基本概念、常见类型(如二叉树、满二叉树、完全二叉树、平衡二叉树、B树等)及其在Java中的实现。通过递归方法实现了二叉树的前序、中序、后序和层次遍历,并展示了具体的代码示例和运行结果。掌握树结构有助于提高编程能力,优化算法设计。
569 10
 算法系列之数据结构-二叉树
|
算法 Java
算法系列之数据结构-Huffman树
Huffman树(哈夫曼树)又称最优二叉树,是一种带权路径长度最短的二叉树,常用于信息传输、数据压缩等方面。它的构造基于字符出现的频率,通过将频率较低的字符组合在一起,最终形成一棵树。在Huffman树中,每个叶节点代表一个字符,而每个字符的编码则是从根节点到叶节点的路径所对应的二进制序列。
516 3
 算法系列之数据结构-Huffman树
|
算法 Java
算法系列之数据结构-二叉搜索树
二叉查找树(Binary Search Tree,简称BST)是一种常用的数据结构,它能够高效地进行查找、插入和删除操作。二叉查找树的特点是,对于树中的每个节点,其左子树中的所有节点都小于该节点,而右子树中的所有节点都大于该节点。
703 22
|
存储 机器学习/深度学习 算法
C 408—《数据结构》算法题基础篇—链表(下)
408考研——《数据结构》算法题基础篇之链表(下)。
707 30
|
存储 算法 C语言
C 408—《数据结构》算法题基础篇—链表(上)
408考研——《数据结构》算法题基础篇之链表(上)。
1015 25
|
存储 人工智能 算法
C 408—《数据结构》算法题基础篇—数组(通俗易懂)
408考研——《数据结构》算法题基础篇之数组。(408算法题的入门)
1094 23
|
11月前
|
机器学习/深度学习 算法 机器人
【水下图像增强融合算法】基于融合的水下图像与视频增强研究(Matlab代码实现)
859 0
|
11月前
|
数据采集 分布式计算 并行计算
mRMR算法实现特征选择-MATLAB
mRMR算法实现特征选择-MATLAB
529 2

热门文章

最新文章