一句话定位:这不是"AI 能写多少代码",而是"AI 改完之后,你凭什么相信它真的变快了"——被检验的对象是改动本身,量具是端到端耗时和离散度,不是微基准里那个漂亮的百分比。同样的方法可迁移到发布会前的依赖安装耗时、接口超时排查、CI 排队时长治理、批量任务跑批窗口。
摘要
Vercel 的 Turborepo 团队用 8 天、20 多个 PR 把一个约 1,000 包仓库的"首次可执行任务"从 8.1 秒压到 0.716 秒。真正值得测试工程师看的不是这个数字,而是他们怎么把"AI 到底有没有真的改对"变成一个可以重复的判定:无人值守阶段 8 个智能体只有 3 个交付了可合入的改动,有智能体在微基准上报出 97% 提升而端到端只有 0.02%,最后能拿住结论的是一个安静容器里跑的 hyperfine 对比。本文把这条链子拆成五步,并给出可以搬到自己 CI 里的判定顺序。
睡一觉起来,桌上 8 个 PR,能合 3 个。
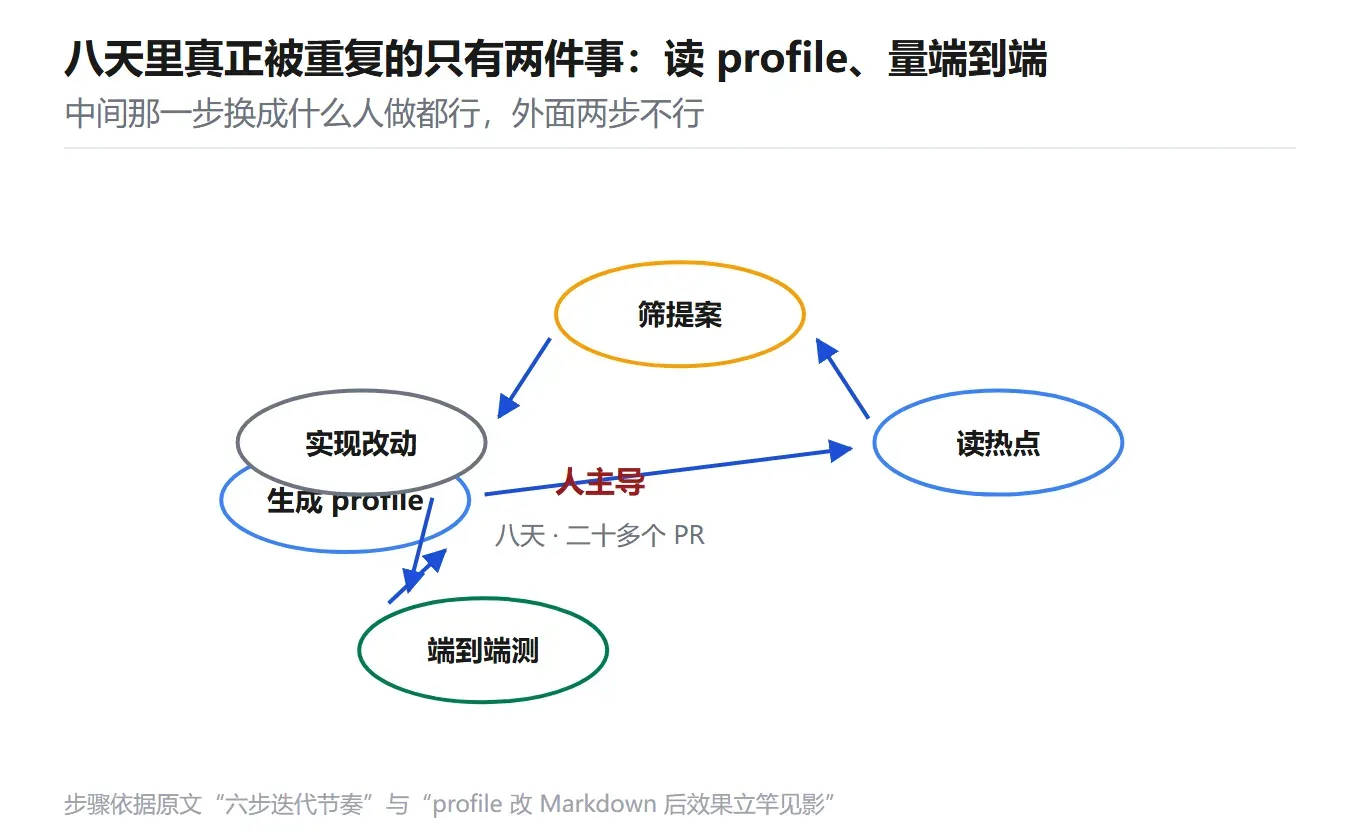
这是 Vercel 的 Anthony Shew 在 3 月 30 日的官方博客里写下的一段真实过程。他在睡前用手机起了 8 个后台编码智能体,每个盯住 Turborepo 的 Rust 代码库里一块"疑似过慢"的地方,提示词里还专门要求:必须是热路径上的、必须有 benchmark、特别关注 hashing。第二天早上,只有 3 个智能体拿出了可以合入的改动——PR #11872 把"克隆整个 HashMap"换成按引用哈希,PR #11874 用 xxhash-rust 替掉 twox-hash,PR #11878 按代码里现成的 TODO 把 Floyd-Warshall 换成多源深度优先搜索。
对做测试的人来说,这个故事的价值不在"AI 能改 Rust"。而在于:8 个里 5 个失败,不是模型不会写代码,是它不知道什么叫"改对了"。
一个智能体报出 97%,端到端只有 0.02%
原文把无人值守阶段的教训列成 5 条,其中第 3 条最像是在说测试工程师的日常:智能体会去追微基准上的"大数字",比如某个函数快了 97%,但这段代码在主流程里只占 0.02% 的时间。
这条之所以致命,是因为它伪装成成功。你要是只看那个 PR 的标题和自带的 benchmark,会得到一个"提升 97%"的漂亮结论,然后把它合进去,然后再也不看。三个月后有人问"为什么任务图构建还是 10 秒",没人答得上来。
另外 4 条教训同样具体:智能体从没想到可以对 Turborepo 自己做端到端 benchmark(这个项目是自举的,它自己就是一个 monorepo 工具);它会死磕第一个想到的办法,而不退一步换抽象;它从不写回归测试;它从不用 turbo 的 --profile 标志去看真实的热点分布。
第 4 条和第 5 条放在一起看很刺眼:一个不会看 profile、也不写回归测试的协作者,不管它是人还是模型,都只能靠猜。
真正把结论钉住的,是一个只有它自己在跑的容器
到周末,性能已经提升约 85%。这时测不动了。
本地笔记本上 hyperfine 的报告越来越吵——系统调用、内存、磁盘 I/O 都在抖,后台程序随手抢一下 CPU,就足以让"真的快了 2%"和"刚好撞上一次安静的运行"分不出来。这个困境做性能测试的人都不陌生:你已经开始用测量误差解释结果了。
他们的解法是把测量搬进 Vercel Sandboxes——一个临时的 Linux 容器,里面只有你放进去的东西,没有后台守护进程、没有通知弹窗、没有别的程序在发请求。bench.sh 干五件事:交叉编译出 Linux 二进制、从预装测试仓库的快照创建容器、把 turbo-main 和 turbo-branch 两个二进制传进去、跑 hyperfine --warmup 2 --runs 15、把两边的 Markdown profile 下载回本地给智能体看。
这里有一条硬约束值得抄下来:Sandboxes 不保证硬件独占,所以所有对比必须在同一个实例上跑。跨实例对比出的"提升",可能只是两台机器的差别。
安静环境里才看得见的三处改动
换到干净容器之后,之前被噪声盖住的三处底层问题浮出来了,它们的共同点是:都不体现在算法上,而体现在"每跑一次要碰多少次操作系统"。
第一处是 git 索引里的 40 字符 SHA-1,原先每个都堆分配一个 String,光 new_from_gix_index 一处就有 10,000 次以上、每次 40 字节的堆分配。改成 OidHash([u8; 40]) 之后,克隆变成一次栈上的 memcpy,new_from_gix_index 的自身耗时降了 15%,get_package_file_hashes_from_index 降了 17%。
第二处更典型。每次取缓存的代码都先 stat(.tar)(拿到 ENOENT)、再 stat(.tar.zst)、最后 open(.tar.zst)——三次系统调用里有一次是必定失败的。那个 .tar 回退路径是 2021 到 2022 年 Go 版本时代的兼容遗留,现代版本根本不写未压缩缓存。直接 open,把 NotFound 当作 cache miss,三次变一次。最大仓库的 962 次缓存获取里,fetch 的自身耗时从 200.5ms 降到 129.6ms。
第三处是 visitor 派发循环里,为约 1,700 个任务各自深克隆一份 (String, HashMap)。因为每个 task ID 在派发流里只出现一次,用 HashMap::remove() 移出值就够了,克隆成本归零。
这三处有个共同点:它们都不会被"某个函数快了 N 倍"这种指标抓到,只会被"总的系统调用次数""总的分配次数"抓到。 而后者需要你在一个稳定环境里连续测同一件事,才能从方差里看出来。
原文自己把 96% 和 91% 分得很清楚
标题里那个 96% 需要单独说一句。
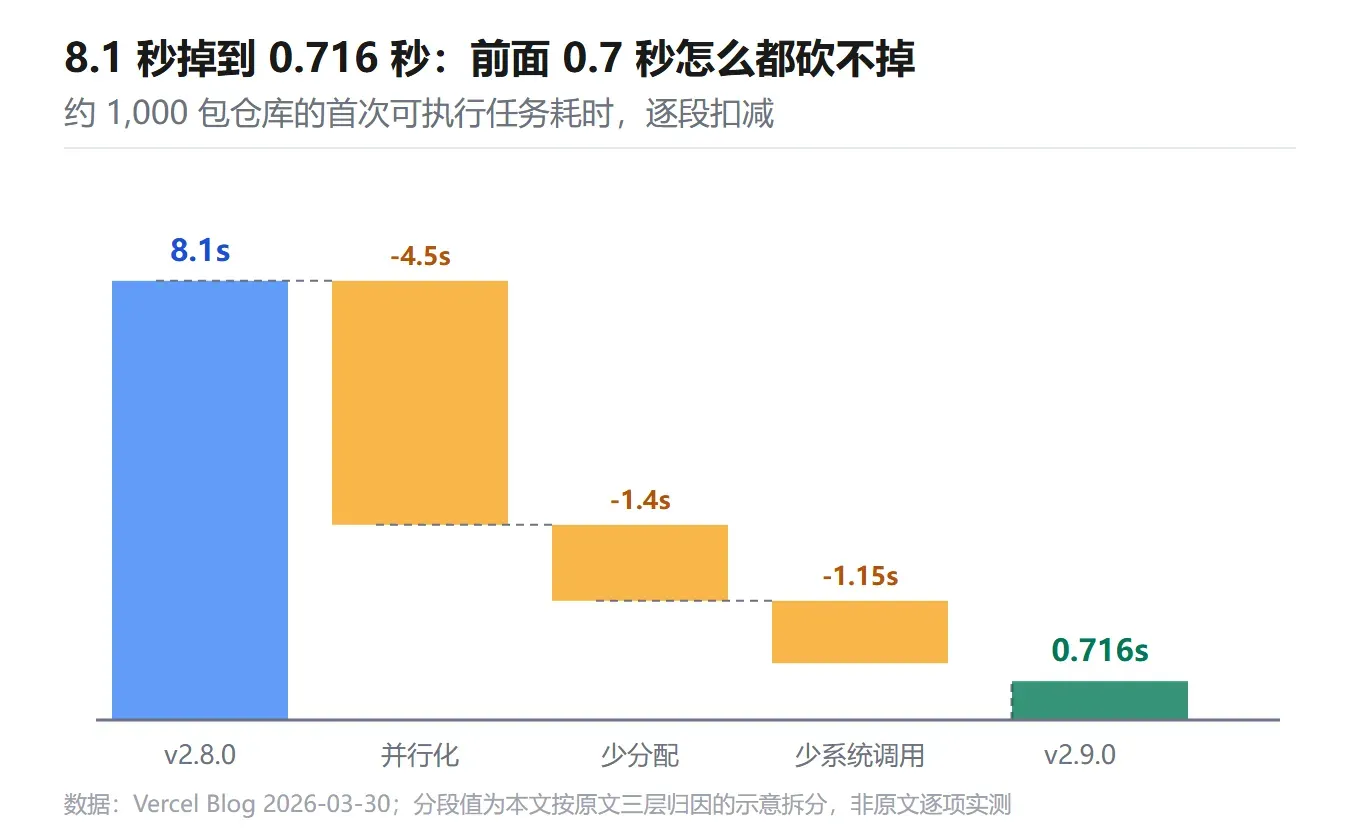
在 Vercel 自家仓库上,约 1,000 包的那个快了 91%(8.1s → 0.716s),132 包的快了 81%(1.9s → 0.361s),6 个包的小仓库快了 80%(0.676s → 0.132s)。96% 这个数出现在"更多开源仓库与用 canary 版本的客户仓库"上——原文的说法是"依据仓库大小与复杂度,最高可达 96%"。
换句话说:91% 是有明确仓库与明确版本的实测,96% 是跨仓库扫描的上界。把两个数写成一个数,读者拿去对标自己仓库时就会对不上。这一点在写技术结论时比 5 个百分点重要得多。
| 仓库规模 | v2.8.0 | v2.9.0 | 提升 | 数字属性 |
|---|---|---|---|---|
| 约 1,000 包 | 8.1s | 0.716s | 91% | 官方自家仓库实测 |
| 132 包 | 1.9s | 0.361s | 81% | 官方自家仓库实测 |
| 6 包 | 0.676s | 0.132s | 80% | 官方自家仓库实测 |
| 其他开源/客户仓库 | — | — | 最高 96% | 官方描述的上界,非单一仓库实测 |
可以搬到你自己 CI 里的四步
把上面这些落成动作,不需要 AI 也能做;有 AI 的时候,这四步就是给它的护栏。
第一步,先定量具再改代码。改之前先跑一遍端到端,记下均值和方差。原文给出的判据是 hyperfine --warmup 2 --runs 15,但更关键的是记录标准差——OidHash 那个改动在大仓库上均值几乎没动(1.463s → 1.466s),方差却降了 48%。均值不变、方差变好的改动,如果只报均值就会被当成"没效果"。
第二步,拒绝只带微基准的 PR。规则可以很硬:任何性能改动必须附一条落到入口处的端到端数字,而且要写清这条端到端跑在哪个仓库、多大、用什么命令。微基准可以作为辅助,不能作为唯一证据。
第三步,测量环境与开发环境分离。这一条最容易被省掉,也最容易毁掉结论。你在自己的开发机上连续测十次,只能证明"这台机器上这十次是这个数"。
第四步,把"代码库自己会教模型"当机制用。原文里有一段值得抄进团队规范:智能体会模仿代码库里现有的模式,包括那些不严谨的;作者修正一处并合并之后,下一个人(或下一次对话)看到的是已合并的改进,于是不再复制旧写法。原文的说法是"你自己的源代码就是最好的强化学习"。翻译成测试语言:你合进去的每一行,都在训练下一个协作者,不管它是人还是模型。
这条链子的边界在哪
有三条限制原文自己承认了,值得一并写出。
一,这不是"全自动"的胜利。作者明确说自己全程主导,并明确拒绝过全自动循环(原文提到的做法是让智能体在无人监督下反复迭代)——因为它会反复出错、一次挪动太多代码。Turborepo 支撑着一些世界上最大的仓库,"快且负责"比"快"重要。
二,样本是自家仓库加少数开源仓库,96% 是上界不是均值。换到依赖 17 个不同包管理器、或者大量原生扩展的仓库,收益结构会完全不同。
三,是最少人被提醒的一条:整个过程依赖一个人对 Perfetto trace 的阅读能力。作者做的第一个"正常工程操作"就是打开 profile 看热点图像;他后来发现智能体之所以给不出好建议,是因为 Chrome Trace 的 JSON 格式对人和对机器都不好用,于是照着 Bun 的 --cpu-prof-md 思路写了一个 turborepo-profile-md,把 trace 转成按 self-time 排序、可 grep 的 Markdown。同一个模型、同一个代码库、同一份数据,只换格式,建议质量就"戏剧性"提升。
这一条对测试团队的启示比 AI 本身更实在:你的可观测性输出格式,决定了协作者(人或其他模型)能不能把问题定位到行。
最后给一个能马上做的动作:翻出你手上最近一次"性能优化"的 PR,看它附的证据是端到端还是某个函数。如果只有后者,先别合,补一条从入口算起的耗时,再决定它是否成立。
本文部分内容参考了霍格沃兹测试开发学社整理的相关技术资料,主要涉及软件测试、自动化测试、测试开发及 AI 测试等内容,侧重测试实践、工具应用与工程经验整理。