
一个表格分类模型有几十项输入。增加特征可能带来信息,也可能引入冗余、噪声和采集成本。与此同时,适合全部特征的模型参数,换成较小特征集后未必仍然合适。
MMAO-Cls把特征选择与分类器参数放在同一个候选方案中搜索。它负责提出配置,SVM、近邻方法或逻辑回归等分类器则按配置完成训练和预测。
一个候选方案,究竟装了什么
假设有六个特征。掩码[1, 0, 1, 0, 1, 0]表示保留第1、3、5项,再配上一组模型参数,就构成一个候选分类配置。
下一次修改可以尝试加入第2项,也可以保留掩码并调整参数。更广泛的修改有助于探索不同特征组合,较小修改则适合继续细调。MMAO-Cls用角色、搜索记忆和资源反馈影响这些修改。
特征表示还要经过解码与修复。空特征集无法正常训练,过度压缩也可能丢失有效信息。研究实现包含掩码修复、训练数据先验和精英配置相关操作,用于保持候选可用并引导搜索。
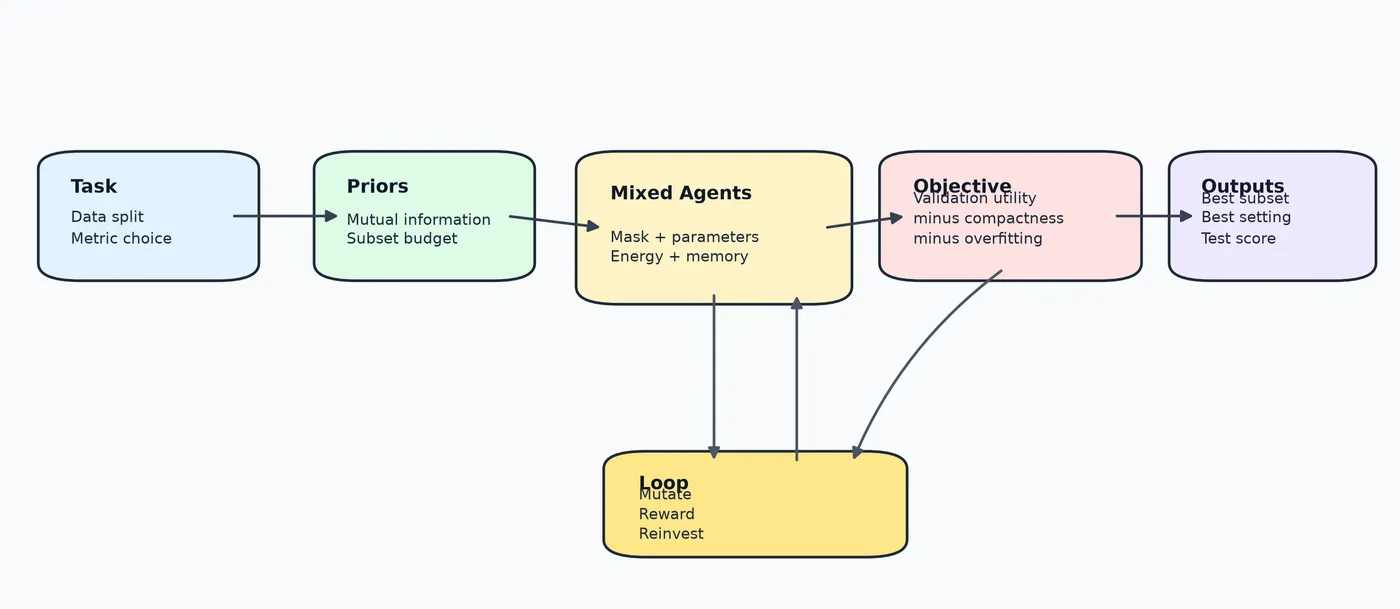
图1 分类预印本中的工作流原图,数据先验、混合候选、分类评价与资源更新相互连接。
顺着图1读一轮,可以依次找到特征与参数如何进入分类器、训练验证结果如何形成评价、评价如何产生资源反馈。候选配置的收益会影响后续搜索,而训练模型的具体方法由所选分类器承担。
特征与参数为什么需要一起考虑
假设一个传感器数据集包含温度、压力、振动等多项输入。去掉某些噪声特征后,模型在样本间计算的距离会改变,原来合适的参数也可能需要调整。先固定参数挑特征,再固定特征调参数,可能错过两者配合后的其他配置。
以RBF-SVM为例,核参数影响样本之间的相似关系,特征尺度与选择集合也会改变这种关系。某组参数在全部特征上表现一般,换成较紧凑的集合后可能更合适。联合搜索把这两类决策放在同一个候选里,直接评价它们组合后的效果。
这同时扩大了搜索空间。六个特征已经有六十四种二进制选择,还要配上不同参数。特征更多时,遍历所有组合很快变得昂贵。资源控制的任务,是依据已经获得的评价反馈安排后续候选,而候选是否值得尝试最终仍由训练验证过程检验。
参数编码还涉及尺度。正则化系数可能跨越多个数量级,在对数空间扰动比按固定绝对步长变化更便于覆盖。类别参数、整数参数和连续参数各自需要解码规则,保证产生的配置能被分类器接受。
一个特征掩码怎样变成可以训练的输入
从原始数据取列时,需要让特征名称、列序号和掩码保持一致。如果训练数据与验证数据的列顺序不同,同一个掩码可能选出不同含义的输入,评分就会失去可解释性。保存最终特征名称,有助于后续部署与检查。
空掩码与过小子集也需要处理。程序可以按既定规则修复候选,再记录修复后的实际特征集合。否则,搜索日志中的方案与真正训练的输入可能不同。比较特征比例时,应使用进入评价或最终模型的那一份集合。
还可以检查变异后的有效变化。一个连续表示经过阈值解码后,轻微扰动可能仍得到同一掩码。若大量候选重复,外层看似进行了很多动作,实际训练配置却变化很少。记录解码后重复率,可以帮助判断搜索覆盖情况。
为什么验证分数稍高,搜索目标却可能更低
MMAO-Cls预印本的目标同时考虑验证表现、超出目标特征比例的代价,以及训练与验证之间的正向差距。下面构造两组教学配置,演示这些项怎样影响选择。
假设目标特征比例为0.5,使用论文中的特征惩罚系数0.16和训练验证差距系数0.18。实际研究中的目标比例由训练数据先验推导,此处固定它以便手算。
| 教学配置 | 特征比例 | 训练评分 | 验证评分 | 按该目标计算的分数 |
|---|---|---|---|---|
| A,保留六项 | 1.0 | 0.950 | 0.910 | 0.8300 |
| B,保留三项 | 0.5 | 0.920 | 0.908 | 约0.9058 |
A的验证评分高0.002,但超出目标特征比例,紧凑性扣分为0.0728,训练验证差距扣分为0.0072。B达到目标比例,紧凑性扣分为0,差距扣分约0.0022,因此综合目标更高。
这组数值用于演示评价规则。读者可以改变目标比例或惩罚强度,观察两种配置的偏好何时改变。实际选择应对应任务对预测质量、输入规模与采集成本的要求,运行软件时也要核对该版本的默认设置。
先验如何引导特征规模
分类研究从训练数据计算特征信息先验,用它帮助推导目标子集规模并影响候选修改。互信息衡量单个特征与标签之间的统计关联,可以提供排序线索,但特征间的组合关系仍需要在模型评价中检验。
如果两个特征高度冗余,各自都可能得到较高先验,组合使用却未必带来相同幅度的收益。反过来,某些单独关联不强的特征,在与其他变量配合时可能有用。因此,先验适合参与搜索引导,候选组合仍应通过训练与验证评价。
论文按累积先验信息设置相应子集预算,再将目标比例用于紧凑性评价。读者可以先查看训练部分的先验分布,判断信息是否集中在少数特征,随后检查搜索得到的集合与先验之间是什么关系。
当先验值整体很低或近似相等时,程序还需要明确回退规则。小样本、标签噪声或不同特征类型,都可能影响估计。复现时应核对先验计算方法、随机状态和训练划分,避免让预处理差异影响后续比较。
综合目标如何影响一次接受决定
前面的A与B教学配置展示了一个具体取舍。A验证评分略高,却因为特征比例与训练验证差距得到较多扣分。B原始验证评分略低,但按这组目标定义取得更高综合分数,因此搜索更倾向于保留B。
这要求读者同时保存原始评分和目标各项。目标提高可能来自预测改善,也可能来自缩小特征集合。只报告综合分数,使用者很难知道模型实际预测能力发生了什么变化。
惩罚强度也应对应实际需求。若每项特征采集都很昂贵,紧凑配置可能具有直接价值。若特征已经免费获得,而预测误差代价很大,则需要更重视原始评分。设置权重前先定义业务取舍,才能解释搜索为什么偏好某一配置。
模型复杂度与特征数量之间还有其他联系。减少输入可能降低部分计算或采集成本,但训练时间也受样本量、核方法和参数影响。可以在选定配置后实际测量训练时间、推理时间和输入获取成本,判断紧凑性的使用价值。
数据怎样流动,决定结果是否可信
先固定训练、验证和测试划分。特征信息先验从训练部分计算,标准化参数也在训练部分拟合。优化过程用训练数据拟合模型、用验证数据比较候选,最终选定配置后再评价测试集。
如果先在全部数据上挑出“最有用”的特征,再划分数据,测试信息已经参与了前面的选择。若反复根据测试成绩调整参数,测试集也会逐步进入搜索过程。结果看起来可能更好,泛化能力却更难判断。
预印本采用分层划分,训练、验证、测试比例为56.25%、18.75%、25%。复现时还要保存划分种子,并核对每个数据集使用平衡准确率还是宏平均F1。
把训练、验证与测试分开走一遍
先用训练部分拟合标准化等预处理,再把相同变换应用到验证部分。候选选择特征与参数后,分类器只在允许用于拟合的数据上训练,验证评分负责比较方案。所有搜索步骤都应遵守事先确定的数据协议。
如果采用交叉验证,可以在每个训练折内重新拟合预处理与特征先验,避免验证折信息进入前面的选择。折数增加会提高拟合次数,因此要同时记录验证协议和实际成本。不同方法使用不同折数时,计算投入也需要说明。
最终选定配置后,才使用持出测试集报告泛化结果。若查看测试成绩后继续调整特征、目标权重或参数,测试信息就参与了选择。较稳妥的做法是先固定调整策略,再保留真正独立的评价材料。
小数据集还容易受到划分波动影响。某次验证集上少数样本的预测变化,就可能明显改变评分。多个划分或种子能够展开这种不确定性,逐数据集结果也比单个总体均值更容易定位问题。
类别不平衡会怎样改变评价
若一类样本占绝大多数,总准确率可能对少数类表现不够敏感。平衡准确率按类别召回率汇总,宏平均F1也让各类别参与评价。论文按数据集采用相应指标,读表时应保留指标名称。
对于业务模型,可以进一步检查每类结果、混淆矩阵或所需阈值。一个综合指标相近的配置,可能对某些类别差别较大。特征减少后,这些类别是否受影响,也可以单独分析。
如果训练过程还包含采样或类别权重调整,应将它们纳入配置和数据流程。采样步骤应在相应训练部分进行,再用保持评价含义的数据报告结果。这样,联合搜索中的改进才有清楚来源。
实验更突出地显示了怎样的取舍
相关预印本使用七个公开表格数据集、每个三个种子,包含RBF-SVM、近邻和逻辑回归三类分类器。以下为论文汇总的持出测试结果。
| 方法 | 平均测试指标 | 平均持出特征比例 |
|---|---|---|
| MMAO-Cls | 0.8882 | 0.4881 |
| NoResourceSharing | 0.8900 | 0.5023 |
| PSO-lite | 0.8874 | 0.5258 |
| GA-lite | 0.8857 | 0.5172 |
| RandomSearch | 0.8808 | 0.5126 |
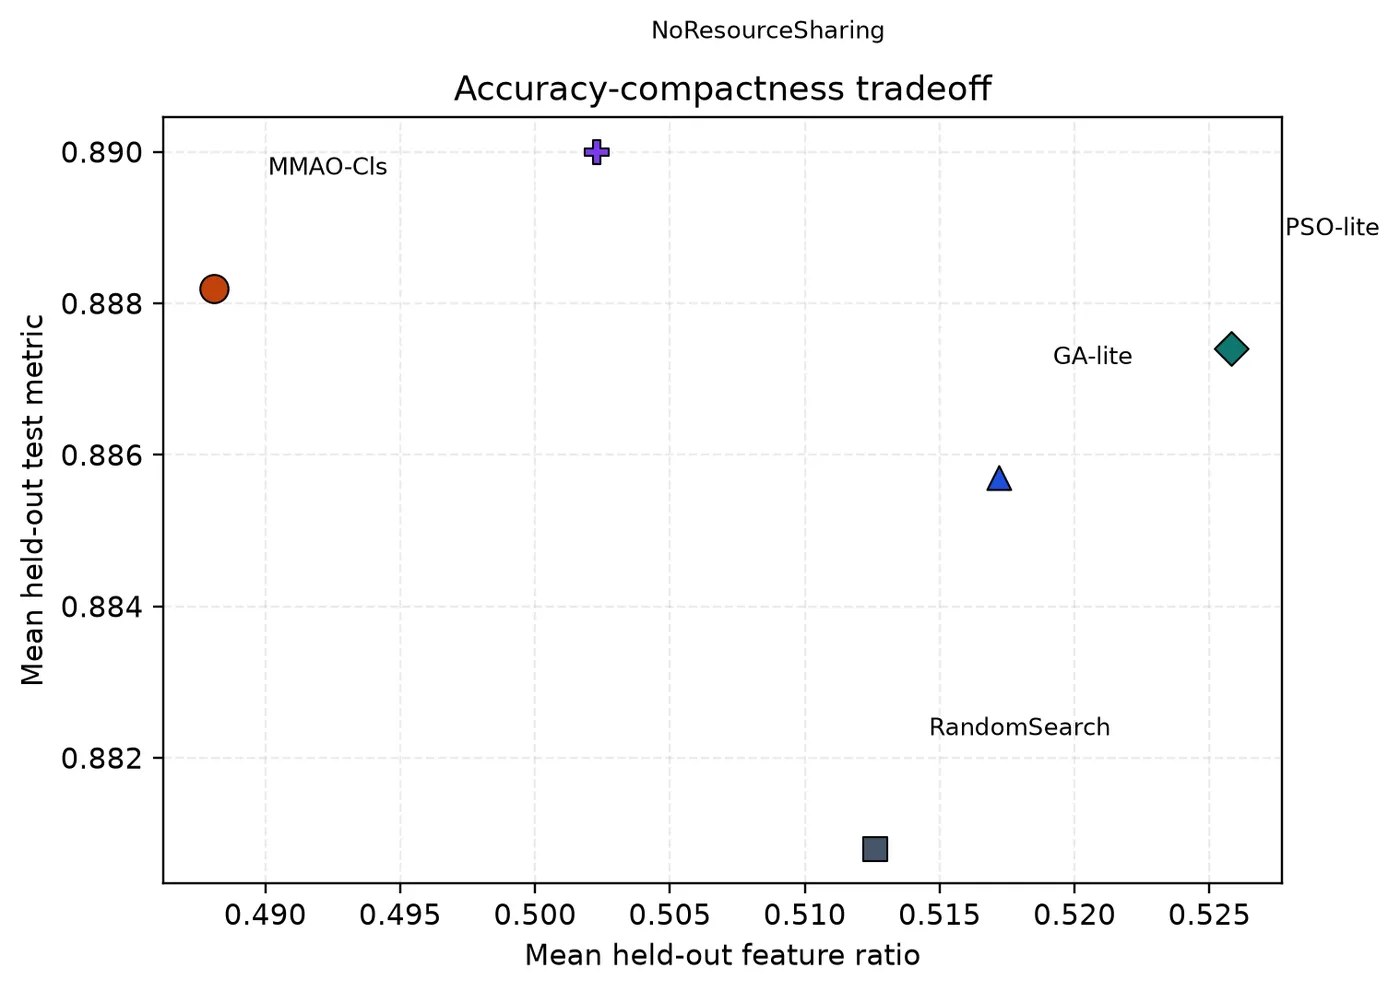
图2 平均测试表现与特征比例的关系,横轴越低越紧凑,纵轴越高表现越好。
图2中MMAO-Cls位于最左侧,表示平均选择的特征比例最低。无共享版本位于更高的位置,测试均值略高,特征比例也更大。两个点呈现了预测表现与紧凑性之间的具体取舍。
与PSO-lite相比,MMAO-Cls的平均特征比例低0.0377,相当于3.77个百分点,测试均值则相近。论文的配对Wilcoxon检验未显示显著差异。这些结果更适合支持紧凑混合配置搜索的价值,实际预测收益应逐数据集检查。
例如,论文在ionosphere和vehicle上的测试表现仍落后于部分比较方法,说明紧凑性偏好在不同数据结构下需要检验。平均保留0.4881比例的特征,也不能直接换算成同等比例的推理时间节省,时间与采集成本要另外测量。
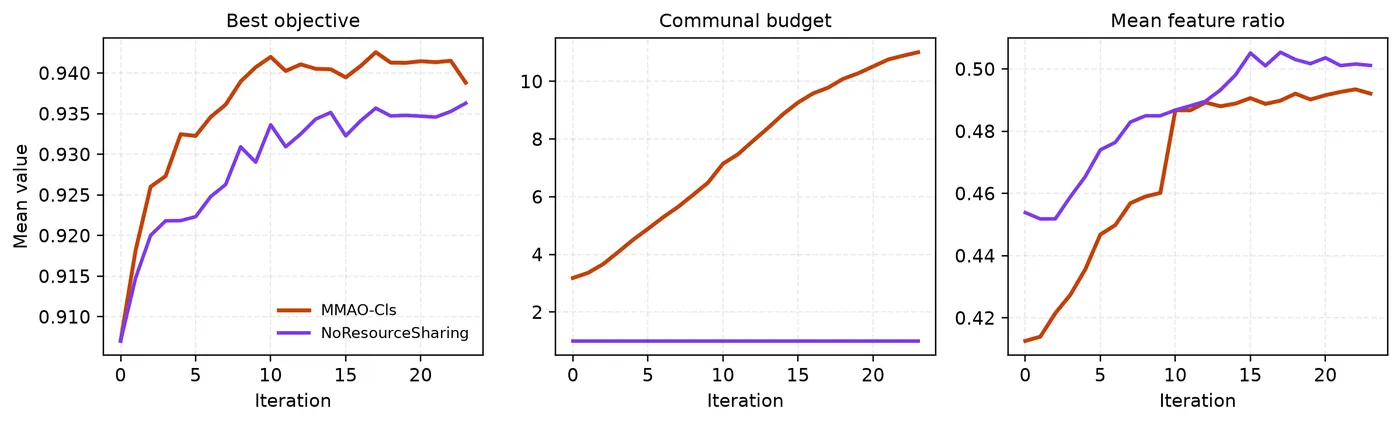
图3 两种版本的目标、公共资源池与特征比例轨迹。
看图3时,可以检查特征比例缩小的阶段,目标是否同时提高,以及公共资源如何变化。若目标提高主要伴随特征减少,就要回到验证评分,确定预测质量是否仍符合要求。这样可以把综合目标拆回读者关心的实际效果。
从图中的两个点回到逐数据集表现
图2把平均特征比例与平均测试指标放在同一平面,便于观察不同方法的整体位置。MMAO-Cls更靠左,表示汇总后的集合更紧凑。无共享版本略高,则说明该汇总中测试均值更高。两个坐标共同构成取舍。
平均比例的解释还取决于汇总方式。假设一个四特征数据集选择两项,另一个一百特征数据集选择三十项,两个比例分别为0.5与0.3。按数据集等权平均得到0.4,合并特征数量计算则约为0.3077。报告时应说明采用哪种口径。
论文不同数据集采用不同分类器与评价指标,聚合结果适合展示整体趋势。准备在某一领域使用时,应继续查看与自己数据规模、类别结构和模型更接近的结果,再安排针对性比较。
例如,研究中部分数据集的预测表现较弱,就可以检查是特征压缩过强、参数搜索不足,还是训练验证波动。图3中的过程记录可以帮助定位变化阶段,随后还需要逐次候选与最终测试结果配合解释。
特征组合中的停滞,为什么需要联合动作
特征选择也可能出现局部停滞。假设当前保留特征A与B,单独删除其中任何一项都会降低评分;而另一组C与D配合某种模型参数,可能得到更高综合目标。若动作始终只修改一个位,并要求每一步改善,就可能难以到达后者。
较广的掩码扰动、参数联合修改以及新个体,可以提供其他组合的候选。MMAO-Cls中的角色与资源安排能够调节相应尝试,但有效覆盖仍取决于混合编码、修改幅度和解码修复。先验过强或修复过于集中时,也应检查候选是否反复回到相近集合。
要观察这些机制,可以保存停滞前后的掩码差异、参数变化、综合目标与原始验证评分。找到更好组合后,再按既定数据协议评价泛化效果。这样能够说明探索取得了怎样的配置收益,同时保持评价含义清楚。
怎样判断资源共享有没有带来帮助
无共享版本保留其他相应搜索过程,并改变公共资源相关路径。最终测试均值接近时,可以继续看候选数量、特征变化和实际拟合次数。共享可能改变搜索过程,但这种变化是否值得,仍要结合质量与成本。
可以检查完整方法在何时新增了候选,这些候选的特征集合与原精英是否相近,以及后来贡献了多少改进。若新增配置重复很多,资源可能没有扩大有效覆盖。若新配置提高目标,却降低原始验证评分,则继续查看紧凑性项的影响。
这些观察可以帮助设计更细的实验。保持候选数量或拟合预算对齐,再比较不同再投入方式,能够逐步检验共享机制的具体贡献。论文结果提供了起点,后续分析可以围绕明确问题展开。
第一次在自己的数据上试,先保留哪些记录
可以先固定一个分类器,用完整特征建立参照,再尝试联合搜索。对每个选定配置保存特征名称、模型参数、训练验证评分、特征比例、训练次数和耗时,最后用预留测试集评价。
如果验证分数很好、测试明显下降,优先核对数据泄漏、划分波动与验证集反复选择的影响。如果特征越来越少但预测质量下降,则检查目标比例和惩罚项。如果训练太慢,先测量每次拟合成本和候选重复情况,再考虑缓存有效的重复评价。
预印本对齐了外层迭代安排,各方法的候选数量和模型训练次数仍可能不同。比较成本时应实际统计拟合次数。把这些记录与特征采集需求放在一起,才能判断MMAO-Cls找到的紧凑配置是否值得采用。
从一个小数据集建立完整记录
可以先选一个能够快速训练的公开数据集,固定一种分类器与划分。先训练完整特征的参考模型,再运行小预算联合搜索。核对每次候选的掩码、参数与实际输入,确认原始评分、惩罚和综合目标能逐项复算。
接着保存每次拟合的配置与数据协议,检查是否存在完全重复的候选。缓存键可以包含特征集合、模型参数、数据划分和评价设置,避免把不同协议的结果混用。若模型本身随机,还应考虑训练种子对缓存含义的影响。
对于数值相近但不完全相同的参数,是否合并缓存需要明确规则。任意取整可能把不同配置当成同一候选。开始时可以先只缓存完全一致的输入,待测量重复情况后再决定是否引入近似处理。
随后增加重复运行,报告测试评分、特征比例和拟合成本。若得到多个表现接近的集合,可以观察特征选择频率,找出稳定出现的输入,并结合领域知识检查。高频出现提供进一步分析线索,特征因果意义则需要其他证据。
最后检查部署流程是否与实验一致。保存列顺序、预处理参数、最终特征名称和分类器设置。新样本进入系统时,应该经过同一套变换,才能让实验得到的配置发挥预期作用。
用两类小改动定位效果来自哪里
在六特征教学配置中,可以先固定模型参数,只改变一个掩码位。这样能观察加入某项特征后,验证评分、特征比例与综合目标怎样变化。再固定掩码,只调整一个模型参数,观察参数细化产生的收益。两类记录便于理解联合候选的不同部分。
随后再允许同时修改特征和参数。如果联合改动有效,就可以与前两类结果对照,判断两者是否存在配合。如果某类动作长期没有收益,可以检查其尺度、解码规则和评价成本,而无需立刻增加所有搜索预算。
还可以从完整特征与较小特征集分别启动,检查初始状态是否明显影响结果。若不同起点最终得到相近配置,说明在这组设置下搜索具有一定一致性。若结果差异很大,则进一步检查局部修改是否足以连接不同特征组合。
当多个方案综合目标相近时,可以把它们保存在候选档案中,分别查看原始验证分数与特征数量。这样能够观察目标权重附近的替代方案,再按事先确定的业务要求选择。最终测试依然用于评价已经选定的方案。
这些小检查还能帮助解释资源反馈。收益究竟来自一次特征加入、一次参数细调,还是两者配合,可以沿候选变化追溯。资源日志接上配置差异之后,搜索过程就更容易被复查和改进。
通过这条路径,读者可以从六特征教学配置走到可复查的联合优化实验。每次选择为何被接受、最终保留了哪些信息、为此训练了多少模型,都有具体记录,MMAO-Cls的应用价值也就能在相应数据任务上继续检验。
资料来源
- 《MMAO-Cls: Metabolic Multi-Agent Optimization for Joint Feature Selection and Classifier Tuning》,七数据集结果和全部插图来源。arXiv:2607.01539
- 后续期刊论文包含另一个三数据集分类评价设置。DOI:10.1109/ACCESS.2026.3752083
- 分类接口与开源软件。mmao-opt(PyPI) · wolfbrother/mmao(GitHub)
