
MODEL EDGE0-35B-A3B
HW R5 5600H · 16GB 单通道
GPU 无独显 · VEGA 核显
本文所有数据为个人实测,非官方数据。测试硬件:某刻(初代) 迷你主机 / AMD Ryzen 5 5600H(6核12线程)/ 16GB DDR4-3200 单通道 / Vega 核显 / 512G NVMe / Windows 11 x64。
这台配置的二手行情:同级完整机挂牌 ¥1,550–1,590,千元级——不是垃圾价,但依然只是 RTX 4090 的零头。
一、官方说 CPU 就能跑,但没人告诉你跑起来是什么体验
2026 年 11 月 12 日,Edge0 团队开源了 Edge0-145B 和 Edge0-120B,官方给出的数字非常挑衅: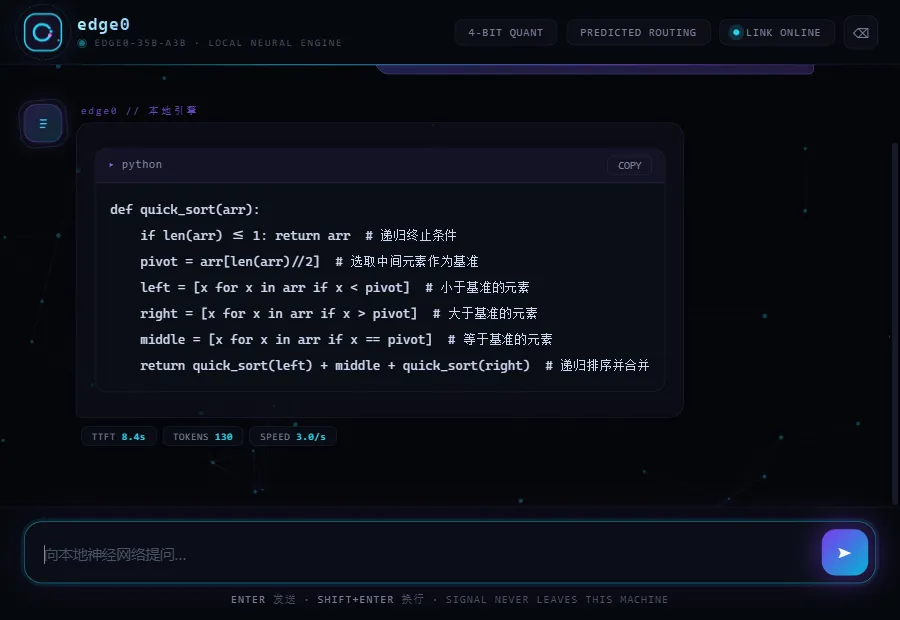
145B 参数,峰值内存 29GB,解码 80+ tokens/s
一台"合适的笔记本"就能跑,不用服务器
编码、推理、Agent 能力对标云端前沿模型
我搜了一圈(开源第 3 天):真人实测只有寥寥几篇,且清一色 RTX 4090/5090 和 M2 Ultra(jansverre、goremy 等博主);中文圈全是新闻通稿,无一篇真机部署。更有意思的是,已经有日文博主实测拆穿:145B 宣传的"29GB 峰值内存"只算活跃内存,实际占用 54GiB——29GB 是营销口径,不是你机器上会消失的内存。
而对 AMD 平台和核显用户来说,这场热闹暂时与你无关:145B 那一档只支持 NVIDIA CUDA,你们的上限是 35B 档——恰恰是官方文档里"CPU 就能跑"、装机基数最大的入门配置。
先泼一盆冷水:35B 是今年 9 月发布的 preview 版,官方模型卡自己承认 Agent 能力弱、质量有限,145B/120B 才是这次的重头戏。那测它还有意义吗?我认为有——因为"CPU 能跑"和"跑起来能不能用"之间隔着一整个数量级的体验差距,而这部分没人量化过。
于是我做了这次体验量化测试:一台闲鱼千元级的某刻初代、单通道 16GB 内存、没有独立显卡。先说结论:
能跑。热缓存后首字 1.3 秒、解码 4.27 tokens/s,日常聊天够用;但预填充只有 11.5 tokens/s,让它当编程 Agent 后端在数学上不可行。
二、部署实录(以及 4 个官方没写的坑)
坑 0:先认清你要下什么
型号 架构 最低硬件 说明
Edge0-35B / 8B GGML 原生引擎 CPU 即可(AVX2) 本文测试对象,AMD/核显用户的上限
Edge0-145B / 120B edge0-strata 引擎 NVIDIA 显卡 ≥16GB 显存 + CUDA 13 本次的明星,核显/AMD 用户无缘
坑 1:HuggingFace 直连超时
国内环境直连 huggingface.co 直接超时。解决办法是用 hf-mirror.com 镜像,模型共 18.38GB(4-bit 量化 + LoRA + 预路由器),4 个分片并行下载约 45 分钟:
bash — download.sh
curl -L -C - -o model-00001-of-00004.safetensors \
"https://hf-mirror.com/Edge0/Edge0-35B-A3B-preview/resolve/main/model-00001-of-00004.safetensors"
-C - 参数务必加上,断了可以续传。下载完用 stat -c%s 对一遍字节数——我四个分片全部校验通过。
坑 2:引擎包里其实自带一切
GitHub Releases 下载 edge0-chat-0.2.0-windows-x64.zip(264MB),解压后里面有:
edge0-infer.exe:预编译推理引擎,不需要自己编译
Edge0 Chat.exe:官方图形界面
edge0-strata/:145B 用的引擎(本机用不上)
坑 3:模型要先转换,而转换器在 Windows 上会崩
35B 不能直接用 HuggingFace 原始权重,需要先转成 GGUF 资产(+22GB 磁盘)。官方给了转换工具,但直接跑会报:
error output
error: [WinError 1314] 客户端没有所需的特权。
原因:转换器用符号链接把源权重链接进暂存目录,而 Windows 非管理员、未开启开发者模式时无法创建软链。解法二选一:
系统设置里打开「开发者模式」;
给转换器打个三行补丁——同盘改用硬链接(无需任何特权,语义等价):
python — patch.py
try:
link.symlink_to(target)
except OSError:
os.link(target, link) # 硬链接 fallback
补丁后重跑,转换 661 秒完成,自检 703 个张量全部通过:
convert.log — output
[self-check] edge0-35b.gguf: tensors=703 kv=39 OK
DONE 35b: gguf=20.26GiB lora=40.5MiB took 661.3s
坑 4:核显 Vulkan 加速是负优化
官方文档说 Windows 支持 --prefill-device vulkan(预填充走 GPU)。RTX 4070S 参考机上,这一项把首 token 时间从 17 秒压到 3.9 秒,很诱人。
我在 Vega 核显上实测:不升反降。预填充速度没变(核显算力太弱),解码反而从 4.27 掉到 2.93 tok/s——引擎日志显示产生了 80 次 GPU↔CPU 数据交接,每次都在拖后腿。
教训:iGPU 用户老老实实用纯 CPU。
顺带回答一个必然有人问的问题:为什么不直接用 Ollama 跑原版 Qwen3.6-35B?
Edge0-35B 本质是 Qwen3.6-35B-A3B 加了 LoRA 和一个预路由器。直接跑原版理论上更"纯净",但有两个坑:
Qwen3.6 的 GDN(Gated DeltaNet)架构在 llama.cpp 的 AMD Vulkan 后端上有解码崩塌 bug——预填充正常 3100+ tok/s,解码掉到个位数,社区已有 issue,我这种老核显大概率中招;
Edge0 的预测路由(预路由器预测下一个 token 需要的专家、提前从 SSD 预取)是白送的 ~50% 解码提速,原版模型没有这个加成。
所以在这台机器上,Edge0 版反而是更优解。
三、Benchmark:三组对照实验
测试方法:253 token 中文提示,预热 10 步,计时 100 个生成 token,官方 bench 工具。
配置 解码速度 预填充 首 token 结论
CPU 4 线程(默认) 4.27 tok/s 11.5 tok/s 22.0s ✅ 最优
CPU 6 线程 4.20 tok/s 11.3 tok/s 22.5s 无提升
Vulkan 预填充 + CPU 解码 2.93 tok/s 11.0 tok/s 23.1s 负优化
三个反直觉的发现:
edge0 本地对话实测:缓存热启后首字 1.3 秒,生成 4.4 tokens/s
FIG.1 — 本地对话页实测:缓存热启 TTFT 1.3s · 4.4 tok/s(界面为作者原创设计)
发现 1:加线程没用,瓶颈在内存带宽。6 线程和 4 线程成绩一样。单通道 DDR4-3200 的理论带宽只有 25.6GB/s,解码时每个 token 都要把激活专家的权重从内存过一遍——CPU 核心再多也只能等内存。
发现 2:稀疏 MoE + 预测路由,是它能在低配机器上活下来的原因。总参数 35B,每 token 只激活约 3B。官方引擎的预测路由会提前预测下一个 token 需要哪些专家,趁当前 token 在算的时候从 SSD 预取。日志显示预取 3564 次、仅 2 次迟到——这项技术是 Edge0 那篇 arXiv 论文(The Other Half of the Memory Wall)的核心。
发现 3:内存峰值只有 3.77GB。16GB 内存的机器跑得毫无压力,专家权重大部分时间躺在 SSD 里按需换页。官方宣传"手机级内存"不是吹的。
四、灵魂拷问:它能当编程 Agent 的后端吗?
这是我最想回答的问题。答案:不能,而且是数学上不能。
用 OpenCode 实测,Agent 模式每次请求的系统提示词(工具说明 + 角色设定)约 11,000 tokens。而我这台机器的预填充速度是 11.5 tokens/s:
11,000 ÷ 11.5 ≈ 16 分钟
也就是说,你在编程助手里敲下一个问题之后,要白等 16 分钟才开始看到第一个字。这还是模型开始"思考"之前。
问题的本质是:Agent 工具和 SSD 流式推理是错配的。Agent 的架构是"大系统提示词 + 高频多轮调用",每一轮都要重新消化全部上下文;而流式引擎的长项是"小提示词 + 长输出"。两者对预填充的要求完全错位。
顺带一提,双通道内存能把预填充翻倍到 ~23 tok/s,16 分钟变 8 分钟——依然是不可用。
五、那它到底适合谁?
结合实测,我给出这台机器上的使用边界:
场景 体验 判定
本地隐私问答(Chat 界面) 热缓存首字 1.3 秒,冷启动 ~6 秒 ✅ 甜点区
3K 以内的文档分析 首字 ~30 秒,可以接受 ✅ 可用
长文写作 4.3 tok/s,比阅读速度慢 ⚠️ 磨人
编程 Agent 后端 16 分钟首字 ❌ 数学上不可行
想接近官方宣传的速度,先分清两档,别被一句话带偏:
35B 档:不需要 N 卡。官方支持矩阵是 macOS Metal/CPU、iOS、Android CPU、Linux CPU、Windows CPU/Vulkan——从头到尾没有 NVIDIA。瓶颈确实是内存带宽:我把解码线程从 4 加到 6 速度纹丝不动(本文实测);官方数据也跟着带宽排序——M5 16GB 跑 24.8 tok/s,安卓旗舰只有 6–9 tok/s。
145B 档:NVIDIA 是硬门槛。官方要求 Linux/Windows + NVIDIA GPU + CUDA 13,v0.2.0 发布说明明确 compute capability ≥7.5(RTX 20 系起步)。官方没公布"最低配置",但模型卡给了一行受限测试:16 GiB 显存 + 20 GiB 内存预算下,Q3_K 仍有 44.9 tok/s——这是目前最接近"下限"的官方实测。速度表上 RTX 4090 24GB 跑 91.7 tok/s、RTX 5090 D 跑 121.2 tok/s,"80 tok/s"宣传的主角就是这一档。另外提醒:145B 权重体积 Q3_K 40.8 GiB / NVFP4 47.8 GiB,SSD 也要提前留够。
一句话总结:35B 人人能跑;145B 必须先买 N 卡(RTX 20 系起步,官方实测过的最低预算是 16G 显存 + 20G 内存,44.9 tok/s 起步)。
但我依然认为这次部署有价值:它验证了 Edge0 宣传的下限是真的。一台没有独显、单通道内存的千元级二手迷你主机,确实能让一个 35B 的 MoE 模型以可交互的速度运行。三年前这需要一台服务器,今天它塞进了一个鞋盒大小的盒子。
顺手算一笔"垃圾佬经济学"的总账:
项目 成本
同款迷你主机 5600H/16G/512G(闲鱼二手,2026-11 行情) ~¥1,550
加装一条 16GB 内存组双通道(可选升级) ~¥200
电费(整机满载 ~60W × 每天 4 小时) ~8 元/月
模型、引擎、工具链 0 元(全开源)
合计 约 ¥1,750,拥有一个完全离线、无月费、数据不出门的本地大模型终端
作为对比:一张全新的 RTX 4090 超过万元。这个价位买不到"快",但买到了"能跑"和"私密"——剩下的瓶颈(内存带宽)恰好是消费级硬件最便宜的升级项。
■ DECLARATION / 声明
本文所有性能数据为个人实测,测试环境已在文首注明,不代表官方数据,不同硬件结果会有显著差异;测试对象为 Edge0-35B-A3B-preview 检查点,后续正式版表现可能不同
edge0 名称与相关商标的权利属于 Edge0 团队(GitHub: Edge0-AI),本文为独立评测,与官方无关;文中界面 Logo 为作者原创设计
Edge0 推理框架采用 Apache-2.0 许可,模型权重采用 Edge0 Community Model License 1.0(个人使用/研究免费,商用需另行授权)
部署过程参考了官方文档与 edge0-infer 仓库,实测补丁已附在文中
搭建 Web 对话端时的一个通用教训,与 Edge0 无关但值得记录:Windows 上 Python http.server 默认的 SO_REUSEADDR 允许多进程重复绑定同一端口,重启服务前记得 netstat -ano 清理僵尸进程,并设 allow_reuse_address = False
— EOF · SIGNAL NEVER LEAVES THIS MACHINE —
你手上最低配的设备跑过最大的模型是什么?欢迎评论区交流。
