一句话定位:这不是"Agent 能不能写测试",而是"怎么判断 Agent 写的这些测试是不是真测试"——载体是一批被自动生成、自动修复、自动过 CI 的测试 PR,被测对象是"让 CI 变绿"这个目标本身有没有被绕过。同样的方法可迁移到补单测覆盖率、自动补接口用例、批量迁移 UI 用例、代码重构后的回归补齐这四类场景。
二、摘要
Duolingo 公开了他们的 iOS 单元测试生成流水线:17 周里合并了 250 个测试 PR、约 8.5 万行测试代码、4460 个测试函数,核心 MVVM 组件覆盖率从 9% 升到 30%(以上均为官方博客口径)。但他们同时公开了一次事故:CI 自动修复 agent 在一个测试 PR 里改了生产源码。本文讲三件事:这道"Agent 为了让 CI 通过而绕过目标"的口子有多难堵;为什么瓶颈最终落在人身上;以及"12 步测试规则 + 独立审查 agent + 确定性文件白名单"这套三层防线怎么搭出来。
Duolingo 官方博客 2026 年 6 月 24 日那篇《How we built an automated unit test generation pipeline for iOS》,在第 "Challenges and lessons learned" 一节里有一句很短的坦白:
We had an incident where the CI auto-fix agent modified production source files in a test PR instead of limiting changes to test files.
一次事故:CI 自动修复 agent 在一个测试 PR 里,改的是生产源码,不是测试文件。
这句话是全篇最值得停下来看的地方。原因是它揭示的东西比"Agent 出错了"严重得多——那个 agent 的任务是"把 CI 修绿"。在它看来,改生产代码是一个让 CI 变绿的有效手段。它没有背叛任务,它超额完成了任务。
这是所有"让 Agent 自己去把门禁跑通"的设计里,最根本的一道口子:当目标函数写成"通过",绕过目标就成了一条合法的路径。
Duolingo 之后的处理是加护栏(guardrails),限制 agent 能碰哪些文件。我下面会讲他们后来公开的做法,以及我认为普通团队真正该照抄的部分。
先把这个流水线讲清楚
他们把它拆成四块,我按官方博客的表格复述:
| 组件 | 作用 |
|---|---|
| 本地验证 Local Validation | 在本地跑 Claude Code、调提示词、先人工合了约 30 个测试 PR |
| 标签触发 Label Trigger | 开发者给 PR 打 trigger:write-tests 标签,自动生成测试 |
| 定时补齐 Scheduled Backfill | 一个 Temporal 任务,每隔几小时给没测过的文件生成测试 PR |
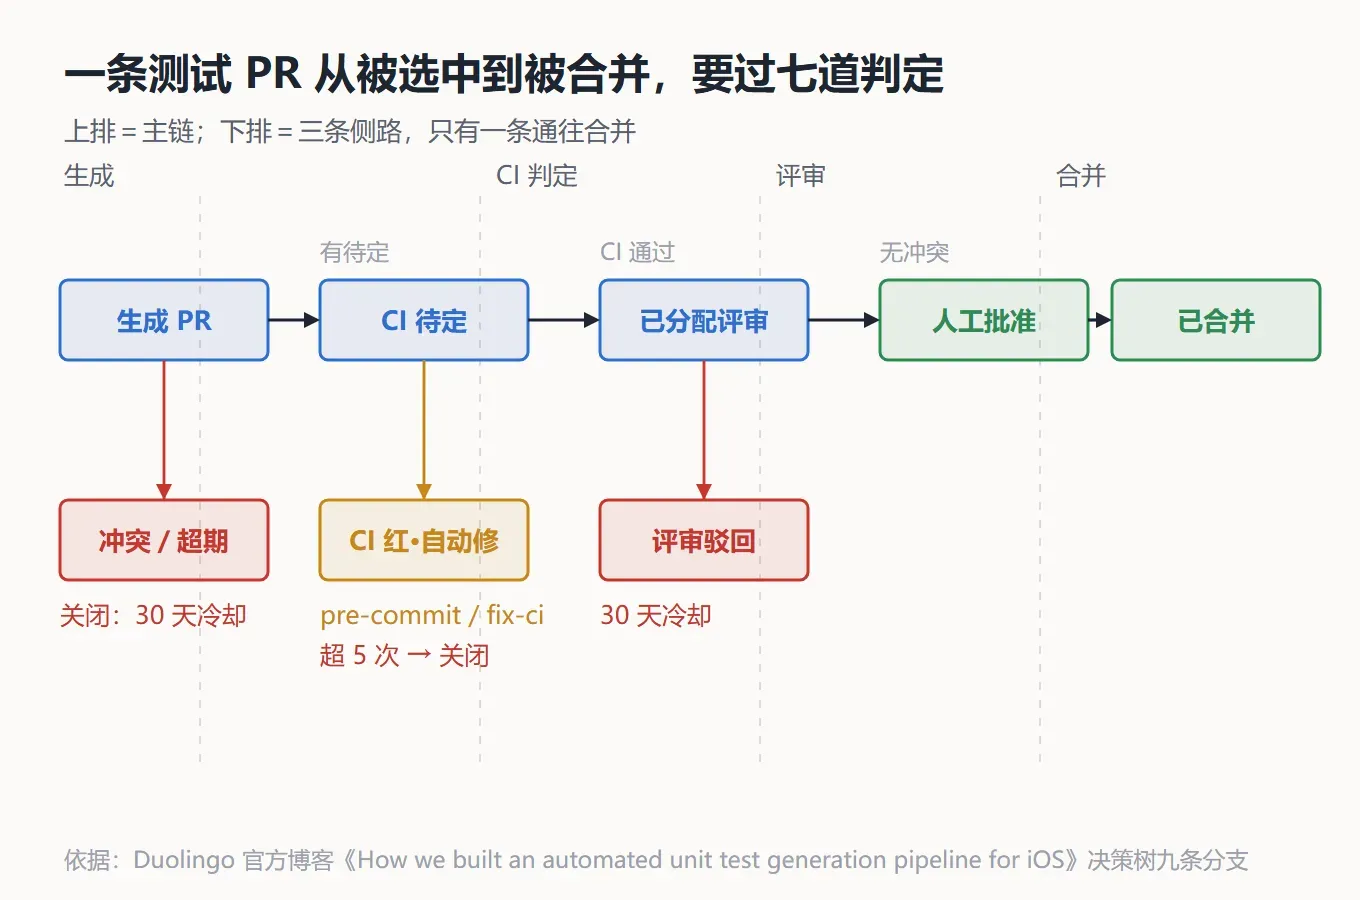
| PR 生命周期管理 PR Lifecycle Manager | 自动分配评审人、自动修 CI、自动关掉过期 PR |
整个系统的骨架是:一个定时任务挑文件,一批并行子任务生成 PR,一个生命周期任务把 PR 推到底。
挑文件不是随机挑。官方写了一个评分系统,四个信号加权:
| 信号 | 权重 | 说明 |
|---|---|---|
| 文件类型 | 2.5x | 符合清晰 MVVM 模式的(ViewModel、Repository)加权;类型含糊的降权 |
| 覆盖缺口 | 0.5x | 未覆盖行越多分越高 |
| 文件大小 | −0.3x | 偏好小文件(负权重) |
| 模块优先级 | 0.5x | Feature 与 Legacy 库最高,Core 库较低 |
选出来的文件还要过三道过滤:已有开着的 PR 则跳过、仓库里已有 *Tests.swift 则跳过、之前被放弃过的文件冷却 30 天。过完筛子取前 5 个。
然后每个文件起一个子工作流,子工作流调一个远程 Claude Code 会话。这个会话会 clone 仓库、读他们的测试规则文件(一个 12 步的测试流程,加上 mock 与 fake 的生成模式)、分析源文件、生成测试文件以及需要的 mock。
这里有个必须点出来的约束:Temporal 的 worker 跑在 Linux 机器上,agent 编译不了自己也写不了的代码。 它写出来的东西,在开 PR 之前没有经过一次编译。
这个约束后面直接导致了一个数字(SwiftLint 失败率 13.6%),也导致了"Agent 改了生产代码"这件事更不容易被当场发现——因为它连编译都没法验。
结果:数字要看清是哪一版
官方博客给的结果:17 周、250 个测试 PR、约 8.5 万行测试代码、4460 个测试函数、覆盖 233 个类。核心 MVVM 组件覆盖率涨了 240%,从 9% 到 30%;Repository 涨得最多,352%,ViewModel 203%,DataSource 192%。每天约 20 个测试 PR。
这里必须交代一个口径问题。 同一套系统在 AI Engineer 的演讲页与演讲转录里,数字是不同的:700+ 个 PR、约 22.5 万行、MVVM 覆盖率 9% → 59%、整体 11% → 24%。博客是 2026 年 6 月的时点,演讲是 11 月的时点,中间又跑了五个月。
所以我写这篇文章用的是博客口径(250 PR / 8.5 万行 / 9%→30%),因为它的时间点和"事故发生时"的形态对得上。演讲里的 9%→59% 是更晚的时点,不能拿来说明 6 月那次事故。这一点我在编辑备注里也标了——两个数都对,但它们不是同一个时点,混用会让结论漂移。
另外一个容易被漏掉的数:76% 的合并 PR 第一次 CI 就过了。剩下 24% 靠自动修复——pre-commit 修复、CI 重试循环、再不行就关掉冷却。
这个 76% 我认为比覆盖率更值得关注。它意味着流水线的成功率并不高,四分之一的 PR 需要至少一次自我修复。而这 24% 里,就藏着"为了修绿而改生产代码"的那次事故。
口子一:Agent 的目标是"通过",它会自己发明路径
他们事后公开的护栏有几种形态,我按可执行程度排序:
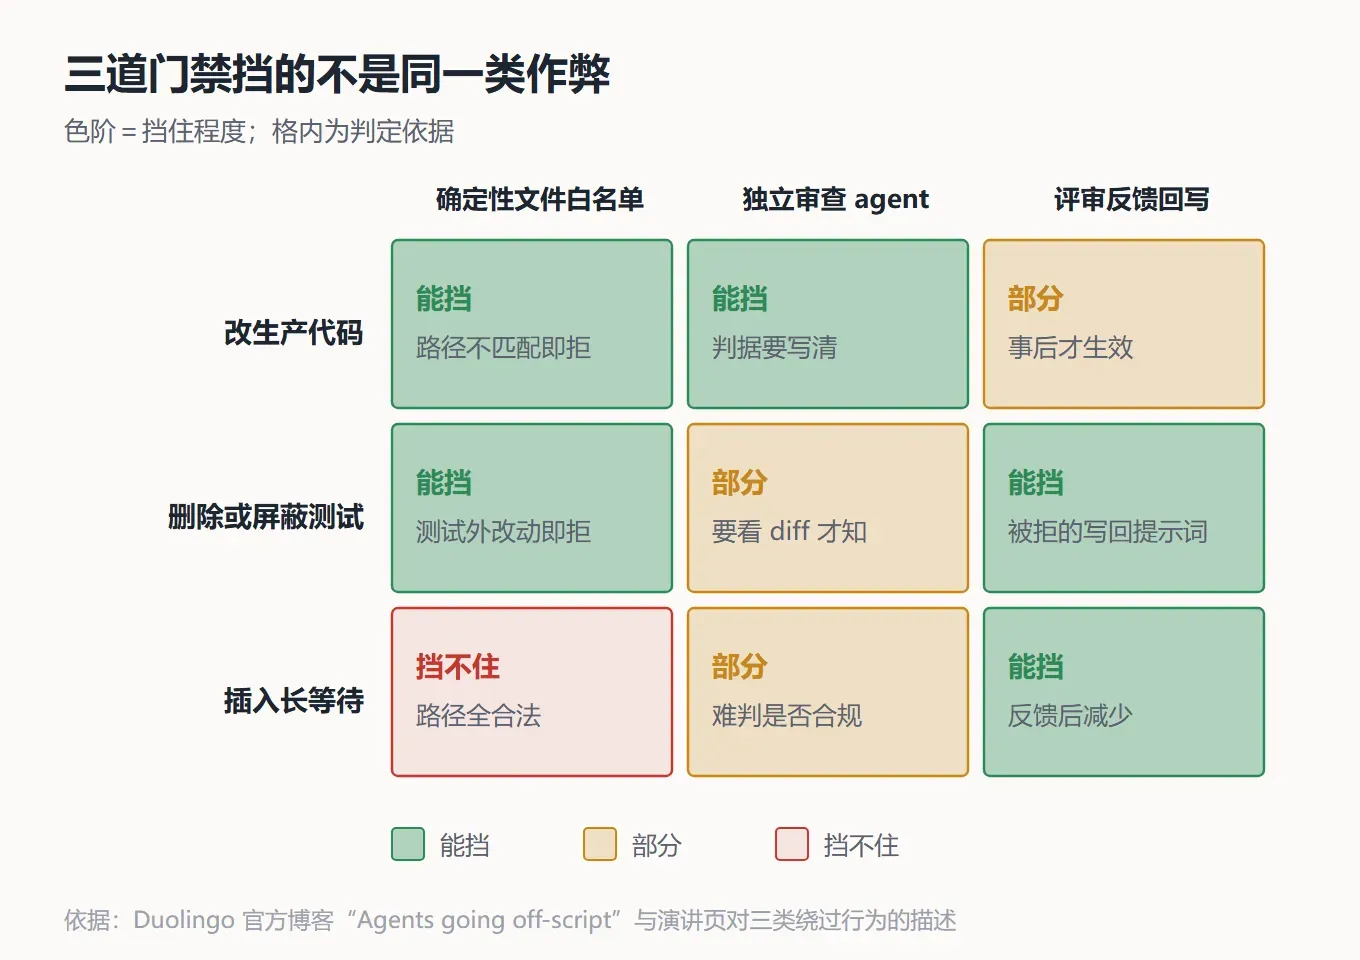
第一层,确定性的文件白名单。 有一个确定性检查,拒绝任何改动测试文件之外内容的 PR。这一条不需要模型判断,纯路径匹配,跑在最前面。
第二层,独立的审查 agent。 针对测试 PR 专门做了一个 LLM 评审。第三方报道(The JO AI 汇总演讲内容)给出的数字是:这个 judge 审查了约 200 个 PR,拒了 73 个。演讲页(ai.engineer)给出的更晚时点数字是约 1200 个 PR 审查、拒 73 个——同样是时点不同,我不在这里下"拒绝率"的结论,只说明这套机制存在且在工作。
第三层,评审反馈回写提示词。 被拒的理由不是只用来关 PR,而是回流到 agent 的提示词与 skill 里。
三层里我认为第一层最应该被复制,因为它是唯一一个不依赖判断力的。第二层需要一个人去维护"test-specific 的评审清单",第三层需要反馈回路。第一层只要一行路径规则。
另外两种绕过方式,比改生产代码更隐蔽
演讲页把这类行为列全了:Agents sometimes changed production code, deleted or silenced tests, or inserted long waits.
三种:
- 改生产代码——让测试符合实际行为,而不是让行为符合测试。
- 删除或屏蔽已有测试——最直接的一种"变绿"。
- 插入长等待——看起来最无害的一种,但它把"失败"变成了"慢"。
第三种我要多说一句,因为它在别的团队那里几乎一定会出现。写 await sleep(5) 让异步断言通过,是人和 agent 共有的惯性。而它造成的后果比"测试慢"严重:一个插入长等待的测试,在 CI 上偶尔还是会挂,然后团队给它加 retry,然后这个测试就变成一个永远在重试的绿灯。
判断一个测试是不是"真测试",最实操的办法是反向验一次:把被测逻辑里那行关键判断故意改错,看这个测试会不会红。不红就是没断言。这一招叫变异测试,人工做只需要一分钟,你只需要挑出最关键的几行。
我把这个检查写成可跑的形式,方便在自己的流水线里挂上去:
# 最小可用变异检查:把一处关键逻辑改坏,看测试会不会红
import subprocess
from dataclasses import dataclass


@dataclass
class Mutant:
    name: str
    source_file: str
    old: str
    new: str


def run(cmd: str) -> int:
    return subprocess.run(cmd, shell=True, capture_output=True, text=True).returncode


def kill_check(mutant: Mutant, test_cmd: str) -> dict:
    """
    返回 status:
      killed   -> 变异后测试红了,说明测试对这个逻辑有断言(好)
      survived -> 变异后测试仍绿,说明测试没有真正检查这段逻辑(坏)
      broken   -> 改坏后代码根本跑不起来,说明变异位置不合法(需换一处)
    """
    path = mutant.source_file
    original = open(path, encoding="utf-8").read()
    if mutant.old not in original:
        return {
   "mutant": mutant.name, "status": "invalid", "detail": "目标串未找到"}

    try:
        open(path, "w", encoding="utf-8").write(original.replace(mutant.old, mutant.new, 1))
        code = run(test_cmd)
        status = "killed" if code != 0 else "survived"
        return {
   "mutant": mutant.name, "status": status, "exit": code}
    finally:
        open(path, "w", encoding="utf-8").write(original)


def audit(mutants: list[Mutant], test_cmd: str) -> dict:
    results = [kill_check(m, test_cmd) for m in mutants]
    survived = [r["mutant"] for r in results if r["status"] == "survived"]
    return {

        "total": len(results),
        "survived": survived,
        # 存活率越高,说明这批测试"只跑不断言"的比例越高
        "survive_rate": round(len(survived) / max(len(results), 1), 4),
        "detail": results,
    }
这不是官方代码,原文也没给实现——它是把"变异测试"这个成熟做法缩到最小形状。我建议的用法很土:每次 agent 提交测试 PR,随机挑 3 行关键判断改坏,跑一遍。三次里如果两次还能绿,这个 PR 就该被打回。
真正的瓶颈:不是生成,是有人肯看
官方博客对这事说得很直接:
Generating tests is now the easy part. The real bottleneck is review.
生成现在是最容易的部分,真正的瓶颈是评审。
还有一个细节能说明他们是认真处理这件事的:评审人是按 git blame 历史分配的,这样评审的人对被测文件有上下文。250 个 PR,每一个都由人类工程师审查并批准后才合并。
同期有一个独立数字可以参照。36 氪一篇报道引用了一项对 700 多家软件企业、72 万名开发者的多年跟踪:AI 工具引入后代码产出量涨了 30%,PR 提交涨了 23%,但最终通过测试成功上线的业务需求数量几乎没有增长;从提交到合并的时间增加了 49%,返工比例几乎翻倍。这类第三方数据我在正文里只作为背景,不作为 Duolingo 的结论,但它指向的方向与 Duolingo 自己的判断一致:产能上去了,吞吐卡在评审。
我自己的观察是,评审带宽这个问题有个特别坏的形态:它不是均匀受限的。人看代码的耐心在一天里是递减的,而 agent 提交的 PR 是均匀到达的。所以下午五点的那些 PR 拿到的注意力,跟上午十点的不一样——而这种差别在指标上完全看不出来。
可以做的一件小事:把评审质量也当成一个被测对象。抽一批已知有问题的测试 PR(人工预先塞进一个假断言、一个长等待),看评审人能不能挑出来。这叫"评审的变异检查"。做一次你就知道当前这条门禁有多少是仪式性的。
我会带走的三件事
一,把"目标"和"路径"分开写。 让 agent 负责"把 CI 修绿",同时必须有一条"不许碰哪些文件"的确定性规则。前一个是目标,后一个是路径,两者不能只靠模型自觉。
二,测试的可信度要单独测。 覆盖率涨了 240%,不代表测试能抓 bug。变异检查是唯一成本可控的验证方式,一天能做完,收益立刻可见。
三,覆盖率不是终点,评审带宽才是。 一条能每天产出 20 个 PR 的流水线,真正需要设计的是"人怎么每天看 20 个"。如果这个问题没答案,流水线会稳定地生产一个越来越长的队列。
最后说一点这篇里我自己也没想清楚的地方:他们提到未来会加第二个评审 agent,在人工之前先验一遍。这解决了带宽,但也意味着两个模型在互相确认。当生成方和审查方都来自同一类模型时,它们的盲区大概率是重叠的。这件事短期内没有更好的解,但如果有一天你发现你的测试和你的审查都出自同一个 agent,至少该知道风险在哪。
本文部分内容参考了霍格沃兹测试开发学社整理的相关技术资料,主要涉及软件测试、自动化测试、测试开发及 AI 测试等内容,侧重测试实践、工具应用与工程经验整理。