
一、问题背景:传统 B2B 独立站的“机器不可读”危机
在近期针对工业品出海独立站的诊断中,我发现一个普遍现象:企业投入大量预算建站,页面视觉精美,但在 AI 搜索引擎(如 ChatGPT、Perplexity)中检索“哪家中国工厂能定制高精度轴承”时,品牌几乎从不被引用。
原因在于架构层面的断层:传统独立站是为“人类视觉”设计的(包含大量图片轮播、公司致辞、需下载的 PDF 参数表),而 AI 爬虫的 RAG 检索层无法从中解析出有效的实体关系和三元组(实体-属性-值)。AI 需要的是能被直接提取、作为答案支撑的“知识块”,而非堆砌的营销话术。
二、案例拆解:GMN Bearing 的 GEO 技术架构
美国精密轴承分销商 GMN Bearing 是这一领域的优秀实践者,其独立站(gmnbt.com)经常被 AI 工具直接推荐。其技术核心并非单纯的内容营销,而是将业务资产进行了极致的结构化改造。
2.1 产品页:从“视觉图片”到“JSON-LD 结构化参数”
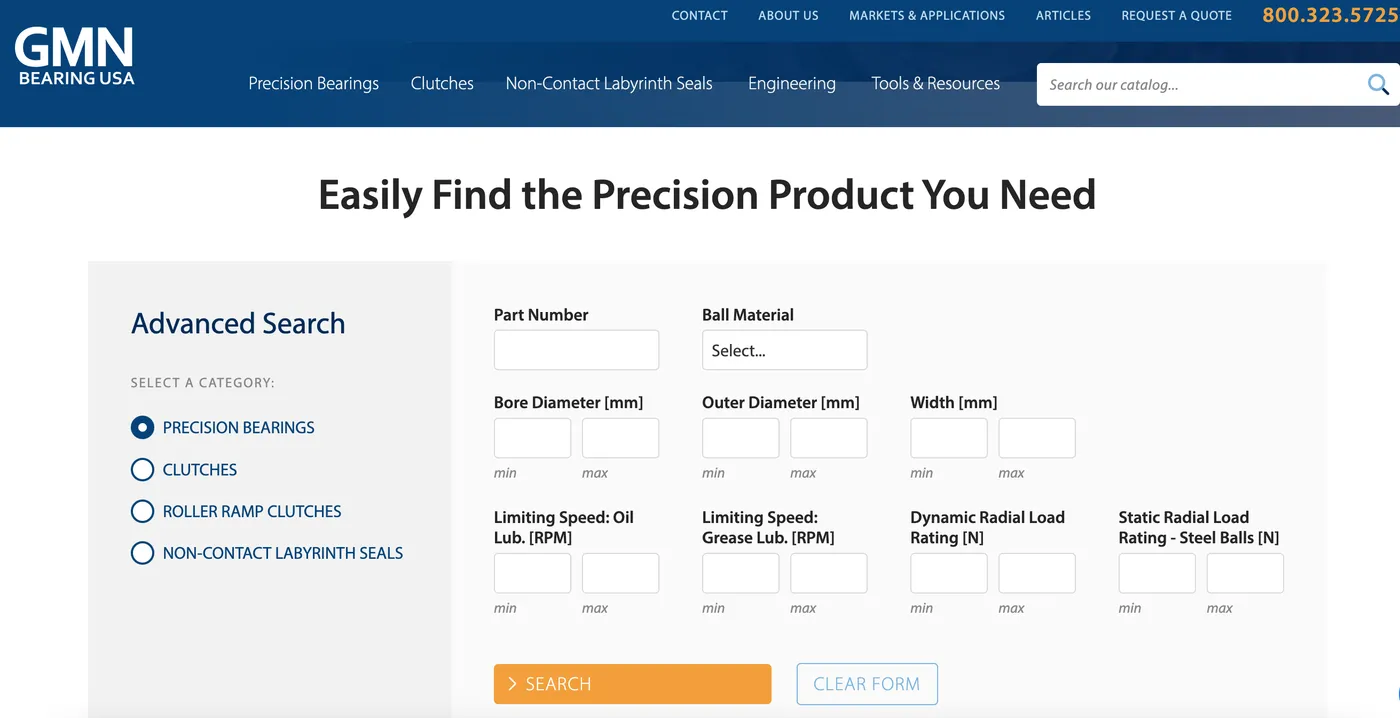
工业品采购的核心是参数对比。GMN 将轴承的内径、外径、极限转速、动载荷等关键参数,从 PDF 手册中提取出来,以 JSON-LD 格式嵌入页面底层。当海外工程师向 AI 提问“推荐一款极限转速达到 67000 RPM 的角接触轴承”时,AI 能直接匹配到 additionalProperty 中的 Limiting Speed Oil 字段,从而将 GMN 列为候选供应商。
2.2 选型页:从“静态说明”到“FAQPage 问答库”
GMN 将工程师日常咨询的高频技术问题(如“脂润滑和油润滑的极限转速差异”、“如何测量预紧力”)直接做成了问答结构。这为 AI 在回答“决策前”的模糊查询时,提供了现成且权威的答案段落。
2.3 架构层:部署 llms.txt 降低爬虫导航成本
传统的 robots.txt 只声明“什么不能抓”,而 GMN 在根目录部署了 llms.txt,以 Markdown 格式清晰列出站点核心页面,极大降低了 AI 爬虫在站内的导航成本,提升了核心页面的抓取权重。
三、分步实操:B2B 独立站 GEO 工程化改造模板
以下代码可直接复用于现有的 B2B 独立站模板。
3.1 第一步:注入 Product Schema
在产品页的 <head> 或 <body> 末尾嵌入以下 JSON-LD。注意:additionalProperty 中的每一项都会被 AI 视为独立的召回候选,参数一定要精确且采用工程单位。
html
<script type="application/ld+json">
{
"@context": "https://schema.org",
"@type": "Product",
"name": "Precision Angular Contact Bearing 7000 Series",
"sku": "GMN-7000-C-T-P4S",
"mpn": "7000-C-T-P4S",
"brand": { "@type": "Brand", "name": "GMN" },
"material": "Chrome Steel / Ceramic Hybrid",
"category": "Precision Bearings > Angular Contact",
"additionalProperty": [
{ "@type": "PropertyValue", "name": "Bore Diameter", "value": "10", "unitCode": "MMT" },
{ "@type": "PropertyValue", "name": "Outer Diameter", "value": "26", "unitCode": "MMT" },
{ "@type": "PropertyValue", "name": "Width", "value": "8", "unitCode": "MMT" },
{ "@type": "PropertyValue", "name": "Dynamic Load Rating", "value": "5.4", "unitCode": "NEW" },
{ "@type": "PropertyValue", "name": "Limiting Speed Oil", "value": "67000", "unitCode": "RPM" }
],
"offers": {
"@type": "Offer",
"availability": "https://schema.org/InStock",
"priceCurrency": "USD",
"price": "0",
"priceValidUntil": "2027-12-31"
}
}
</script>
3.2 第二步:注入 FAQPage Schema
在 FAQ 页面或具备问答功能的页面中嵌入以下代码,覆盖决策前的长尾搜索:
html
<script type="application/ld+json">
{
"@context": "https://schema.org",
"@type": "FAQPage",
"mainEntity": [
{
"@type": "Question",
"name": "How to select the right precision bearing for machine tool spindles?",
"acceptedAnswer": {
"@type": "Answer",
"text": "For machine tool spindles requiring high rigidity and speed, angular contact ball bearings in universal matching (e.g., 7000 series, P4S precision class) are typically selected. Key parameters include bore diameter, limiting speed, and axial rigidity."
}
}
]
}
</script>
3.3 第三步:部署 llms.txt
在站点根目录新建 llms.txt 文件,使用标准 Markdown 语法:
markdown
# GMN Bearing USA
> Precision bearing manufacturer. Engineering support and selection guides for machine tool and turbomachinery.
## Core Pages
- [Product Catalog](https://www.gmnbt.com/products/): Full listing of precision bearings.
- [Bearing Calculator](https://www.gmnbt.com/tools/bearing-calculator/): Compute bearing life and load ratings.
四、验证方法与小结
验证方法:在部署上述结构化数据后,可使用 Schema Markup Validator 检查代码语法;随后在 Perplexity 等具备实时检索能力的 AI 中搜索核心业务问题,观察页面是否被纳入引用源。
工程化小结:B2B 独立站的 GEO 并不是写更多的营销软文,而是把原本闲置在 Excel 和 PDF 里的产品参数、技术选型逻辑,转化为机器可读的结构化知识资产。先完成底层代码与 Schema 的铺设,才是获取 AI 时代免费自然询盘的正确工程路径。
