
现在不少研发团队都接入了 AI 编码工具。打开效能平台,拉取 Git 提交记录、代码行数、PR 合并速度,一套看板摆在眼前,研发的活动轨迹清清楚楚。
DORA 2025 年 AI 辅助软件开发报告里,有一个很实在的结论。AI 会放大团队里原本存在的问题。很多团队直接拿 Git 原始数据做效能观测,报表上的指标持续走高,线上故障慢慢变多,业务产出却没有同步跟上。Git 数据只是代码活动留下的痕迹,不能直接等同于业务价值。AI 写代码普及之后,很多沿用已久的度量逻辑,已经不再适用。今天聊聊实操里最容易撞上的 4 个坑。
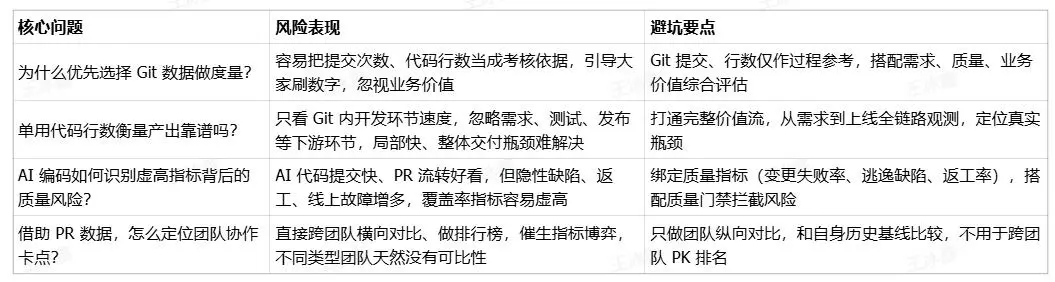
AI 时代研发效能平台 Git 度量 4 大风险速览表
一、研发效能平台,为什么优先选择 Git 数据做度量?
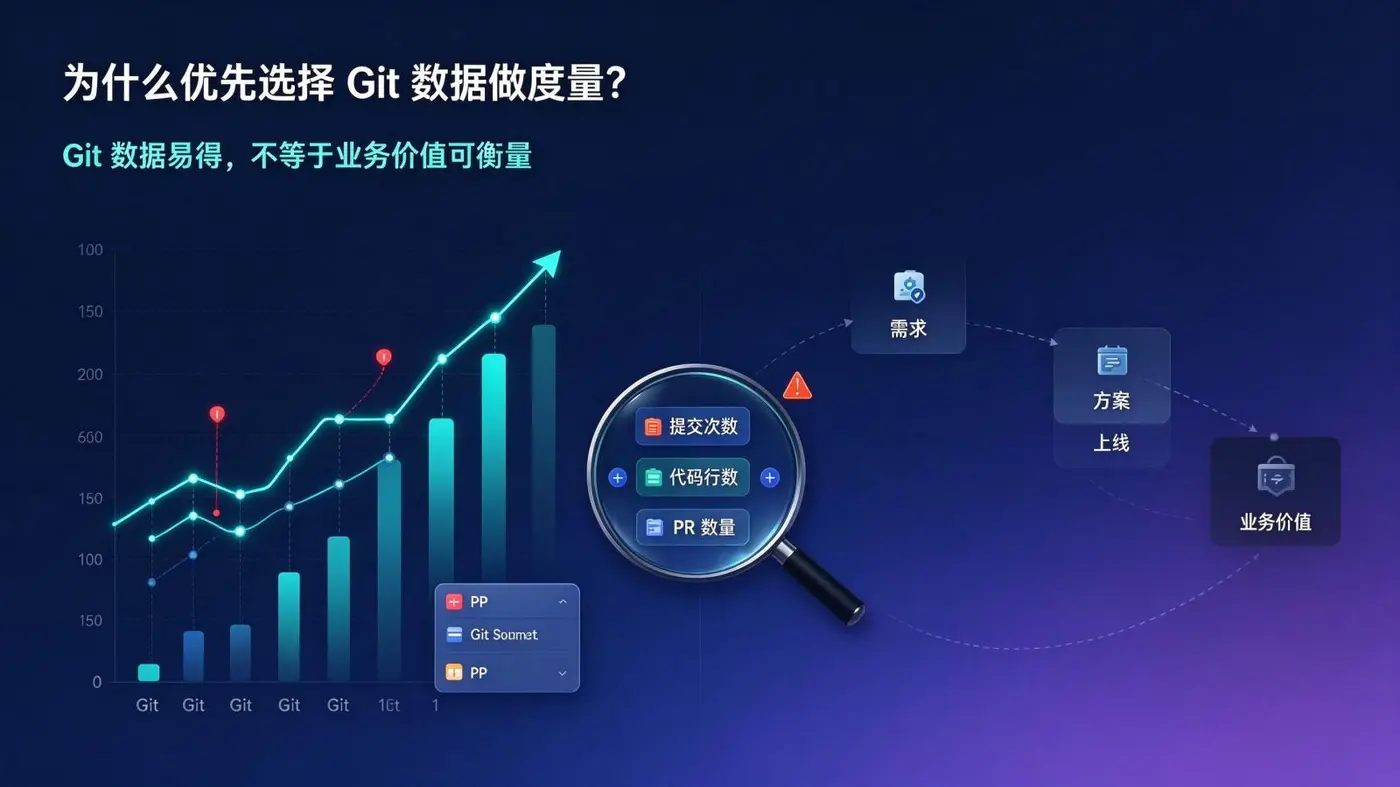
最省事的度量方式,就是直接从 Git 提取数据。提交次数、新增代码行数、PR 数量,这些数据随手就能拿到,平台点几下就能生成报表。
- AI 放大数据虚高问题。AI 可以快速生成大量代码,改动拆分之后,就能产出大量 commit 和 PR。代码行数持续上涨,里面却藏着不少冗余、需要反复调整的逻辑。还有开发者会为了产出更多记录,主动把一次改动拆成多次提交。
- 人为制造无效提交。还有一种情况,工程师花很长时间重构旧系统,清理上千行冗余代码。Git 统计里的代码行数反而变少。单纯依靠 Git 数据,很难看懂这份工作的价值。
- 有一个底层逻辑:度量什么,就会收获什么。把提交行为当成考核依据,大家的注意力会放在优化提交数字,而不是交付有价值的业务功能。Git 记录只能看见发生了哪些动作,看不到这些动作解决了什么问题。
避坑思路:提交次数、代码行数仅作为过程类参考指标,严禁单独用于人员绩效评估。需要搭配需求交付进度、线上质量表现、业务价值落地、技术债务治理成果做多维度综合研判,引导团队聚焦解决业务问题,而不是刻意刷提交指标。
二、在研发效能平台上,单用代码行数衡量产出靠谱吗?
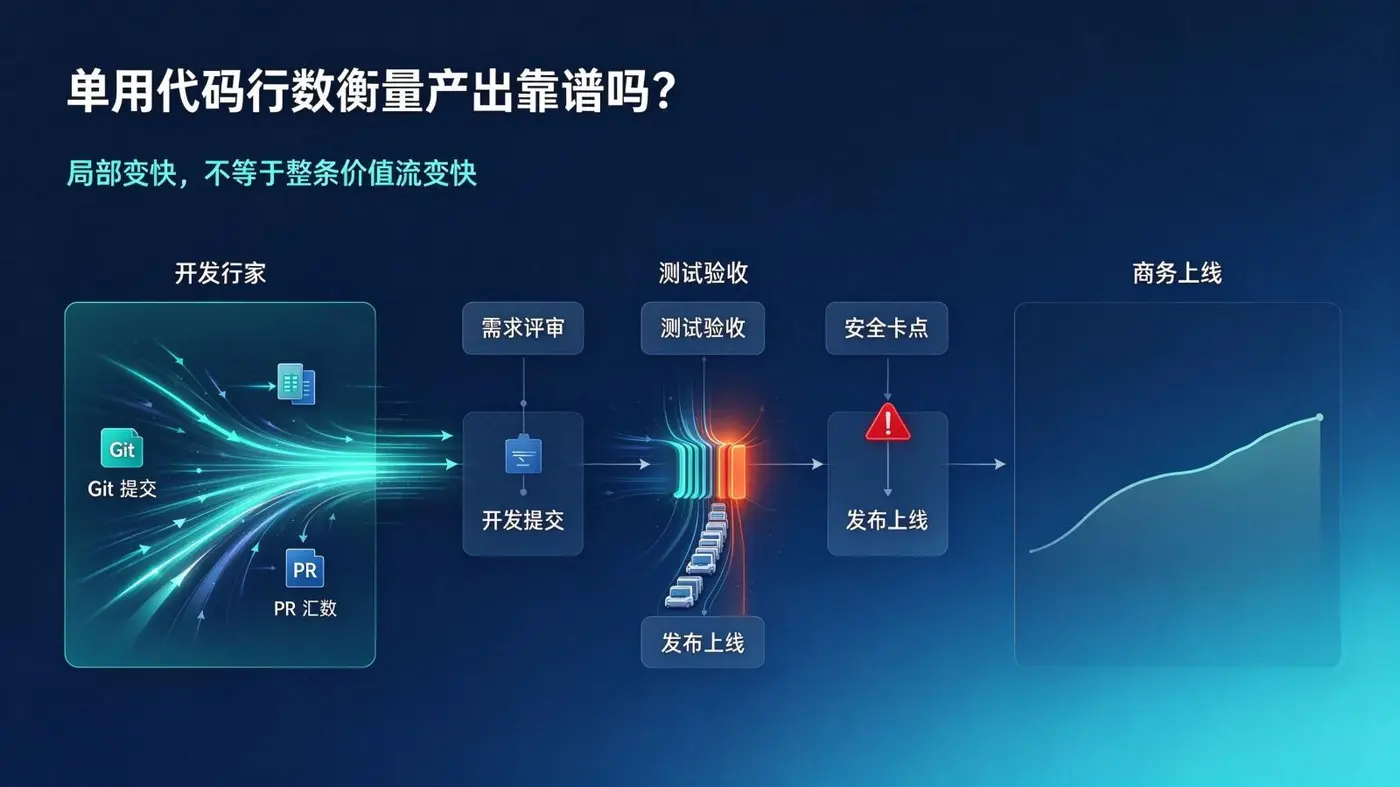
很多效能平台的观测范围,只停留在 Git 仓库内部。从代码提交到 PR 合入,统计这段时间的消耗,把这一段跑快,就认为整体效能提升。
- 完整的软件交付,是一条连贯的价值流。需求评审、方案讨论、测试验收、线上发布,大量环节不会留下 Git 记录。
- AI 带来瓶颈转移,DORA 报告里提到一个普遍现象。AI 缩短写代码的时间之后,瓶颈经常转移到下游环节。代码产出速度变快,代码评审开始堆积,测试排队等待,安全卡点卡住流程,大量时间消耗在 Git 之外。
- 只截取 Git 里的片段做度量,会出现局部环节优化,整体交付没有改善。瓶颈不在开发环节,单纯加快代码提交,整条交付周期不会缩短。团队之间也容易形成边界,开发完成代码合入,后续问题交给下游。
避坑思路:不要孤立看待 Git 数据,打通从需求提出到线上交付的完整价值流,观测范围不能局限于仓库内的开发动作。利用 Git 数据捕捉开发侧信号,同时结合测试阻塞、安全卡点、发布失败等下游记录,定位整条交付链路真正的瓶颈,推动跨角色协同优化,而不是只优化开发单一环节。
三、AI 编码时代,研发效能平台如何识别虚高指标背后的质量风险?
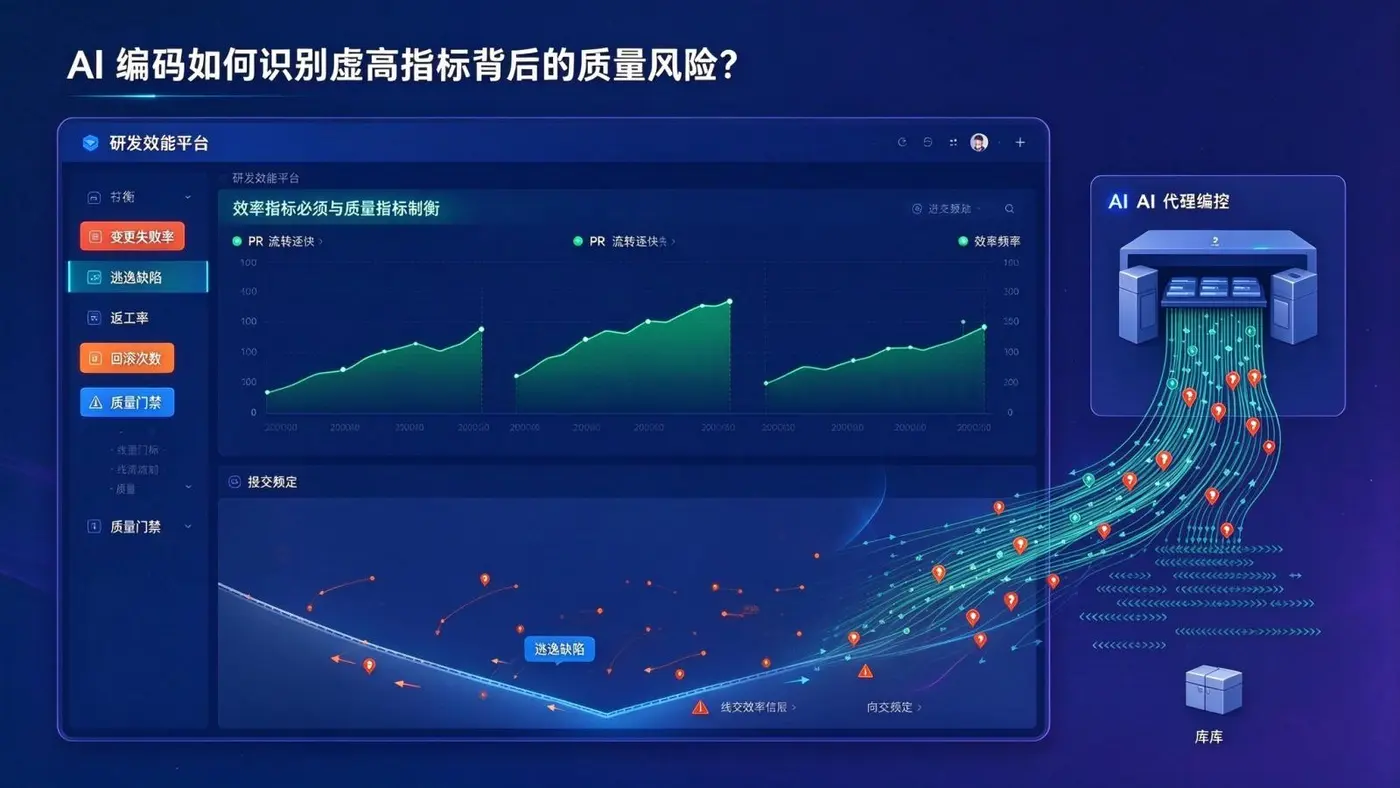
Git 可以记下代码合入仓库的时间,但是识别不出代码里潜藏的质量风险。
- AI 生成代码的提交速度快,PR 流转顺畅,Git 指标看起来十分平稳。DORA 2025 调研里记录,AI 使用率高的组织,更容易出现交付稳定性下滑。代码产出快,潜在缺陷同步变多,后续返工、线上故障慢慢增加。
- 代码覆盖率是很常见的例子。平台抓取 Git 变更统计覆盖率,数值达标,不代表业务场景被充分覆盖,很多异常分支没有校验,问题直到线上才暴露。
- 返工也很难从原始 Git 数据识别。AI 生成的代码合入仓库,隔一段时间需要大量修改、回退。Git 会把它记成新一轮正常提交,报表无法区分,哪些是新增业务开发,哪些是修补前期埋下的问题。
GitFox 的质量门禁,会在代码合并节点加入自动化扫描、评审卡点,提前拦截一部分 AI 代码带来的隐患,把质量指标和 Git 变更数据绑定在一起观测。
避坑思路:效率指标必须配套质量指标形成制衡,持续跟踪变更失败率、线上逃逸缺陷、返工率、版本回滚次数。借助 GitFox 这类平台的质量门禁能力,在 PR 合并节点设置自动化扫描、规范评审卡点,将质量校验和 Git 变更绑定,及时识别 AI 代码带来的隐性技术负债,避免只追求流转速度而牺牲质量。
四、借助研发效能平台的 PR 数据,怎么定位团队协作卡点?
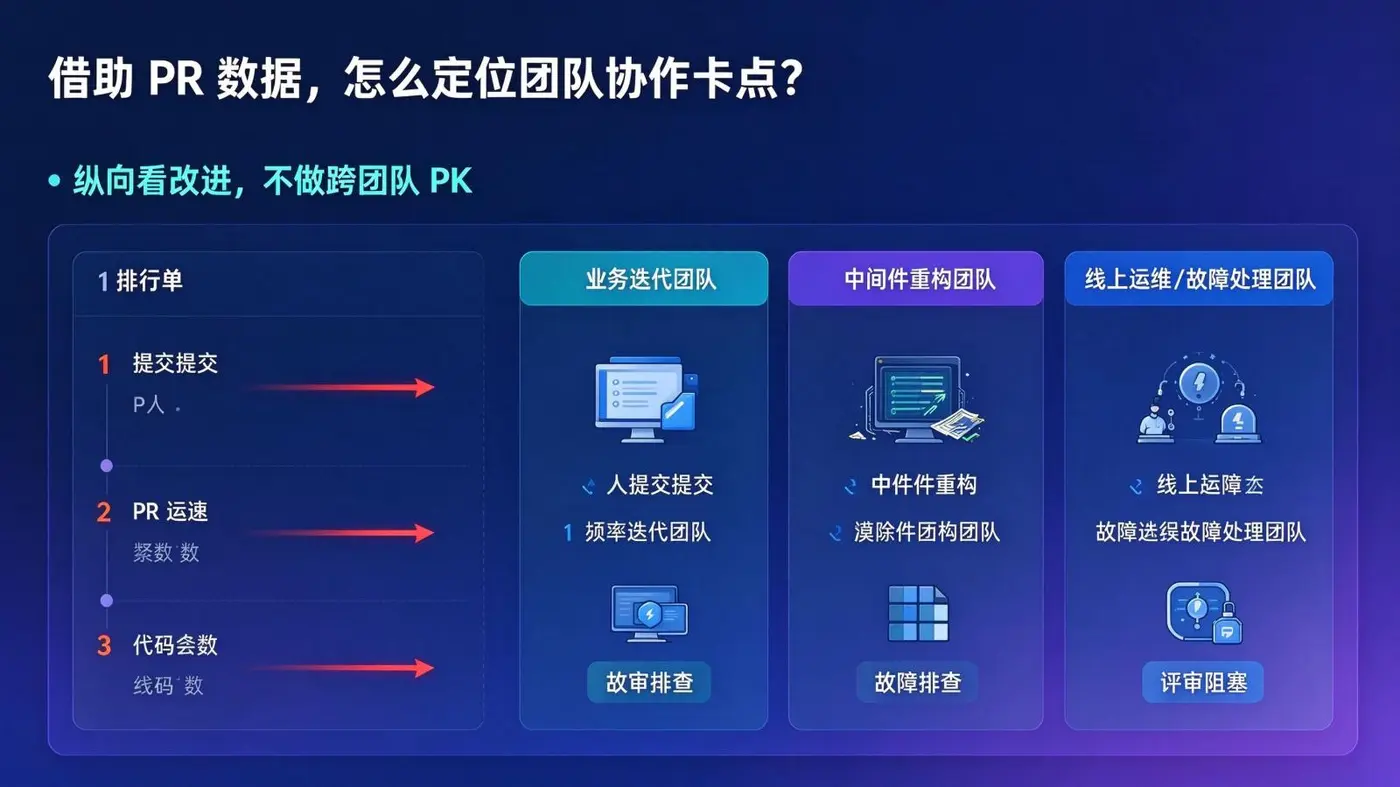
效能平台汇总各个团队的 Git 数据,生成排行榜。提交多、PR 流转快的排在前面,其余团队落在后面。这种方式看起来直观,背后藏着不少问题。
- 不同团队的工作内容本身不一样:有的团队持续迭代业务,高频新增代码;有的团队做中间件重构,以修改、删减旧代码为主;还有团队大量时间投入故障排查、线上运维,Git 提交量本身偏少。直接用 Git 原始数据横向对比,本身就不公允。
- 当团队知道 Git 数据会用来排名,指标博弈就会出现。为了加快 PR 合并速度,评审环节放宽标准;为了拉高提交数量,拆分没有业务意义的小 commit。DORA 报告持续提醒,指标优先服务团队自身的纵向改进,用来观察自身变化,而不是跨团队比拼。
- AI 普及之后,这种差异会进一步放大。部分团队 AI 工具普及度高,提交数据天然偏高;另一部分团队会花更多精力校验 AI 产出,提交记录偏少。单看 Git 数据,很难还原真实的研发状态。
避坑思路:Git、PR 流转数据只用于团队纵向自查,和自身历史基线对比,跟踪流程改善趋势,不制作跨团队排行榜、不用于团队之间 PK。解读指标时区分团队业务属性,结合业务类型判断 PR 堆积、评审时长是否合理,用来定位评审资源不足、评审标准不统一、接口依赖阻塞等真实协作卡点。
写在最后:使用研发效能平台做度量,要守住什么核心原则?
AI 普及之后,很多团队形成一个误区。效能平台可以抓取 Git,就把 Git 数据当成度量的全部答案。
Git留存了完整的开发痕迹,是很好的问题排查工具。观察 PR 堆积,可以发现评审卡点;观察同一模块反复改动,可以提前感知代码风险。
但我们不能本末倒置。度量的初衷,是帮团队找到瓶颈、持续优化,不是简单统计代码产出速度。
守住一条简单的准则。如果一项指标,无法牵引业务价值和质量同步提升,就不适合作为核心评判依据。Git 数据可以拿来参考,不能独自承担全部的度量工作。
