随着 RVV、Zkn/Zvk 等扩展特性日趋成熟,如何让基础软件充分利用硬件能力,正成为推动 RISC-V 规模化商用的重要课题。压缩、加解密、多媒体等核心基础软件仍存在依赖通用 C 实现、未能充分发挥硬件算力的情况,软硬件协同断层也由此成为平台从可用走向好用需要解决的问题。
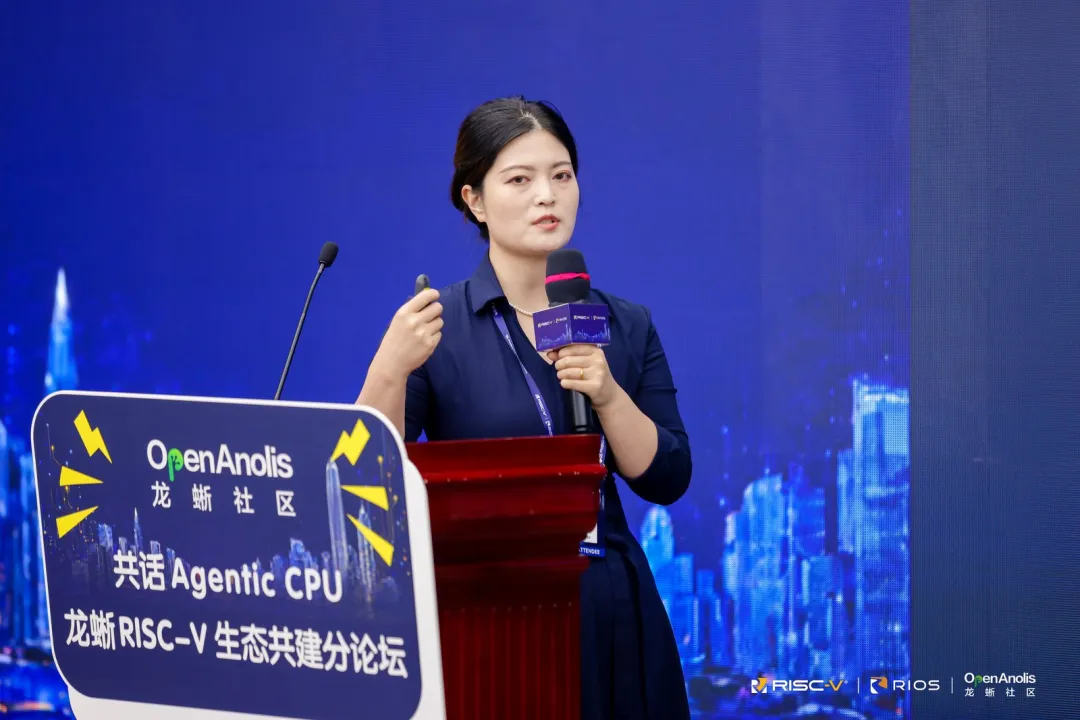
在2026 RISC-V Summit 中国峰会龙蜥分论坛上,中兴通讯性能优化高级工程师、龙蜥社区 RISC-V ARCH SIG Maintainer 兰静围绕基础软件的工程化与性能优化,分享了中兴通讯在 EC 纠删码、加解密和 Adler-32 等场景中的实践。从软件生态现状、优化方法到在龙蜥社区、如意社区等的开源贡献,这些探索展现了基础软件连接硬件能力与业务价值的作用,也为 RISC-V 生态共建提供了实践参考。
(图/兰静)
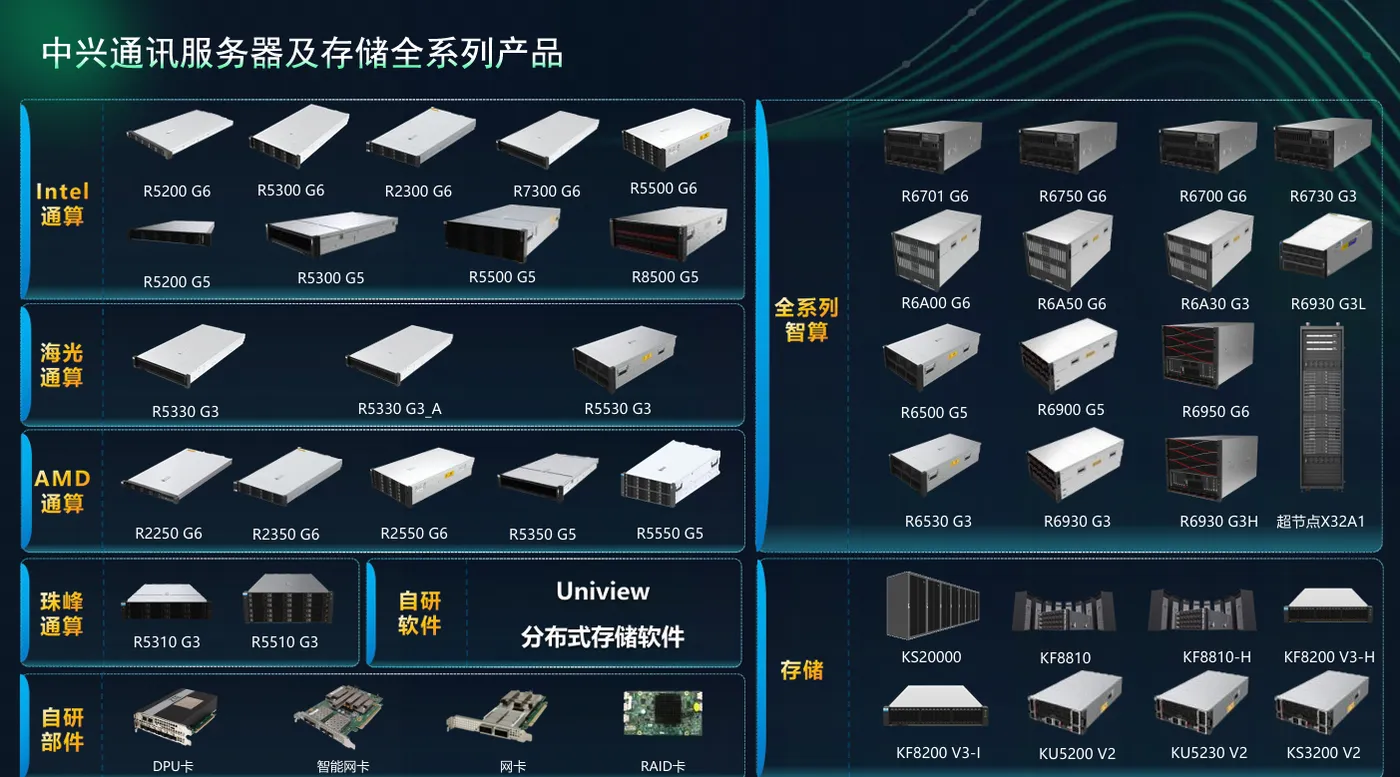
基础软件的工程化建设,首先需要面向真实业务需求。兰静介绍,中兴通讯近年来在服务器领域保持较快增长,国内智算服务器增速排名第一,2025 年营收同比增长 200% 以上,在电信行业的 x86 服务器发货量排名第一。围绕行业市场,中兴通讯持续投入,并形成了涵盖研发、供应链、制造和服务的专业能力。
在产品布局上,中兴通讯覆盖通算、智算和存储三类场景。通算产品包括基于英特尔、海光、AMD 等平台的 x86 机型,以及采用珠
峰自研芯片的 ARM 机型;配套的自研软件和部件涵盖 DPU卡、网卡、RAID 卡等。智算领域则形成了包括超节点在内的全系列产品,并配套提供存储产品。
以这些业务场景为参照,中兴通讯从实际落地的角度建立软件生态成熟度模型,以商用为目标评估和推进 RISC-V 软件生态建设。评估不仅关注软件包数量,还综合考察架构支持程度、应用成熟度、编译器与工具支持,以及开源社区活跃度。
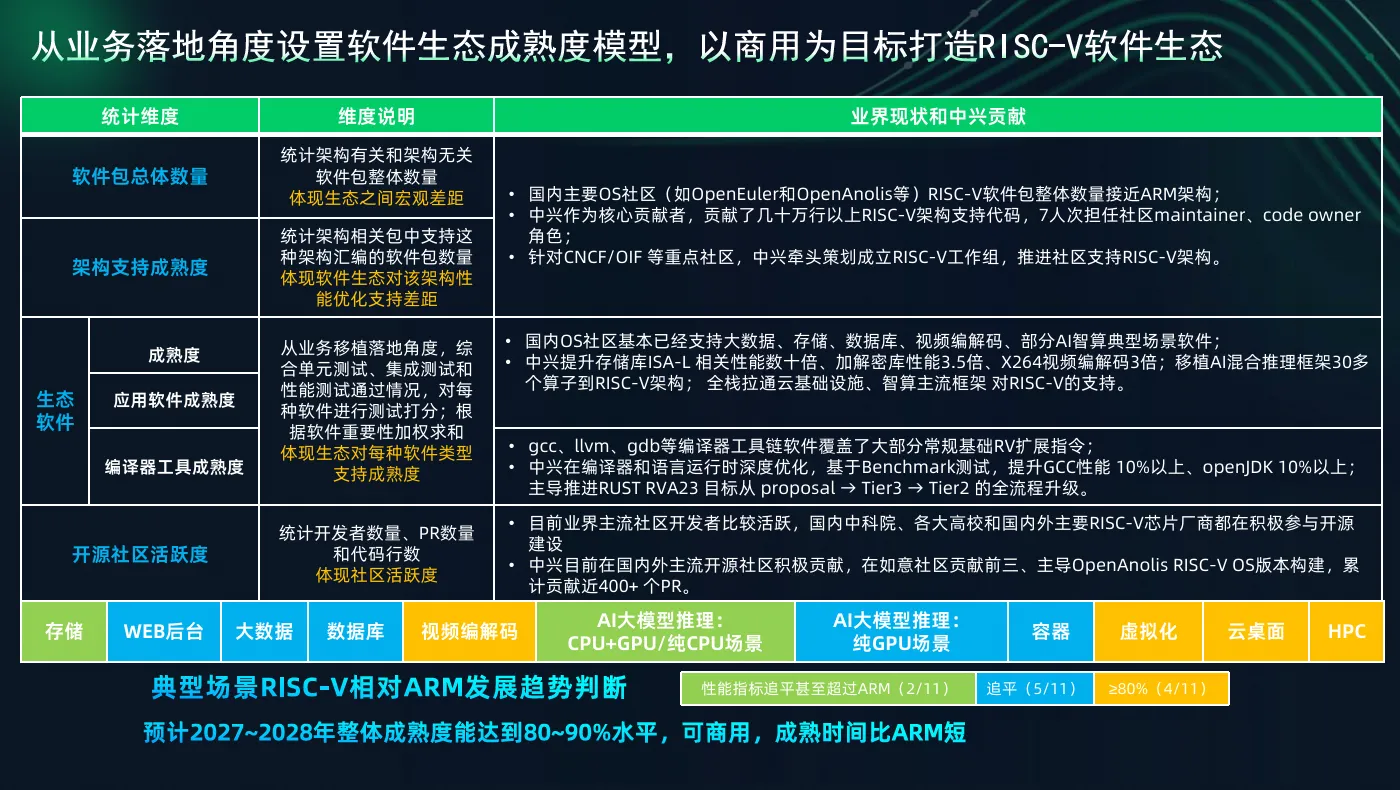
从软件包数量与架构支持看,龙蜥等国内主要 OS 社区的 RISC-V 软件包总体数量已接近 ARM 架构,中兴通讯也参与了相关生态建设。从应用成熟度看,国内 OS 社区已基本支持大数据、存储、数据库、视频编解码,以及部分 AI 智算场景。编译器和工具方面,GCC、LLVM、GDB 等已覆盖大部分常规 RISC-V 基础扩展指令,具备基本可用条件。与此同时,中科院、高校及国内外 RISC-V 芯片厂商持续参与开源建设,主流社区的开发者保持活跃。
在典型场景的性能评估中,中兴通讯团队对 RISC-V 相对于 ARM 的发展趋势形成了阶段性判断。兰静表示,团队认为存储、AI 大模型推理等部分场景的性能指标已追平甚至超过 ARM;其中涉及 GPU+GPU 或纯 CPU 场景。Web 后台、大数据、数据库等场景基本追平 ARM,而视频编解码、虚拟化、云桌面和高性能计算仍有提升空间。团队预计,到 2027—2028 年,整体成熟度有望达到 80%—90%,具备可商用条件。这一判断反映的是团队对生态演进的预期,而非对所有场景当前状态的统一结论。
基础软件:连接硬件能力与业务价值
除软件包和应用支持外,生态建设还需要重视基础软件层。兰静及其团队与中兴微同事围绕这一层开展了相关工作。中兴通讯同时在指令集、OS 和工具链等方面持续优化,相关成果已合入社区。
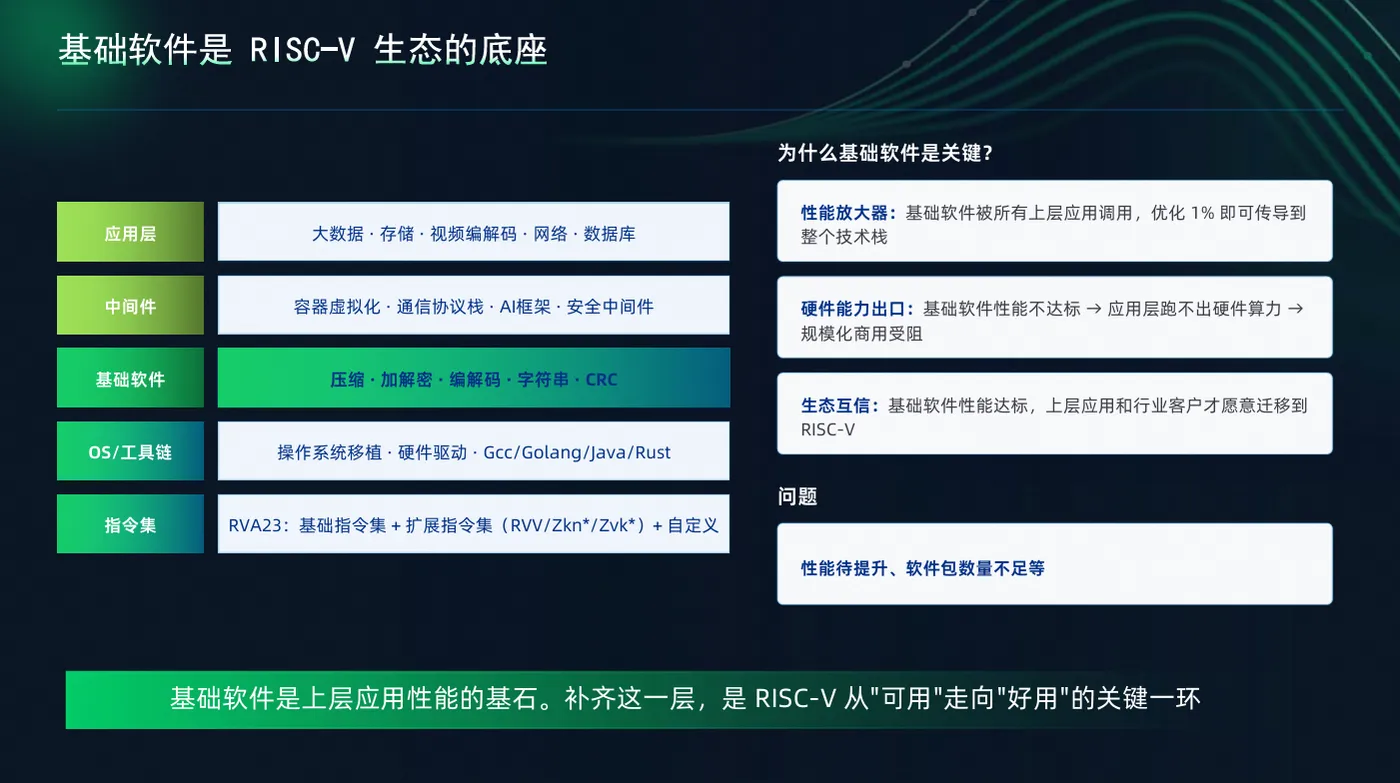
基础软件承上启下,是 RISC-V 生态的底座。兰静将其作用概括为性能放大器、硬件能力的出口,以及建立生态互信的重要基础。上层软件和技术栈广泛调用基础库,如同建筑依赖地基,基础层的优化可以传导至存储、数据库等关键领域。即使是基础软件或基础库 1% 的优化,也可能为上层场景带来收益,相关实践已体现出这一层优化的价值。这种价值还体现在硬件能力能否有效释放。硬件性能再强,如果基础软件不能充分适配,算力优势就难以转化为业务表现,甚至影响商用推进。只有基础软件性能达到应用需求,上层应用和客户才更愿意迁移到 RISC-V,生态互信也才能获得更扎实的支撑。
看到基础软件的关键作用,也需要正视当前生态的不足。一些关键组件仍有性能提升空间,软件包及其依赖也尚未完全补齐。例如,团队在龙蜥社区引入 x264 时,仍会遇到相关依赖缺失的问题。因此,生态建设既要扩大软件覆盖范围,也要提升关键组件的性能与可用性。补齐基础软件这一层,是 RISC-V 从可用走向好用的重要环节。
以优化成果推动上游贡献与发行版落地
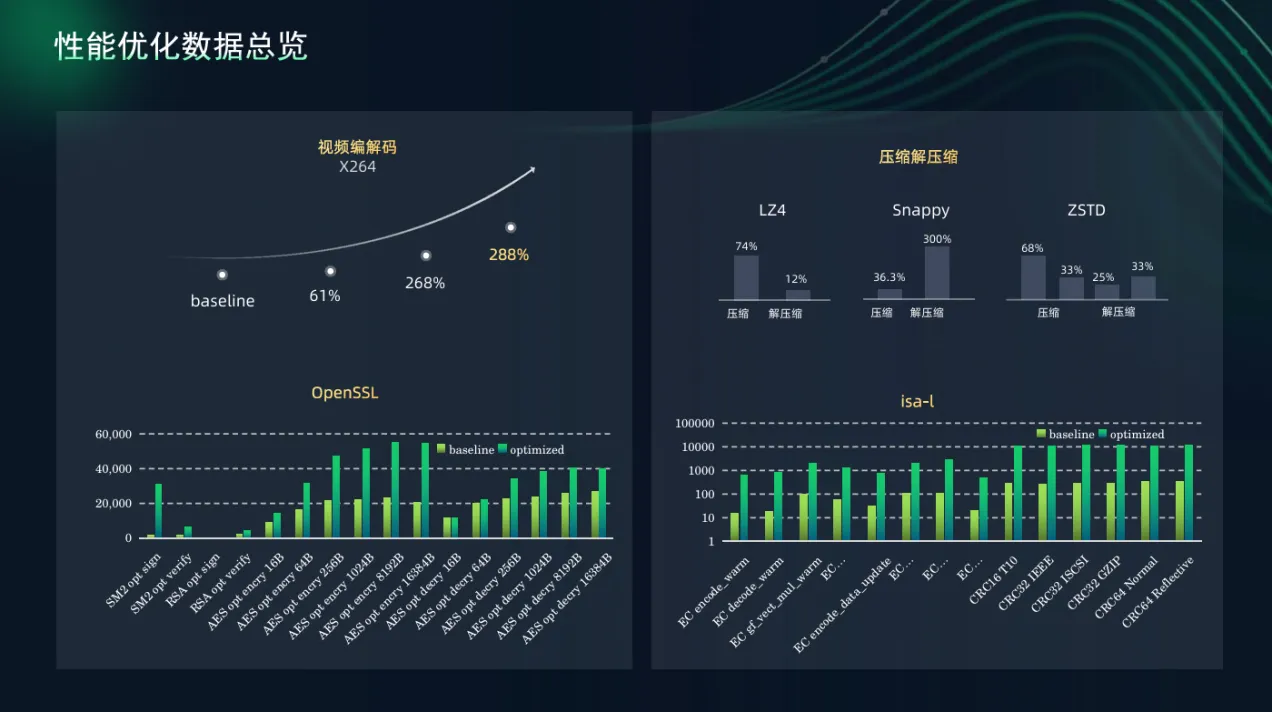
针对性能与依赖方面的缺口,中兴通讯围绕多媒体、压缩、加解密和存储基础库持续开展优化。在视频编解码领域,x264、x265 优化后的性能相比原来基本上提升到 200% 以上;FFmpeg 中的 H.264、H.265 解码也取得了显著优化效果。主流压缩库 LZ4、Snappy、ZSTD 等重点组件均有改善,其中 Snappy 解压缩性能提升 300%。团队也持续推进 zlib、zstd 等相关库的优化。
在加解密领域,团队重点优化 SM2、SM4 及 AES 等算法,其中 SM2 性能提升 3.5 倍以上。在存储基础库 ISA-L 中,优化覆盖 EC 纠删码、CRC 校验和 Adler-32 等算法,EC 相比原始实现性能提升 30 倍,CRC 提升十几倍以上。相关成果已合入上游社区及相关 OS 社区。
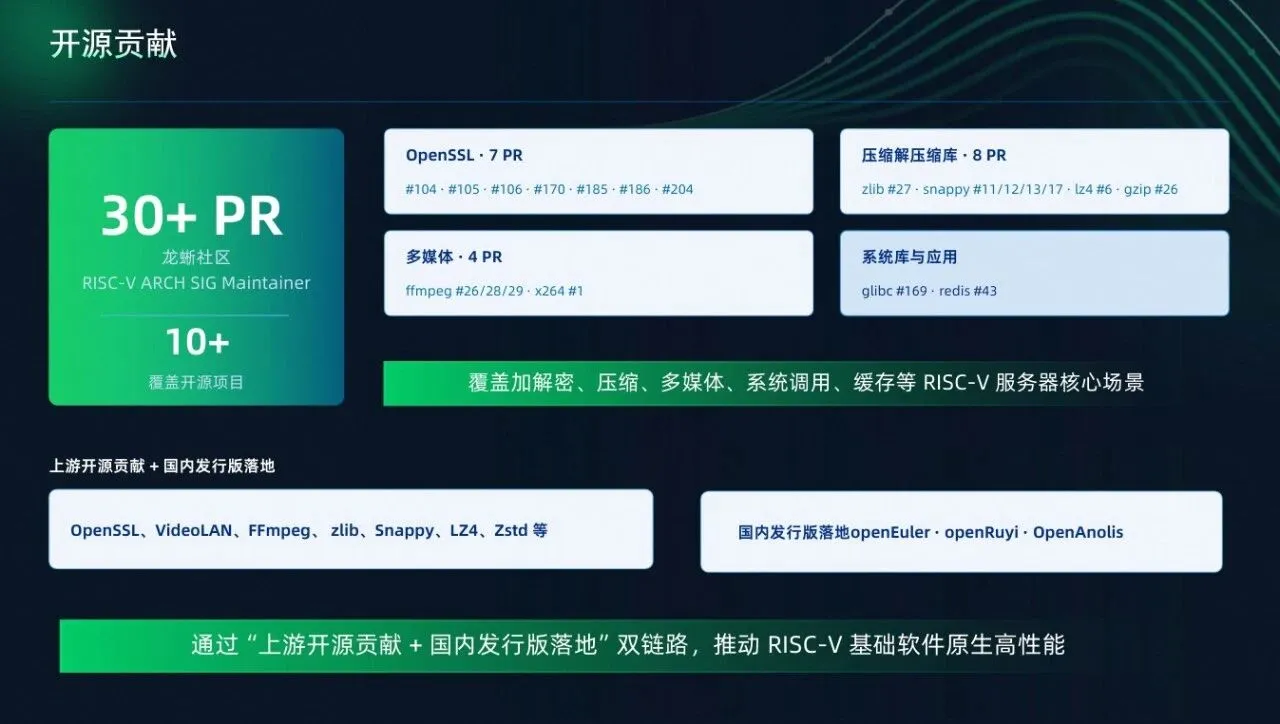
性能优化的价值不仅在于单项测试结果,也在于成果能否进入社区并在发行版中持续落地。为此,中兴通讯坚持上游开源贡献与国内发行版落地的双链路原则。兰静及其团队已在龙蜥社区基础软件领域合入三十多个 PR,并持续面向 Anolis OS 23.6 推送代码。作为龙蜥社区 RISC-V ARCH SIG Maintainer,兰静也参与日常代码评审与相关工作,积极为社区贡献自己的一份力量。
目前,相关优化涉及十多个开源项目,覆盖加解密、压缩、多媒体、系统调用、缓存等 RISC-V 服务器核心场景。通过上游贡献与发行版落地协同推进,团队持续推动基础软件原生支持 RISC-V 高性能特性。
从热点定位到回归验证,建立优化闭环
围绕上述实践,中兴通讯内部逐步形成了从 profiling 到回归验证的性能优化闭环,强调以数据定位瓶颈,以代码优化解决问题,再以功能、兼容性和性能验证判断效果,而不是仅凭经验或单项性能指标作出结论。
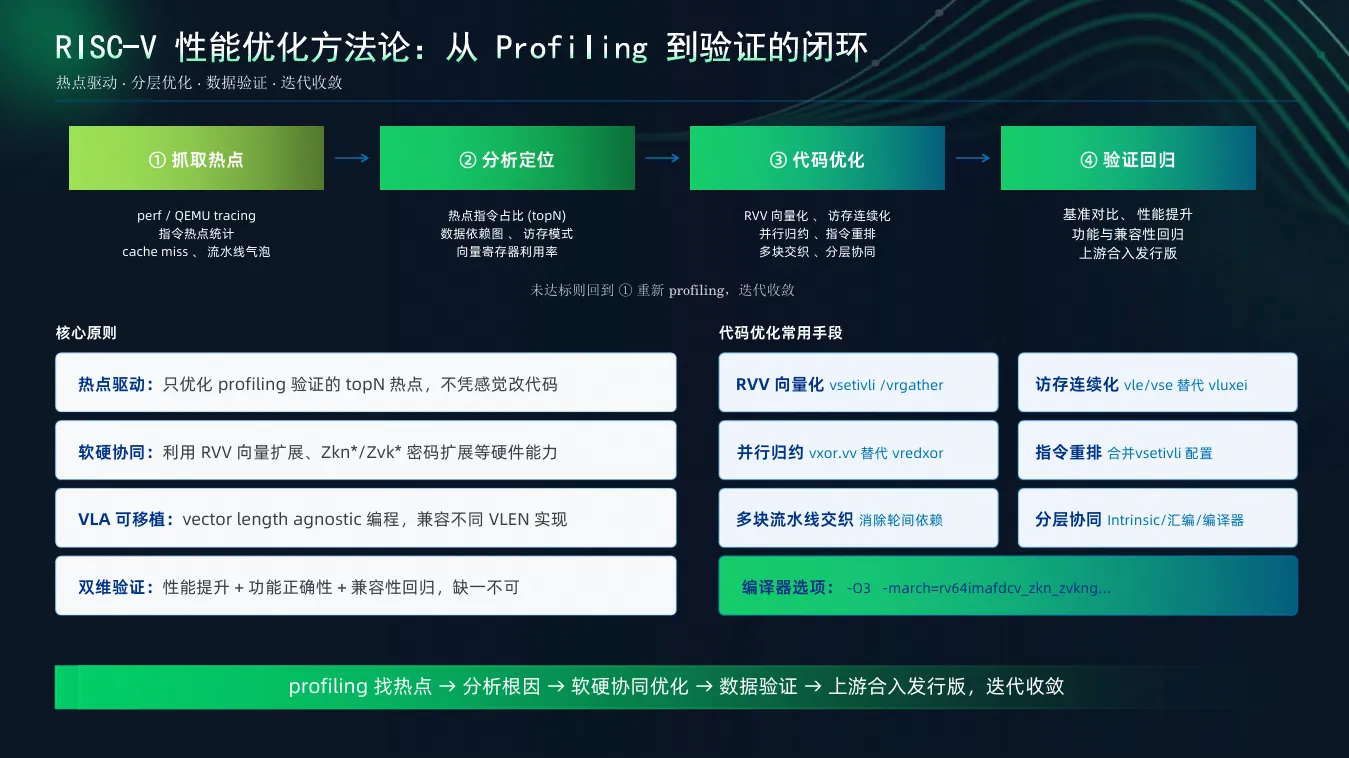
这一闭环从热点采集开始。团队通过 perf、tracing 等工具获取热点与统计信息,结合 cache miss、流水线气泡等指标寻找关键瓶颈。优化遵循热点驱动原则,仅优化 profiling 识别出的 Top 级热点,确保优化依据可追溯。随后,再结合数据依赖关系分析问题,判断瓶颈位于核内执行、访存,还是指令切换效率等环节。
在定位问题后,选择与瓶颈相匹配的代码优化手段,包括 RVV 向量化、访存连续化、并行归约、指令重排、多块流水线交织,以及分层协同等。不同方法并非孤立使用,而是根据具体算法和执行特征组合应用。
优化完成后,还需要进行回归验证。性能数据达到预期只是其中一项要求,功能正确性和兼容性同样需要得到保证。验证通过后,相关优化再向上游或 OS 社区贡献;若未达到预期,则重新进入热点采集、分析定位和代码优化过程,持续迭代。针对EC 纠删码、加解密与 Adler-32 三个案例,具体展示了这一方法论如何转化为实际优化。
EC 纠删码:协同优化查表、访存与归约
在 EC 纠删码场景中,团队围绕查表内化、访存连续化和并行归约三个方向展开优化,分别减少频繁查表、离散访问和横向归约带来的开销。
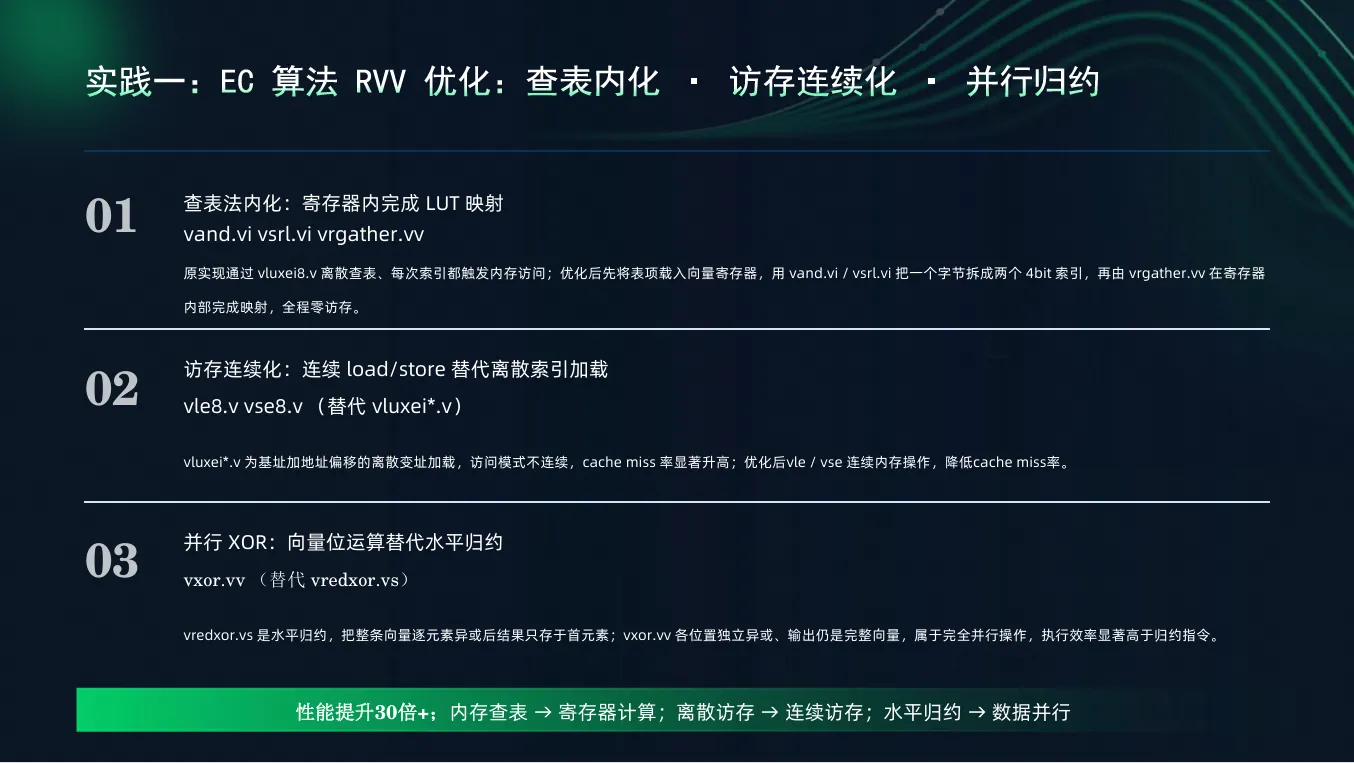
查表内化首先改变了数据查找的位置。原有实现采用离散查表,大型表项存放在内存中,每次索引都需要访问内存,频繁的数据访问带来较高耗时。优化后,先将表项载入向量寄存器,再借助向量指令将字节拆分为两个 4 bit 索引,在寄存器内部完成映射。由此,查表环节能够避免反复访问内存,将原本频繁的内存查找转为寄存器内查找。
在查表之外,数据的访问方式同样影响执行效率。针对基址加地址偏移的离散变址加载及其带来的 cache miss,采用 vle、vse 等连续内存操作,实现连续 load 和 store,减少离散访问造成的开销。
完成查表与访存优化后,进一步调整异或与归约方式。原有水平归约需要将整条向量的元素异或后写入首元素,具有较高资源开销。优化则采用向量位运算,使各个位置独立完成异或输出,以多条路径并行执行的方式减少水平归约开销。查表内化、访存连续化和并行异或共同作用,该案例获得了三十多倍的性能提升。
加解密:协同运用密码指令与流水线调度
EC 案例侧重数据查找、访存与归约,加解密场景则进一步体现了指令选择和执行调度的重要性。团队采用 Zvk 等密码指令编写手写汇编,并应用于重点加解密算法;同时,通过多块循环交织,结合微架构特性,争取在每个周期发射多个独立块的轮次,充分利用硬件执行单元。对于开销较大的指令配置,则通过算法和指令重排消除冗余,减少 vsetivli 配置开销。
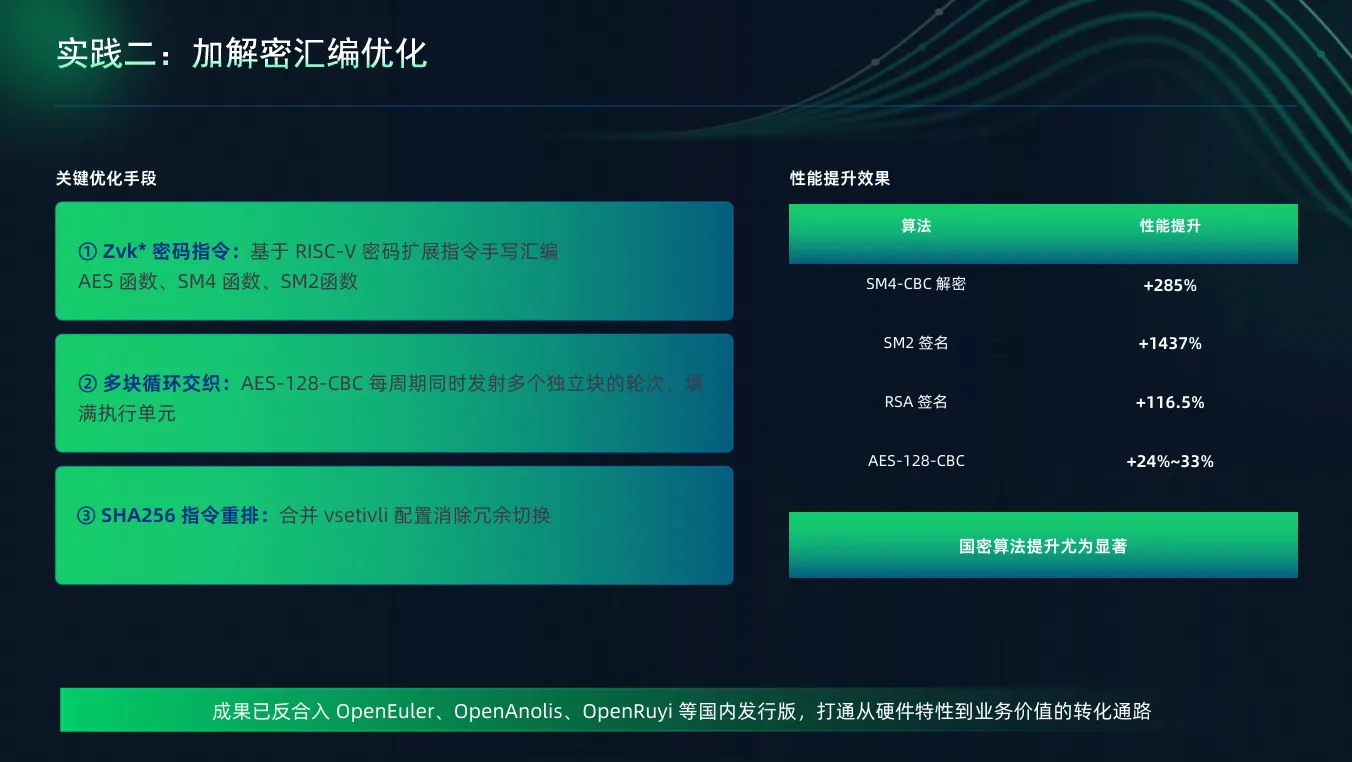
兰静介绍,相关优化在国密算法中取得了较明显的效果,分享中给出的部分结果为性能提升 14 倍以上。相关成果已合入龙蜥、如意等社区,旨在打通从硬件性能到业务价值的转换通路。SHA-256 与 AES-CBC 的实践,进一步说明了这一优化思路。
SHA-256:通过指令重排复用向量配置
在 SHA-256 的原有流程中,进入第五步主循环前需要进行预加载。第一步加载 SHA-256 轮常量,第二步重排哈希,第三步设置掩码,这三个步骤相互独立。常量加载与哈希重排涉及相同的 vsetivli 4 e32 配置,因此存在配置复用的优化空间。
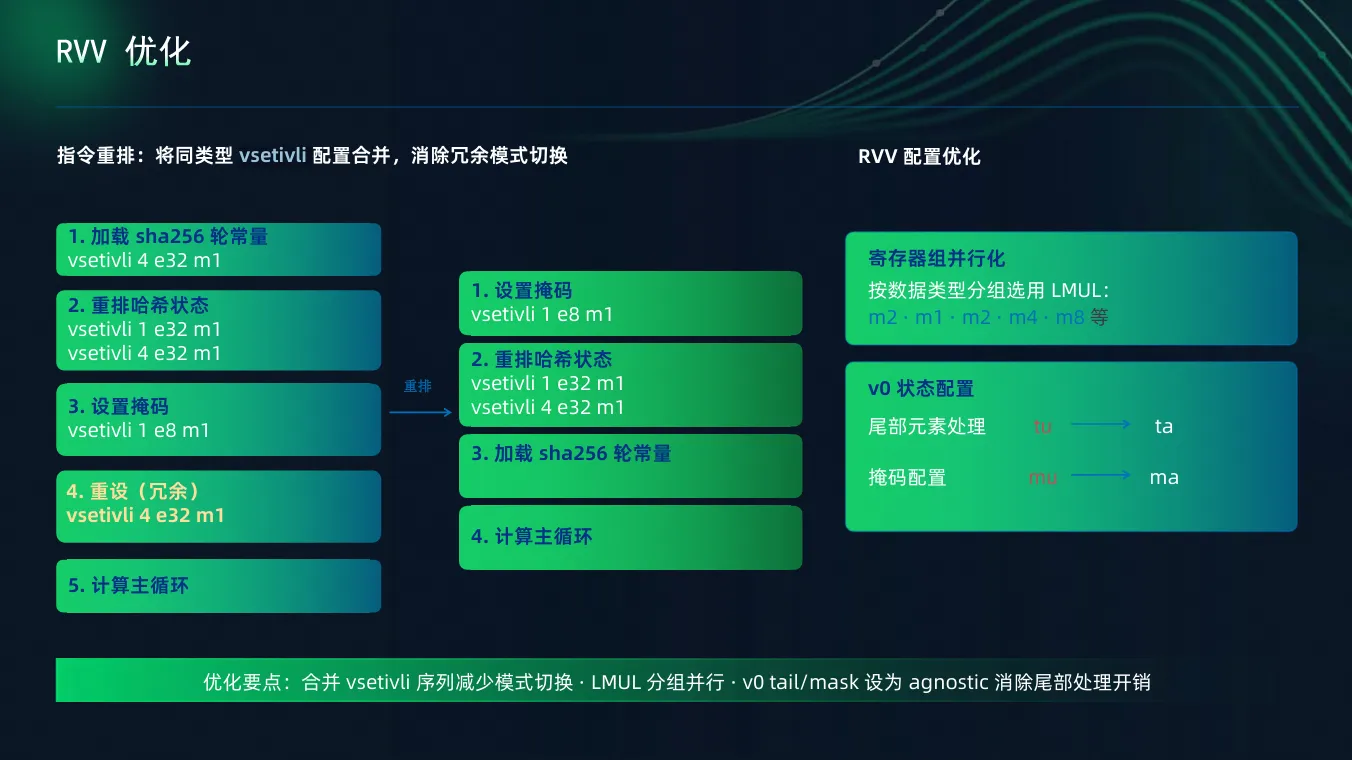
据此重排流程,先设置掩码,再重排哈希,随后复用当前配置加载 SHA-256 轮常量,避免频繁重复设置 VL、vtype 等参数。原有第四步的重设操作因而可以减少,流程中省去了 2—3 条 vsetivli 指令,降低了配置开销。
除指令重排外,RVV 配置还需要与数据块特征相匹配。例如,根据数据块大小选择寄存器拼接或使用一半,分别对应大数据块和小数据块场景,并合理设置尾部元素与掩码。这些细节共同影响向量资源的利用效率。
AES-CBC:利用独立数据块隐藏指令延迟
与 SHA-256 减少冗余配置不同,AES-CBC 解密优化的重点是隐藏指令延迟、充分利用硬件资源。原有 RISC-V 实现采用单块逐轮解密循环,相比其他架构的实现,未能充分释放硬件性能。团队对标其他架构,将其调整为多块解密循环。
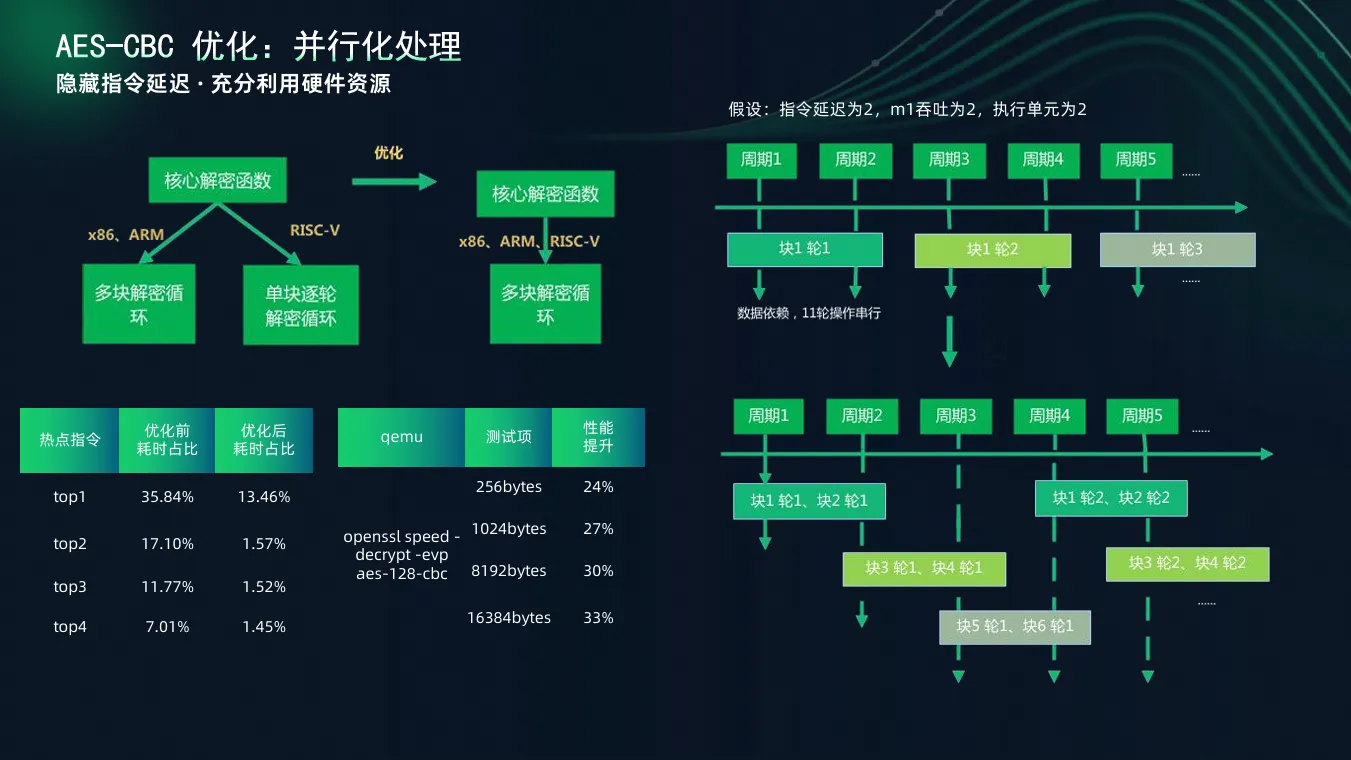
案例以特定硬件条件作为示意:指令延迟为 2,m1 吞吐为 2,向量执行单元为 2。图示实现中,每个数据块需要 11 轮解密操作。若串行处理,块一轮一消耗两个周期,后续轮次依次执行,不仅累积了较多周期,也未能充分利用两个执行单元。
优化后的调度利用独立块之间不存在依赖的特点交织发射。在图示中,周期一发射块一轮一和块二轮一,周期二发射第三块与第四块的首轮操作,使独立数据块像流水线一样并行推进。由此,团队在隐藏延迟的同时提高了执行单元利用率,并获得相应的性能改善。
Adler-32:分阶段优化累加、取模与归约
从密码算法的指令调度转向校验计算,Adler-32 案例展示了围绕同一算法逐步迭代的优化过程。相比 CRC,Adler-32 计算更简单,也更适合流式场景。其核心是两路相互依赖的累加:A 随输入数据持续累加并对 65521 取模,B 依赖 A 与自身进行累加,累加的结果对65521 进行取模,最终将A和B组合为32比特的校验结果。
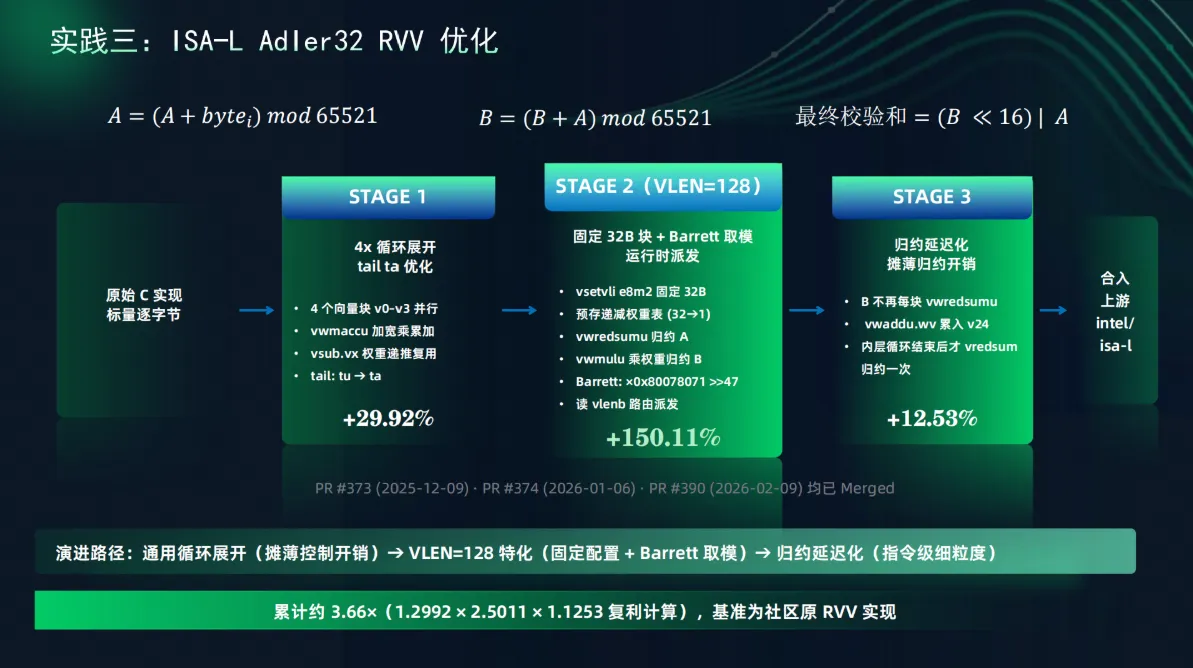
第一阶段从上游社区的 C 代码实现入手,针对标量逐字节处理采用四倍循环展开,增加并行处理空间。同时,团队将尾部策略由 tu 调整为ta。在该案例中,向量单元被充分使用、不存在尾部元素,因此可以采用ta策略。这一阶段综合优化后的性能提升约 30%;四倍循环展开描述的是处理方式,并不等同于四倍实测性能。
在此基础上,第二阶段面向特定向量长度进一步优化。团队在 VLEN=128 条件下采用 e8m2 配置,将处理块固定为 32 字节,并围绕归约过程控制溢出风险。流程中包含 A 的归约和 B 的权重归约,针对取模中的除法开销,团队引入 Barrett 取模,将除法转为乘法与移位,降低执行成本。该阶段整体性能提升约 150%。
第三阶段进一步减少横向归约频次。原有实现中,B 每处理一个数据块就需要归约一次;优化后,团队采用推迟归约,引入 v24 寄存器,并通过加宽乘指令持续累加,在内层循环结束后集中归约。在分享所述的计算过程中,173 次计算对应的归约次数由 173 次降为一次,从而减少归约开销。
三阶段优化叠加后,Adler-32 的整体性能约为原始实现的 3.66 倍,相关代码已合入上游社区。兰静也欢迎对性能优化感兴趣的开发者进一步交流,共同探讨算法实现与优化细节。
从单点优化走向生态共建
从 EC 纠删码、加解密到 Adler-32,这些案例体现了热点分析、向量化、访存优化和指令调度在不同算法中的应用,也说明基础软件优化需要持续迭代。团队在充分利用 RISC-V 指令集的同时,也发现了当前指令集的一些不足,中兴通讯及微电子团队正积极开展相关指令集工作。
当前的实践重点仍以单点优化为主,但进一步发展需要更广泛的生态协作。依托龙蜥社区,中兴通讯希望与专家和开发者共同推动主流基础软件原生支持 RISC-V 高性能特性,让优化成果通过上游贡献和发行版落地持续积累,为规模化商用筑牢底座。
面向未来,团队希望 RISC-V 基础软件性能逐步对齐主流架构,支撑服务器、云计算和 AI 等场景落地。从“能用”到“好用”,再到“爱用”,基础软件既是连接硬件与应用的关键层,也是 RISC-V 规模化商用的“最后一公里”。这一生态无法由单一企业独立完成,中兴通讯期待以合作共赢的方式,与更多开发者携手共建,让单点突破汇聚为持续的生态进步。
—— 完 ——