国产模型连续26周碾压美国调用量,企业AI基础设施该怎么重新选型

简介: OpenRouter最新周榜显示:国产模型调用量占全球近50%,DeepSeek V4.1-Flash单周达33.6万亿Token,环比激增801%。能力趋近头部、成本低一个数量级,正推动企业AI选型从“能力优先”转向“成本+可控+迭代”三位一体新范式。(239字)

OpenRouter 上周公布的周榜数据,值得企业技术负责人认真看一遍:10 月 19 日至 25 日,DeepSeek V4.1-Flash-1017 单周调用量 33.6 万亿 Token,环比增长 801%,全球前五名全部为中国模型,中国模型周调用量 93.54 万亿 Token,美国模型 22.47 万亿 Token,连续 26 周领先。
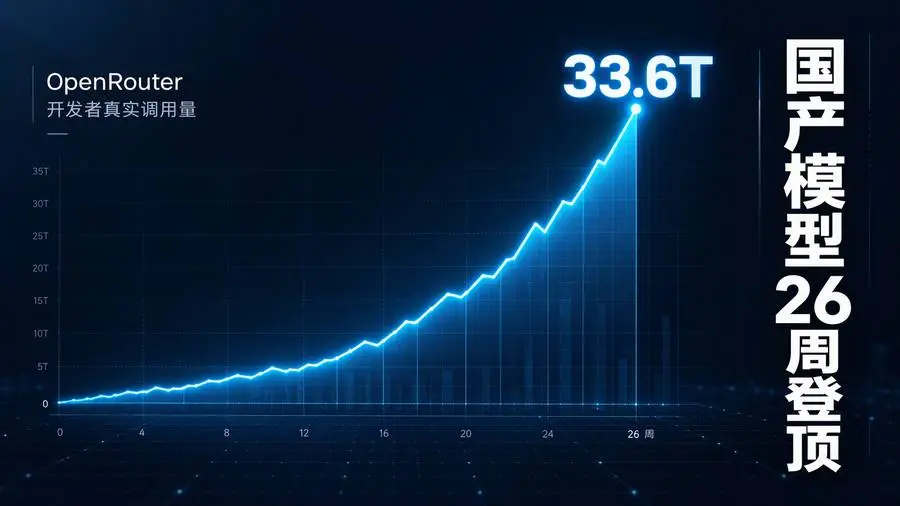
image.jpeg

但对企业来说,更有价值的其实是另一组数字:这一周全球总调用量 188 万亿 Token,国产模型占据了绝大部分份额,而对应的收入规模却远低于份额占比。换句话说,调用量在东方,收入在西方。

这个结构性差异,恰恰是企业在做 AI 基础设施选型时最该抓住的信号。

一、这轮变化和上一轮有什么不同

过去两年,企业选模型的主流逻辑是「能力优先」——先看榜单,再看能不能私有化,最后才谈价格。这个逻辑成立的前提是:模型能力差距足够大,值得为头部模型付溢价。

但现在这个前提在松动。

从公开数据看,国产模型在推理、编程、自动化等任务上的表现已经接近或达到第一梯队,而单位 Token 成本低了一个数量级。当能力差距收窄到 10% 以内,而成本差距还在 10 倍以上时,选型的天平自然会倾斜。

OpenRouter 的调用量数据就是这个倾斜的量化体现。而且要注意一个细节:DeepSeek 新版发布后,旧版 V4.1 Flash 的周调用量从环比下滑 45%,一周之内开发者完成了大规模迁移。这说明模型切换的摩擦,比很多人预想的要小。

二、企业该重新评估的三件事

1. 推理成本结构

很多企业的 AI 预算,是按「单次调用成本 × 预估调用量」做的。这个方法在模型价格稳定时没问题,但现在价格变动频繁,按年度做的预算很容易失真。

更稳妥的做法是建立成本可观测性:按业务功能维度拆分 Token 消耗,按周复盘。这样价格一变,你能立刻知道影响面有多大。

2. 多模型架构的必要性

以前多模型架构是「技术洁癖」,现在更像是「风险对冲」。

理由有三:一是价格波动,单一供应商调价会直接冲击成本;二是能力迭代,不同模型在不同任务上的相对优势变化很快;三是合规与可用性,多一条路径就多一层保障。

落地方式上,建议在应用层和模型层之间加一层统一网关,把路由、限流、计费、日志都收在这里。这样上层业务不感知底层换的是哪家模型。

3. 算力与调用的匹配

调用量暴涨会带来两个连锁反应:一是并发压力,二是成本失控风险。

建议在网关层做分级限流——核心业务保障,边缘功能降级或排队。这不是省钱技巧,而是稳定性设计。我见过不止一个团队,因为一个非核心功能被前端反复触发,把当月预算烧掉了四成。
image.jpeg

三、一个容易被忽略的环节:选型评估本身

说到这里,有个现实问题:企业做选型评估,往往要花很长时间。收集价格、跑测试、做对比表、内部评审,一套流程下来一两个月,等结论出来,市场又变了。

我最近的做法是把评估过程工具化。比如用 AiPy 把各家模型的公开价格、上下文长度、能力评测结果整理成一张可交互的对比表,参数一改结果实时刷新。这样在评审会上,有人问「如果我们的日请求量翻三倍呢」,可以当场演示,而不是回去再算两天。

工具本身不复杂,价值在于把选型从「一次性决策」变成「可持续跟踪的过程」。毕竟在现在这个迭代速度下,任何一次选型结论,保质期都不会太长。

四、给企业技术负责人的四条建议

  1. 把成本当成一等公民。 在架构设计阶段就预留成本观测能力,而不是等账单超了再补。
  2. 不要押注单一模型。 统一网关 + 多模型路由,是当前性价比最高的架构选择。
  3. 关注单位经济性,而非绝对价格。 便宜 10 倍但要多跑两次才能出结果的模型,未必更划算。要算「完成任务的总成本」。
  4. 保持对榜单的敏感,但别被榜单牵着走。 调用量反映的是群体选择,你的业务特征才是最终依据。

五、结语

26 周这个数字,本质上反映的是开发者市场的一次集体选择。对企业而言,重要的不是「谁第一」,而是这次选择背后的逻辑——当能力足够接近时,成本、可控性和迭代速度会成为决定性因素。

而这三件事,恰好都是可以通过工程手段优化的。这大概是这轮变化里,最值得技术团队关注的部分。

数据来源:OpenRouter 2026 年 10 月 19 日—25 日周榜公开数据。

相关文章
|
23天前
|
缓存 前端开发 API
对公结算场景下,银行卡联行号查询API实践与接入示例
在企业对公转账、商户提现、供应商资料录入等业务中,联行号(CNAPS)是一个高频必填字段。本文介绍基于卡号查询开户行联行号的接口能力、业务落地场景,并附上可直接运行的Python调用示例,帮助开发者快速集成到财务、结算类系统。
|
23天前
|
物联网 API 开发工具
第1章 鸿蒙演进全图景
本章专为初学者厘清鸿蒙生态迷思:梳理HarmonyOS演进时间线,辨析HarmonyOS、NEXT与OpenHarmony本质区别,揭示“纯血鸿蒙”移除AOSP的技术内涵,并构建ArkTS+ArkUI+Stage的全栈技术全景图——不写代码,只建认知地基。(239字)
|
23天前
|
人工智能 自然语言处理 JavaScript
Cypress + AI:自然语言生成端到端测试,脚本维护也能交给 AI 吗?
Cypress AI 正革新端到端测试:Studio 录制操作、Studio AI 智能推荐断言、cy.prompt() 将自然语言转为可执行脚本,支持自愈维护。但AI生成≠测试有效——需结合业务断言、接口验证与人工审核,方能落地企业级回归体系。
|
23天前
|
算法 程序员
并发和并行的区别(超级通俗,图解)
本文用通俗语言厘清并发与并行的本质区别:并发是单核CPU通过任务切换“轮流执行”,营造同时运行的假象;并行是多核CPU真正“同时执行”多个任务。图文结合,深入浅出,助你彻底掌握多线程编程核心概念。
103 0
|
23天前
|
监控 架构师 物联网
人员定位系统技术分享:非固定人员的动态授权模型
人员定位系统技术分享:非固定人员的动态授权模型——时效窗口、区域白名单与轨迹存证
128 0
|
23天前
|
人工智能 编解码 自然语言处理
2026阿里云双11大促|Qwen-image-3.0重磅升级:新版通义千问核心特性、技术架构与实战教程全解析
2026年阿里云双十一大促,不只是一场促销——它是你以最低成本拥抱Qwen-image-3.0图像生成能力、Qwen3.7-Max智能体基座、Qwen3.8-Max-Preview旗舰模型的黄金窗口。从4.5K Token超长提示词到万亿参数MoE架构,从10px小字渲染到35小时自主任务执行,阿里云百炼正在将"大模型能力民主化"从口号变为现实。 立即访问阿里云百炼大模型服务平台页面,领取你的7000万Tokens免费额度,开启AI生产力的全新篇章!
536 2
|
22天前
|
人工智能 前端开发 API
阿里Qwen3.8全面开源:2.4万亿参数旗舰降临,重新定义国产AI天花板
阿里Qwen3.8全面开源:2.4万亿参数旗舰模型Qwen3.8-Max正式发布,支持百万Token上下文与原生多模态;同步开源27B稠密版及高效Flash版。技术突破动态MoE、CoT++验证等,多项评测全球领先。开源权重已上线Hugging Face与魔搭。(239字)
638 1
|
25天前
|
缓存 前端开发 API
2026 阿里云双 11 重磅发布:通义千问 Qwen3.8-Max 全面解析——多模态、智能体与代码调用实战指南
Qwen3.8-Max的横空出世,标志着大模型从“辅助工具”向“自主执行者”的关键跨越。2.4万亿参数的MoE架构、百万级上下文、原生多模态、深度思考推理——这些不是冰冷的参数堆砌,而是通往复杂业务智能化的坚实基座。 但旗舰模型意味着旗舰成本。‌选对场景、用对方法、控好预算‌,才是让这把“利剑”发挥最大价值的关键。 无论你是独立开发者验证原型,还是企业团队落地生产业务,都建议第一时间前往 ‌阿里云百炼大模型服务平台页面‌,获取最新文档、实时计费、技术支持与社区资源,让每一个项目都事半功倍! 随着模型持续迭代,Qwen3.8-Max的工具调用稳定性、长周期任务规划能力还会持续优化,持续拓展
664 1
|
21天前
|
人工智能 API Apache
Qwen3.8抢先体验!大家要心理准备了,最新版发布并开源了?
2026年8月,阿里通义千问Qwen3.8系列全线开源,涵盖2.4万亿参数旗舰Max、27B轻量版、Flash高效模型及Flash-Next预览版。支持本地部署、多模态与长上下文,Apache 2.0(27B)与分层商用许可并行,标志国产大模型迈入“可下载、可部署、可商用”新阶段。(239字)
1092 0