
想获取最新实时文档、计费详情与技术支持?请立即前往 阿里云百炼大模型服务平台页面 获取第一手权威信息!
一、开篇:大模型从“辅助工具”迈向“自主执行者”
2026年的大模型江湖,早已不是简单问答的时代。当业务需求从“帮我写一段代码”跃升到“帮我从零交付一个完整项目”,当任务复杂度从单轮对话飙升至数千轮长周期智能体闭环——我们需要的,不再是一个“聪明的助手”,而是一位“能独立作战的数字员工”。
通义千问 Qwen3.8-Max,正是在这样的时代浪潮中横空出世的旗舰基座。总参数规模达到惊人的 2.4万亿,推理阶段却仅激活 950亿 参数——这不是冰冷的数字堆砌,而是“以小搏大”的算力哲学,是通往复杂业务智能化的坚实基座。
更多旗舰能力详情、技术白皮书与开发者文档,尽在 阿里云百炼大模型服务平台页面。
二、技术架构:2.4万亿参数的“轻量巨兽”
2.1 稀疏MoE混合专家架构
Qwen3.8-Max并非传统“堆参数、烧算力”的暴力美学,而是基于Qwen 3.5架构深度迭代,采用 第三代稀疏MoE混合专家架构 搭配自研 混合注意力机制。总参数2.4万亿,但内置路由控制器——收到用户输入后,路由模块根据语义动态挑选少量相关专家参与推理,其余专家安睡如初。
这种“按需调度、精准匹配”的设计,让模型拥有超大知识库与复杂推理能力的同时,推理开销远低于同等规模稠密大模型。相比同等规模稠密模型,推理效率提升约三成,生成速度提升约四分之一。
想深入了解架构设计细节与性能对比数据?阿里云百炼大模型服务平台页面 提供了完整的技术解读。
2.2 混合注意力机制:百万上下文的底层引擎
百万Token上下文窗口是Qwen3.8-Max的核心王牌——最高支持 100万Token(最大输入991,808 Token,最大输出131,072 Token),开启思考模式后仍保持接近百万级输入上限,最大思维链长度支持 262,144 Token。
支撑这一切的,是自研混合注意力机制:对大量重复、背景类文本使用 线性注意力 快速处理;对关键信息、核心段落则切换至 高精度稀疏注意力,精准捕捉远距离Token间的关联。百万Token输入场景下,不会产生传统全注意力模型那样的平方级算力爆炸,大幅降低预填充耗时,同时保障远距离信息召回精度,彻底告别“长篇文档后半段遗忘”的痼疾。
完整架构五层拆解——多模态编码层、词嵌入层、MoE混合专家主干网络层、混合注意力模块、输出预测头——每一层的技术细节均可在 阿里云百炼大模型服务平台页面 查阅。
2.3 双推理模式自由切换
Qwen3.8-Max延续了Qwen系列标志性的双推理机制:
- 深度思考模式(reasoning_effort=xhigh,默认开启):逐层拆解复杂问题,模拟人类思维推演,适配复杂工程与深度逻辑推理;
- 极速快速模式(reasoning_effort=low):精简推理链路,响应速度提升50%,Token消耗降低30%,同等额度可翻2-3倍。
可选档位涵盖 none/minimal/low/medium/high/xhigh,业务可做动态路由——简单任务切low,复杂任务切xhigh,实现效果与成本的精准平衡。参数配置全说明,见 阿里云百炼大模型服务平台页面。
三、核心能力:五大支柱撑起全场景智能体基座
3.1 百万Token超长上下文——无分段的信息洪流
一次性加载完整长篇合同、百页法律卷宗、整本行业白皮书、百万行代码仓库、数十小时长视频字幕——统统可一次载入,约75万字文本,无需切片拆分,规避信息丢失与上下文割裂。
与普通长文本模型只做摘要提取不同,Qwen3.8-Max支持 跨章节细节检索、逻辑关联、对比分析,在完整上下文支撑下,长文档事实性错误率降低 60%。同时支持 Partial Mode前缀补全,接续给定文本继续生成,适合代码补全、文档续写。
特别提醒:开源底座版本原生上下文上限为262K Token,百万上下文能力仅开放在云端API调用模式,本地部署无法直接获取完整能力。最佳实践与限制说明,详见 阿里云百炼大模型服务平台页面。
3.2 原生多模态理解——从“看懂”到“看透”
Qwen3.8-Max是原生多模态基座模型,无需依赖外部插件,同时处理 文本、图像、视频、PDF/Word/Excel:
| 能力维度 | 具体表现 |
|---|---|
| 图像理解 | 精准解析截图、工程图纸、报表图表、手写文档、UI界面;根据UI截图直接还原完整前端页面代码 |
| 视频处理 | 读取长视频时序信息,理解画面变化、人物对话、事件发展脉络,支持 100小时以上长视频处理 |
| 文档解析 | 直接读取PDF、Word、Excel,提取文本、表格、图片信息,实现合同审阅、报表分析 |
在 Vision Arena多模态评测榜单 中,Qwen3.8-Max取得 第二名,视觉综合理解能力位居全球上游;无工具条件下视觉推理能力达 82.0分。
更多多模态能力演示与限制说明,尽在 阿里云百炼大模型服务平台页面。
3.3 自主编程与长周期软件工程——从“写代码”到“交付项目”
这是Qwen3.8-Max最令人震撼的能力跃迁。它不再局限于生成几十行代码片段,而是具备 从零搭建完整工程、自主闭环开发 的能力。
官方实测案例:仅给出需求指令,模型从零开始自主运行约 16天,累计产生 265次代码提交、127个合并请求和151个议题,最终交付了真实可用的自进化智能体框架“oh-my-cli”,相关代码已开源至GitHub。在 Frontend Code Arena前端代码榜单 排名第四,编程完整性较前代提升 40%。在 PaperBench科研复现评测 中得分 93.0,超越Anthropic Fable5(88.8分),编程智能体能力位居全球前列。
核心能力覆盖:
- 从零生成完整多文件项目(前端+后端+数据库)
- 百万行仓库级代码理解重构
- 报错日志自动定位修复、单元测试编写
- 跨模块工程调试与架构方案设计
- 内置Code Interpreter代码执行引擎,支持Python、Java、C++、JavaScript等主流语言
编程能力实战指南与代码示例,请前往 阿里云百炼大模型服务平台页面。
3.4 长周期智能体与Function Calling——自主执行的“数字员工”
Qwen3.8-Max原生支持Function Calling函数调用,能够自主识别任务目标、选择外部工具、解析工具返回结果、迭代调整执行策略,支持 数千轮持续交互,形成任务闭环。
典型场景:用户提出“读取项目日志文件,统计报错频次,生成分析报告”——模型先调用文件读取工具获取日志,接着调用统计工具统计错误数据,最后整合数据输出完整分析文档,整套流程自主完成。
可对接代码解释器、网页提取、数据库查询、本地脚本等各类外部能力,适配 LangChain、AutoGPT、OpenClaw、Hermes Agent 等主流Agent框架。
智能体编排全攻略,详见 阿里云百炼大模型服务平台页面。
3.5 结构化输出、上下文缓存、前缀续写
- 结构化输出:强制返回标准JSON格式,大幅降低业务侧解析失败概率;
- 上下文缓存:针对重复前缀内容做缓存,减少重复Token计算,在知识库问答、批量文档审核场景降低延迟与计费开销;
- 前缀续写:从指定文本位置继续生成,适合代码补全、文档续写。
四、落地实操:两种接入方式与完整代码
开发者接入Qwen3.8-Max主要分为两种路径:
路径一:百炼平台云端API调用(推荐快速上手)
无需准备高性能显卡,开箱即用,适合快速原型开发与线上业务落地。
第一步:登录百炼控制台,创建API密钥,保存 DASHSCOPE_API_KEY,妥善保管,禁止硬编码写入代码仓库。模型调用标识:qwen3.8-max。
第二步:配置环境变量
export DASHSCOPE_API_KEY="sk-xxxxxxxxxxxxxxxxxxxxxxxxxxxx"
第三步:Python SDK 完整示例
import os
import dashscope

# 设置API_KEY,建议配置环境变量
dashscope.api_key = os.getenv("DASHSCOPE_API_KEY")

def qwen38max_text_chat(user_prompt: str, system_prompt: str = "你是专业技术助手,输出严谨准确"):
messages = [
{
   "role": "system", "content": system_prompt},
{
   "role": "user", "content": user_prompt}
]
response = dashscope.Generation.call(
model="qwen3.8-max",
messages=messages,
result_format="message",
max_tokens=2048,
temperature=0.3,
top_p=0.85,
stream=False,
extra_body={
   "reasoning_effort": "xhigh"}
)
if response.status_code == 200:
return response.output.choices.message.content, response.usage
else:
return f"调用失败: {response.code} {response.message}", None

if __name__ == "__main__":
res, usage_info = qwen38max_text_chat("请写一个Python脚本,实现读取本地csv文件,完成数据统计并输出基础分析报告")
print("模型返回结果:\n", res)
print("\nToken消耗统计:", usage_info)
curl命令行调用:
curl https://dashscope.aliyuncs.com/api/v1/services/aigc/text-generation/generation \
-H "Authorization: Bearer $DASHSCOPE_API_KEY" \
-H "Content-Type: application/json" \
-d '{
"model": "qwen3.8-max",
"input": {
"messages": [{"role": "user", "content": "你好"}]
}
}'
路径二:私有化本地部署(高安全场景)
适合数据不允许出网、高数据安全要求的企业,需要多卡GPU硬件支撑。MoE架构支持 张量并行,将专家网络拆分到多张GPU卡,合理分配显存开销。
注意:开源底座版本原生上下文上限为262K Token,百万上下文能力仅开放在云端API调用模式。私有化部署完整指南,请参阅 阿里云百炼大模型服务平台页面。
五、计费规则:选对场景、用对方法、控好预算
Qwen3.8-Max是旗舰模型,意味着旗舰成本。百炼平台计费模式丰富,覆盖不同场景:
| 计费方式 | 适用场景 | 说明 |
|---|---|---|
| 按量付费 | 正式业务 | 输入/输出Token分别计价,单位元/千Token;部分模型阶梯计费 |
| 新人免费额度 | 测试体验 | 新用户开通即享超 7000万tokens,90天超长有效期 |
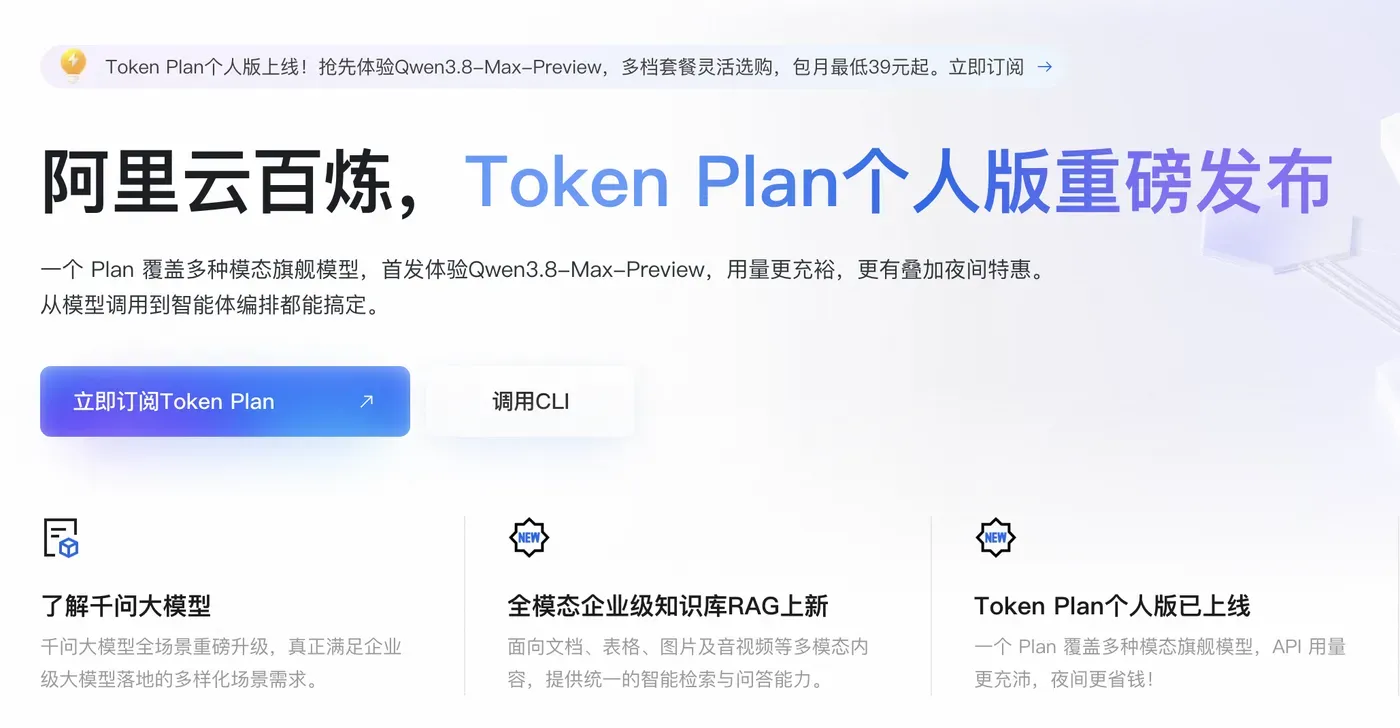
| Token Plan订阅 | 个人/团队 | 个人版Lite 39元/月、Standard 139元/月、Pro更高;团队版座席订阅 |
| Coding Plan套餐 | AI编程工具 | 新客首月每天仅需0.3元 |
| Night Plan夜间折扣 | 离线批量任务 | 北京时间22:00-次日08:00享受折扣优惠 |
计费公式:调用费用 =(输入Token数×输入单价 + 输出Token数×输出单价)÷ 1000。支持上下文缓存命中优惠单价。
完整计费规则与实时价格,以 阿里云百炼大模型服务平台页面 最新公示为准。
六、业务场景选型与开发避坑指南
推荐场景
- 复杂长文档精读(合同、论文、白皮书)
- 多步骤科研与金融量化任务
- 大型代码库重构与自主开发
- 多模态专业资料分析(报表、图纸、视频)
- 长周期智能体与工作流编排
开发避坑要点
- 密钥安全:API Key禁止硬编码,通过环境变量或后端服务下发管理;
- 上下文缓存配置:反复针对同一长文档提问时,启用缓存可显著降低Token消耗与响应耗时;
- 提示词调优:复杂任务建议开启深度思考模式(xhigh),轻量任务切low模式;
- 人工复核:高风险业务(法律、金融、医疗)务必增加人工校验机制;
- 模型选型区分:不是所有任务都需要Qwen3.8-Max,简单问答可用更轻量模型节约成本。
更多场景选型策略与调优最佳实践,详见 阿里云百炼大模型服务平台页面。
七、结语:让每一次调用都物有所值
Qwen3.8-Max的横空出世,标志着大模型从“辅助工具”向“自主执行者”的关键跨越。2.4万亿参数的MoE架构、百万级上下文、原生多模态、深度思考推理——这些不是冰冷的参数堆砌,而是通往复杂业务智能化的坚实基座。
但旗舰模型意味着旗舰成本。选对场景、用对方法、控好预算,才是让这把“利剑”发挥最大价值的关键。
无论你是独立开发者验证原型,还是企业团队落地生产业务,都建议第一时间前往 阿里云百炼大模型服务平台页面,获取最新文档、实时计费、技术支持与社区资源,让每一个项目都事半功倍!
随着模型持续迭代,Qwen3.8-Max的工具调用稳定性、长周期任务规划能力还会持续优化,持续拓展AI在专业领域的落地边界。而你,只需要一个入口——阿里云百炼大模型服务平台页面——即可开启这场智能革命。
