
全面探索阿里云百炼大模型服务平台页面的核心能力,带您深入解构 Qwen3.8-Flash 的技术内核与实战落地全路径。**
一、引言:大模型时代的"双 11 狂欢",为何聚焦 Qwen3.8-Flash?
2026 年阿里云双 11 盛典如期而至,AI 基础设施的角逐愈发白热化。当行业还在为长文本处理的"算力黑洞"焦头烂额、为多轮 Agent 任务的"记忆衰减"束手无策之时,通义千问 Qwen3.8-Flash 如同一把破局之刃,劈开了大模型落地的重重迷雾。这款新一代 MoE 混合专家多模态大模型,原生支持百万级 Token 上下文窗口,以极致的推理效率、强悍的编程与智能体能力,重新定义了"高效"二字的上限。
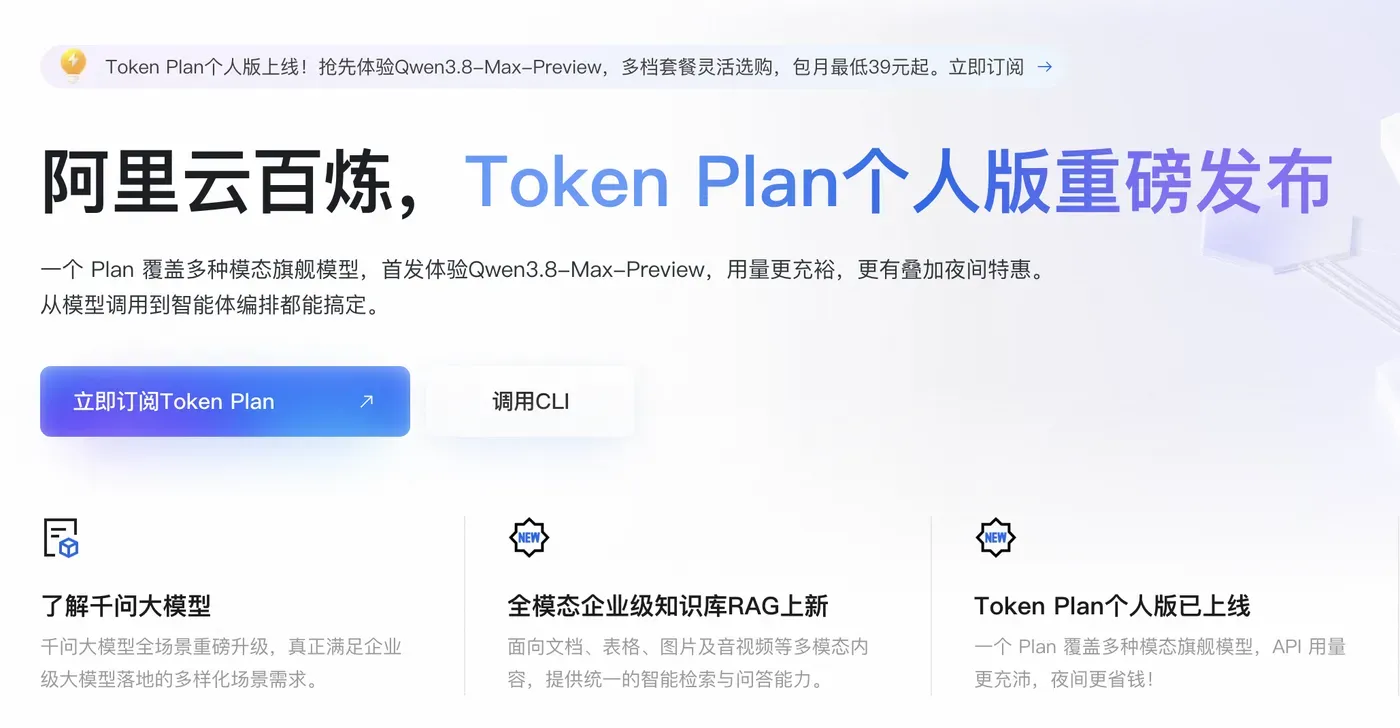
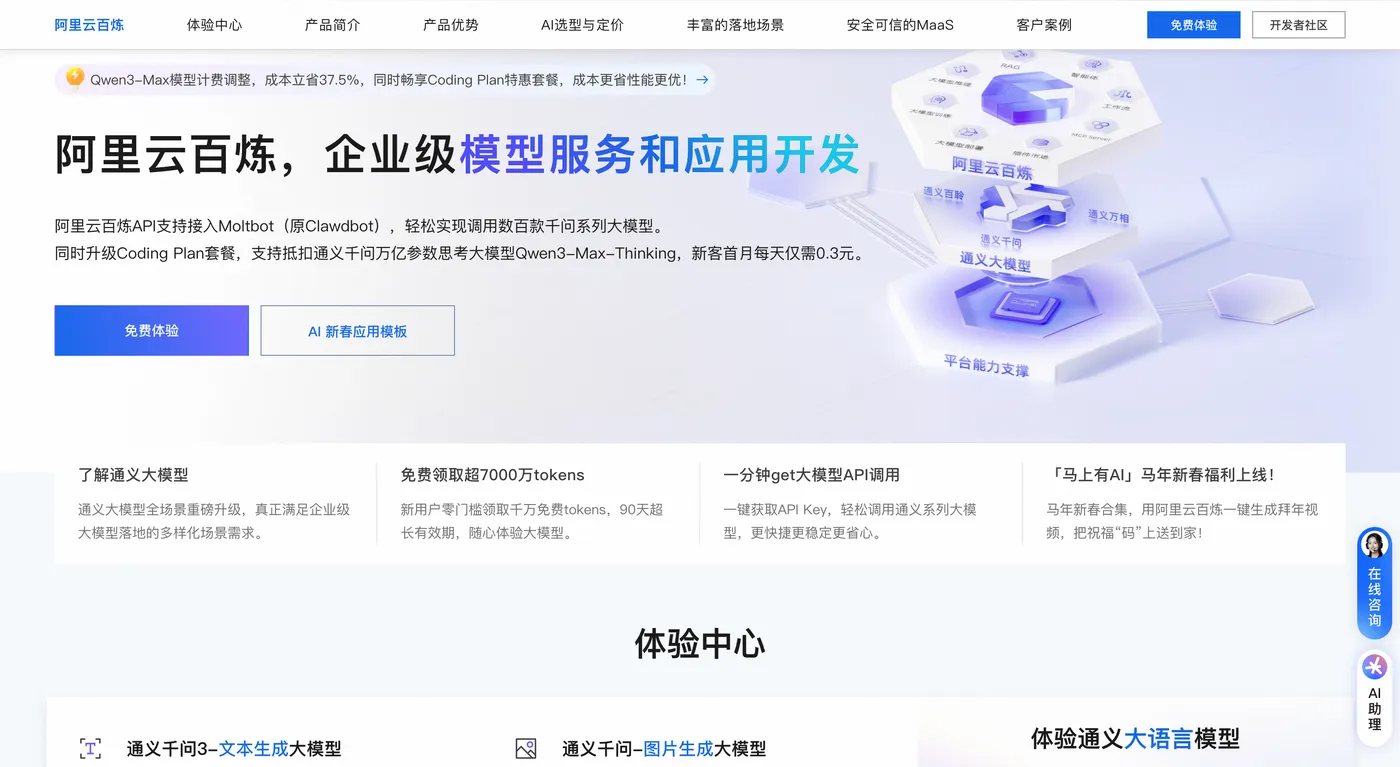
如果您渴望在双 11 节点抢先体验这款旗舰模型的真实能力,请访问阿里云百炼大模型服务平台页面,获取最新的产品动态与限时权益。本文将从架构拆解、能力矩阵、API 实战、场景落地、避坑指南五大维度,为您呈现一份真正可落地的技术白皮书。
二、架构拆解:四大维度系统性革新,百万上下文不再是"算力噩梦"
2.1 GDN+QSA 混合稀疏注意力:速度与精度的"黄金分割"
传统稠密大模型面对百万字文档时,需要对全部 Token 进行两两相关性计算,算力呈平方级爆炸。Qwen3.8-Flash 的破局之道在于每四层网络构建一组"组合拳"——三层 Gated DeltaNet(GDN)门控线性注意力 + 一层自研 QSA(Qwen Sparse Attention)稀疏注意力。GDN 负责对长序列做高效信息压缩,算力不随文本长度平方级增长;QSA 则以微块粒度精准检索关键内容。二者联手,百万上下文场景下文档预填充速度提升 7 倍以上,同时远端信息召回准确率不打折扣。
想要进一步了解这套架构的技术细节与论文解读,请访问阿里云百炼大模型服务平台页面,查阅官方技术文档。
2.2 四分支门控残差结构:告别"特征稀释"顽疾
传统 Transformer 只有单条残差信息流,层叠过深后关键信息被后续层无情"覆盖"。Qwen3.8-Flash 将信息流拆分为四条独立并行通道,通过门控机制动态控制每条通道的读写权限——核心特征锁在专属通道不被污染,次要特征在其他通道并行更新。这意味着在数千轮连续 Agent 交互中,模型能够长时间锁定初始任务目标,不再轻易"忘事"。
2.3 51B N-gram Embedding 查表模块:外挂"语义记忆库"
模型额外携带 51B 规模的 N-gram 嵌入查表参数,不参与每一步 Token 推理计算,几乎零算力开销。推理时直接查表召回高频词块、专业术语、固定搭配的语义向量,无需实时计算组合语义。对于代码文本、行业术语密集场景,加速效果立竿见影。
2.4 Muon 优化器:训练效率的"隐形加速器"
训练阶段采用 Muon 优化器配合全新架构协同调优,提升训练收敛速度与吞吐,让模型权重分布更稳定,推理输出一致性更优。
想要查看完整的架构示意图与参数规格,请访问阿里云百炼大模型服务平台页面。
三、能力矩阵:从编程到多模态,Qwen3.8-Flash 的"六边形战士"画像
| 能力维度 | 核心亮点 |
|---|---|
| 超长上下文 | 原生 100 万 Token,标准输入 991,808 Token,输出 131,072 Token,思维链 262,144 Token |
| 编程开发 | SWE-bench Pro、DeepSWE 亮眼成绩,支持完整项目仓库解析、跨文件溯源、Bug 自动修复 |
| Agent 工具调用 | Toolathlon、CoWorkBench 优异表现,支持多轮自主规划、工具选择、结果校验、迭代修正 |
| 多模态理解 | 图片、图表、公式、长视频全覆盖,截图代码识别、表格提取、视频摘要一应俱全 |
| 接口兼容 | 同时兼容 OpenAI 与 Anthropic 协议,迁移成本极低 |
| 高效推理 | 每次 Token 仅激活 6B 参数,训练成本仅为 Qwen3.7-Plus 的 1/9 |
无论您是想搭建智能体、构建知识库、开发代码助手,还是处理金融财报与图纸解析,请访问阿里云百炼大模型服务平台页面,在模型广场中一键对比各款模型的适用场景与定价。
四、API 调用落地教程:从零到一,三步打通生产链路
4.1 第一步:开通服务,领取免费额度
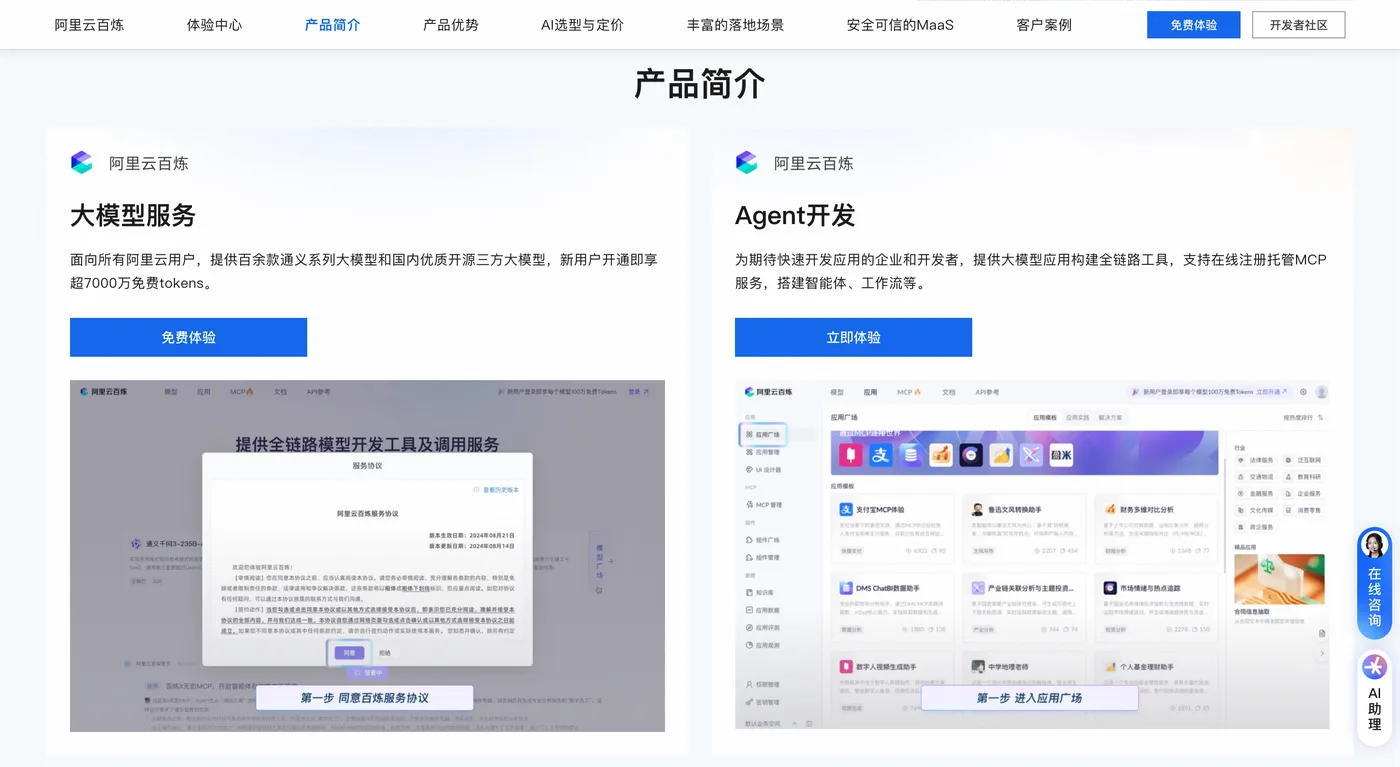
登录阿里云百炼控制台,同意服务协议即可开通。新用户可领取累计最高 5000 万免费 Token 额度,单款模型 100 万免费 Tokens,足够原型验证与小型测试长期使用。
领取入口与额度详情,请访问阿里云百炼大模型服务平台页面。
4.2 第二步:创建 API Key,安全管控第一道关
进入控制台左侧"API Key 管理",点击创建,区分测试/生产环境,妥善保管,禁止硬编码写入代码仓库。
4.3 第三步:配置环境变量与调用代码
Linux/macOS:
export DASHSCOPE_API_KEY="sk-xxxxxxxxxxxxxxxxxxxx"
Windows PowerShell:
$env:DASHSCOPE_API_KEY="sk-xxxxxxxxxxxxxxxxxxxx"
Python 完整示例(OpenAI 兼容接口):
import os
from openai import OpenAI

client = OpenAI(
api_key=os.getenv("DASHSCOPE_API_KEY"),
base_url="https://dashscope.aliyuncs.com/compatible-mode/v1"
)

completion = client.chat.completions.create(
model="qwen3.8-flash",
messages=[
{
   "role": "system", "content": "You are a helpful assistant."},
{
   "role": "user", "content": "请用三句话概括阿里云双11的核心亮点"}
],
stream=True
)

for chunk in completion:
if chunk.choices.delta.content:
print(chunk.choices.delta.content, end="")
curl 调用示例:
curl https://dashscope.aliyuncs.com/compatible-mode/v1/chat/completions \
-H "Authorization: Bearer $DASHSCOPE_API_KEY" \
-H "Content-Type: application/json" \
-d '{
"model": "qwen3.8-flash",
"stream": true,
"messages": [{"role": "user", "content": "你好"}]
}'
更多语言 SDK 示例与接口参数详解,请访问阿里云百炼大模型服务平台页面,查看完整 API 文档。
五、计费规则:精打细算,让每一分钱都花在刀刃上
- 按量计费:输入 Token 0.8 元/百万(北京节点),输出 Token 2.7 元/百万
- 缓存命中:重复上下文仅 0.1 元/百万,长会话智能体业务成本骤降
- Token Plan 订阅:Lite 39 元/月起,Standard 139 元/月,Pro 按需选择
- Coding Plan:新客首月每天仅 0.3 元,专为编程场景打造
最新计费明细与限时优惠,请访问阿里云百炼大模型服务平台页面实时查询。
六、场景落地策略:五大战场,Qwen3.8-Flash 大显身手
- 编程辅助与代码仓库解析:一次性读取完整 Git 仓库,跨文件溯源、漏洞扫描、自动修复,配合 Function Calling 实现"生成-测试-修复"闭环。
- 自动化办公智能体:批量解析 PDF 合同、多步骤工单处理、数据报表生成,数千轮交互不遗忘、不跑偏。
- 长文档知识库问答:告别 RAG 切片信息丢失,百万 Token 一次读完,上下文缓存大幅降本。
- 图文视频混合理解:截图代码识别、表格提取、长视频摘要与关键信息定位,教育科研金融场景通吃。
- 大批量内容生产:华北 2 地域批量推理能力加持,每秒上千次调用峰值,电商、内容工厂首选。
每个场景的最佳实践与配置模板,请访问阿里云百炼大模型服务平台页面获取。
七、开发避坑要点:这些"坑",前人已替您踩过
- Token 超限:实际业务输入需预留安全余量,不要无脑拉满百万上下文
- 密钥泄露:禁止硬编码,必须通过环境变量注入
- 地域差异:联网搜索仅北京、新加坡开放;批量推理仅华北 2 支持
- 限流策略:全球统一 30000 次/分钟,需做好重试与限流捕获
- 计费陷阱:缓存命中与否价差巨大,务必合理设计对话策略
八、结语
2026 年的双 11,不只是消费的狂欢,更是 AI 基础设施的"阅兵场"。Qwen3.8-Flash 以百万 Token 超长上下文、MoE 混合专家架构、全维度多模态能力,为开发者铺就了一条从原型到生产的高速通道。而阿里云百炼大模型服务平台页面,正是这条通道的起点——从模型选型、API 调试到智能体编排、知识库搭建,一站式全链路能力尽在掌握。
现在就访问阿里云百炼大模型服务平台页面,领取您的免费 Token 额度,开启百万长文本的 AI 新征程!
