
一条最后消息停在 09:00 的会话,用户在 10:00 将它置顶。如果实现为了“让它排到前面”,直接把最后消息时间改成 10:00,列表虽然上移了,时间含义却变了;取消置顶后,还可能继续占着本不属于它的位置。
以米米商聊为背景,已整理的手机端资料包含聊天置顶功能。本文借此讨论独立的会话列表排序示例,不代表产品采用下文的字段、置顶顺序或时间来源,也不推断其原生 App、桌面客户端及服务端实现。
1. 置顶状态和最后消息时间,记录的是不同事实
最后消息时间回答“这条会话最近的消息是什么时候”;置顶信息回答“用户是否希望优先看到它”。前者来自消息活动,后者来自用户的列表偏好,不能为了实现同一个排序结果而混写。
在这个教学模型里,置顶状态属于当前用户的会话视图,不是对消息本身的修改。取消置顶只移除偏好,不创建新消息,也不改写已保存的最后消息时间。
| 示例字段 | 本文约定 | 不承担的含义 |
|---|---|---|
id |
会话的唯一字符串标识 | 显示名称或数组下标 |
pinnedAt |
置顶顺序依据;null 表示未置顶 | 最后消息时间 |
lastMessageAt |
最后消息的时间;null 表示本例没有该时间 | 最近一次设置操作的时间 |
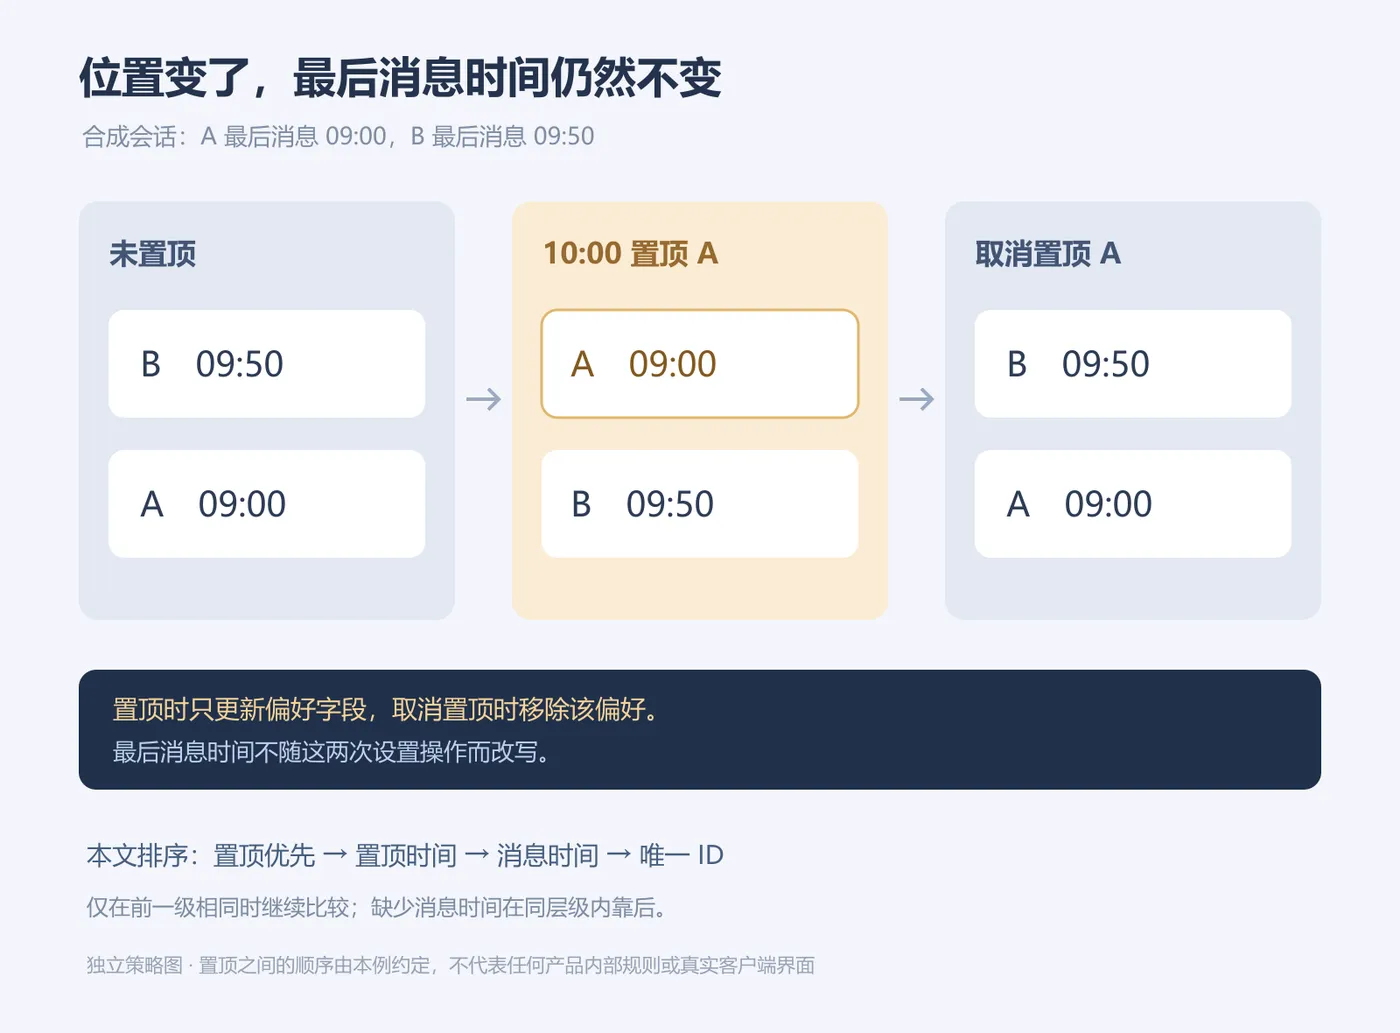
例如 A 的最后消息是 09:00,B 的最后消息是 09:50。A 被置顶后可以排在 B 前面,但 A 仍展示 09:00;取消 A 的置顶后,B 再依照消息时间排在前面。这个过程无需伪造一条 10:00 的消息活动。
2. 先约定每一级排序,再写比较器
本文选择以下规则:已置顶的会话在前;两条都已置顶时,较晚的置顶时间在前;此前条件相同,再按最后消息时间从新到旧;仍相同,按唯一 ID 的原始字符串顺序收尾。缺少最后消息时间的条目,在同一优先层级内排在有时间的后面。
这只是一种可解释的教学策略。“置顶之间按新消息重排”“保持用户手动顺序”等,也可以是其他产品策略,不能从存在置顶功能就推断出来。在本文规则中,新消息不会越过更高优先级的置顶时间。
示例的输入前提也要写明:每一行都有唯一字符串 ID;两个时间字段均为已经校验的安全整数毫秒值或 null;字段不能缺失,也不接受 NaN、Infinity 或日期字符串。代码聚焦排序,不替代接口入口的完整校验。
function compareTimeDesc(a, b) {

  if (a === b) return 0;
  if (a === null) return 1;
  if (b === null) return -1;
  return a > b ? -1 : 1;
}

function compareConversations(a, b) {

  const aPinned = a.pinnedAt !== null;
  const bPinned = b.pinnedAt !== null;
  if (aPinned !== bPinned) return aPinned ? -1 : 1;

  if (aPinned) {

    const byPin = compareTimeDesc(a.pinnedAt, b.pinnedAt);
    if (byPin !== 0) return byPin;
  }
  const byMessage = compareTimeDesc(a.lastMessageAt, b.lastMessageAt);
  if (byMessage !== 0) return byMessage;
  if (a.id === b.id) return 0;
  return a.id < b.id ? -1 : 1;
}
这里使用 pinnedAt !== null 判断置顶,而不是用真值判断时间。数值 0 在本例中是合法毫秒值,不能被误判为未置顶。缺失值则应在进入比较器之前被识别为输入错误。
末级比较使用字符串 < 的顺序,为同一组有效条目提供明确的平局规则;它不是按昵称、拼音或自然语言排序,也不表示较小的 ID 一定更早创建。
3. 稳定排序不等于替你定义了平局规则
比较器返回 0,意味着当前规则认为两条记录相等。在稳定排序中,它们保留各自在输入数组中的相对顺序。但如果两次接口返回的输入顺序不同,保留输入顺序并不能保证两次渲染的顺序一致。
MDN 的 sort 文档说明了稳定排序的含义。本文额外加入 ID 收尾,是为了在前面字段相同、ID 唯一的前提下,不再依赖偶然的输入顺序。
另一个常见错误是比较器只返回 true 或 false。排序需要区分前、后、相等;交换两条记录后,结果也应彼此一致。不要在比较器中临时修改置顶时间,或每比较一次就读取变化中的当前时间。本文比较器只读取传入行的数据。
4. 返回新的顺序,更新独立的置顶字段
sort()会原地修改数组。若这个数组同时被缓存或其他视图使用,直接排序就可能让其他持有者观察到顺序变化。下面先复制数组,再排序;置顶更新则返回一条新的行对象。
function orderConversations(rows) {

  return [...rows].sort(compareConversations);
}

function changePinnedAt(row, pinnedAt) {

  return {
    ...row, pinnedAt };
}
对 A 调用 changePinnedAt(A, pinTime),只得到本地模型中的新行;传入 null 表示取消置顶。它保留 lastMessageAt,但不发起请求、不提供成功回执,也不解决多端并发修改。实际应用仍需把请求状态、失败回退和服务端结果接到对应流程里。
数组复制是浅复制,排序结果里的行对象仍然与原数组共享身份;对象展开也不会深复制嵌套数据,参见 展开语法说明。这里能保证的是排序函数没有主动重排输入数组或改写行字段,不能把它宣传成整个数据结构都已经隔离。
时间来源也需要独立约定。用于跨设备一致排序的置顶信息,应由真实协议提供一致的比较依据,不能只靠各台设备随意填入本地时钟,就承诺多端顺序一致。本文只处理已经取得的一份有效快照。
5. 用取消置顶和平局场景检查语义
只测试“一条置顶能不能上移”是不够的。更有价值的检查,是确认它上移后原来的消息事实仍然保留,以及取消置顶后重新进入普通排序。
| 检查场景 | 本文预期 |
|---|---|
| 较旧消息的 A 置顶,较新消息的 B 未置顶 | A 在前,A 的消息时间不变 |
| A 取消置顶 | 再按消息时间比较,B 在前 |
| 两条都置顶 | 先比较置顶时间,不先比较消息时间 |
| 置顶时间相同 | 再比较最后消息时间 |
| 所有时间相同 | ID 提供明确顺序 |
| 置顶时间为 0 | 仍作为已置顶处理 |
| 同层级缺少消息时间 | 放在有消息时间的后面 |
| 重复排序同一快照 | 顺序一致,输入数组和字段不变 |
独立验证从本文两段 JavaScript 原样提取函数,用本地 Node.js 和合成会话运行;除具体顺序外,也检查比较器对自身返回 0、交换参数时符号相反,以及三条记录比较时的传递性。对于相同快照的不同输入排列,检查最终顺序一致。
这些检查覆盖教学模型的排序与本地更新语义,没有调用真实置顶接口、读取用户会话或验证产品的多端同步策略。测试通过的范围不能扩大成“已经解决所有会话列表跳动”。
如果真实列表仍出现异常,应继续确认是否存在重复 ID、缺失字段、秒与毫秒混用、过期快照覆盖或组件键错误。排序规则只负责其中一层,不能替代其余数据路径的核对。
6. 用排序规则表达优先级,保留消息事实
置顶带来的位置变化,应能从明确的偏好字段和比较规则中解释。最后消息时间继续描述消息,置顶信息描述用户偏好,ID 处理前面条件都相同的情况。
把这些责任分开后,置顶、取消置顶以及刷新列表都更容易验证。出现问题时,也能判断是某个字段变了、比较规则变了,还是输入数据不再满足契约,而不必围绕一个被反复改写的“万能更新时间”猜测。
本文为独立教学示例,部分内容由 AI 辅助整理,代码与发布内容经独立核对。
