企业报表必备:jquick-pdf 表格分页、内容自适应方案
引入
长表格是报表导出绕不开的场景:明细动辄几十上百行,可能跨越多页,还夹带长短不一的中文说明。用 iText 或 PDFBox 直接绘制时,开发者要自己计算每行高度、判断页面剩余空间、决定在哪里换页,逻辑复杂且容易在“行被拦腰截断”上翻车。jquick-pdf 由布局引擎负责基础分页,模板只表达“有哪些行、每行有哪些单元格”,把排版计算从业务代码里剥离出来。本文围绕三个问题展开:长表格如何自然分页、单元格内的长文本如何换行并带动行高自适应、表格宽度与页宽如何匹配,同时说明“重复表头”等尚未证实的能力,并给出覆盖 80 行长文本的分页验证方法。
环境基线为 jquick-pdfx:4.1.0 与 JDK 8+,依赖配置见本系列入门篇。
核心讲解
布局引擎负责基础分页
表格渲染器内部存在文本换行逻辑,<tr> 可以设置高度,块元素还可用 keepTogether 等布局属性。也就是说,模板层面不需要手工指定“在第几行分页”:当表格内容超过当前页面剩余空间时,渲染器会把后续内容放到下一页继续绘制。模板的职责因此回归为结构描述——把数据变成合法的 <tr>,其余交给引擎。需要提醒的是,keepTogether 属于版式优化手段,把它理解成“绝对禁止分页”并不成立,在内容本身超过一页时仍可能被拆开,因此关键信息不要只依赖单一属性保护。
长表格的自然分页行为
当行数增加,表格会自然跨页。分页点由页面可用高度、行高与当前已绘制内容共同决定,而不是由固定行数决定。这意味着同一份数据在不同页面尺寸、不同字体度量下,分页位置会变化。验收时应关注“内容是否完整、顺序是否正确”,而不是“是否在第 N 行换页”。如果业务确实需要可控的换页,可使用已验证的 <areaBreak> 或 <htmlPageBreak> 在指定位置显式换页,但这种做法要求后端事先知道内容高度,通常只用于结构固定的报告。
单元格内长文本换行与行高自适应
当单元格可用宽度不足以容纳一整段文本时,文本会在单元格内自动换行,行高随之增加,后续行整体下移。这正是“行高自适应”的含义:行高不是一个写死的值,而是内容换行行数与字号的综合结果。因此不要把整页高度写死,也不要为了追求整齐而给每行固定一个很小的 height,否则长说明会与相邻内容挤在一起。正确的做法是让说明列获得足够宽度,把序号、状态这类短字段列设窄,从结构上减少换行行数。
表格宽度与页宽的关系
表格宽度由 <table> 的 width 决定,单位支持 px、pt、mm、cm、in,其中 px 按 96 DPI 换算,1px 等于 0.75pt。若表格宽度接近甚至超过页面可用宽度(页面宽度减去左右边距),内容会被挤压或产生非预期布局,因此设置宽度前要按目标页面尺寸与 margins(top,right,bottom,left) 估算可用空间。多列表格要额外留出内边距的空间,避免最右列贴边。
重复表头属未证实能力
“每一页自动重复表头”(thead 重复输出)不能在模板里生效。可行替代方案是:在业务层按预估的每页行数把数据切段,每段生成一个独立的 <table> 并显式写出表头行,再顺序放入同一个模板。这样虽然分页点由预估决定,可能与引擎实际分页不完全一致,但表头至少在每个表格块开头出现,跨页阅读时的定位成本明显降低。
用绑定传入预生成的表格体
当表格体已由上层拼装完成时,可以把它作为字符串变量绑定进模板,模板只保留骨架,模板侧用 ${name} 取值:
JQuickPdfFactory factory = JQuickPdfFactory.create(); // 与 new JQuickPdfFactory() 等价
factory.bind("tableBody", rows.toString()); // 绑定预生成的 <tr> 序列
byte[] pdf = factory.executeContent("<pdf><body><h1>'月度明细'</h1><table>" // 模板骨架
  + "<tr><th>'序号'</th><th>'说明'</th></tr>${tableBody}</table></body></pdf>"); // 变量位置输出表格体
代价是表格体不再是结构化数据,而是已渲染的模板片段;后续换列或改样式时,改动点会分散到 Java 侧。数据量小、结构稳定时收益明显,结构频繁变动时反而更麻烦。多个变量可一次性用 bindAll(Map<String,Object>) 绑定。
显式分段分页示例
把“按页重复表头”落到代码上,就是按固定行数切段、每段自带表头、段末强制分页:
StringBuilder body = new StringBuilder(); // 文档体缓冲
for (int i = 1; i <= 80; i++) {
    // 遍历全部数据行
  if ((i - 1) % 30 == 0) {
    // 每 30 行开一个新段
    body.append("<table><tr><th>'序号'</th><th>'说明'</th></tr>"); // 本段表头
  }
  body.append("<tr><td>'").append(i).append("</td><td>'第").append(i).append("行说明。</td></tr>"); // 数据行
  if (i % 30 == 0) {
    // 本段收尾
    body.append("</table><areaBreak>"); // 结束表格并强制分页
  }
}
areaBreak 是强制分页元素,代价是每段末尾可能留下空白;分段长度应按页面可用高度估算,而不是固定写死 30 行。数据总量不是分段整数倍时,还要在循环结束后补上最后一段。
关键细节
- 80 行长表验证方法:构造 80 行、每行含一段中文长说明的数据,生成 PDF 后用分页阅读器逐页检查,统计页数,确认行号连续、无缺行、无重复。
- 换行检查:确认长说明在单元格宽度内换行,且没有被裁切;行高应随换行行数增加而增长。
- 跨页可读性检查:查看跨页处的行是否完整、表头块是否重新出现,必要时调整每段行数。
- 中文测试覆盖纯中文、中英混排与标点;空值应显式绑定并保持列结构稳定。
- 空集合场景下表格只剩表头,要确认表头仍能正常渲染。
- 超长且缺空格的文本更易产生异常宽内容,应用
maxWidth做保护并在业务层限制长度。 - 大批量导出要限制单次条数并监控内存峰值,避免整份数据与模板字符串同时驻留。
- 失败排查:出现内容重叠查行高与固定高度是否冲突;最右列丢失查表格宽度是否超出可用宽度;分页异常查是否误用了未证实的重复表头能力。
实战说明
下面程序用循环构造 80 行含长文本的明细表,交由渲染器自然分页,输出当前目录的 paged-table.pdf:
import com.github.paohaijiao.executor.JQuickPdfFactory; // 导入工厂
import java.nio.file.*; // 导入文件工具
public class PagedTableDemo {
    // 声明类
    public static void main(String[] args) throws Exception {
    // 声明入口
        StringBuilder rows = new StringBuilder(); // 创建行缓冲
        for (int i = 1; i <= 80; i++) {
    // 构造测试长表
            rows.append("<tr><td>'").append(i).append("'</td><td>") // 添加序号
                    .append("'这是用于验证自动换行的业务说明,这是第").append(i).append("行。'</td></tr>"); // 添加长文本
        }
        String template = "<pdf><body><h1>'月度明细'</h1><table>" // 创建模板
                + "<tr><th>'序号'</th><th>'说明'</th></tr>" // 添加表头
                + rows + "</table></body></pdf>"; // 放入所有行
        System.out.println(template);
        byte[] pdf = new JQuickPdfFactory().executeContent(template); // 执行分页渲染
        Files.write(Paths.get("d://test//paged-table.pdf"), pdf); // 保存文件
    }
}
效果图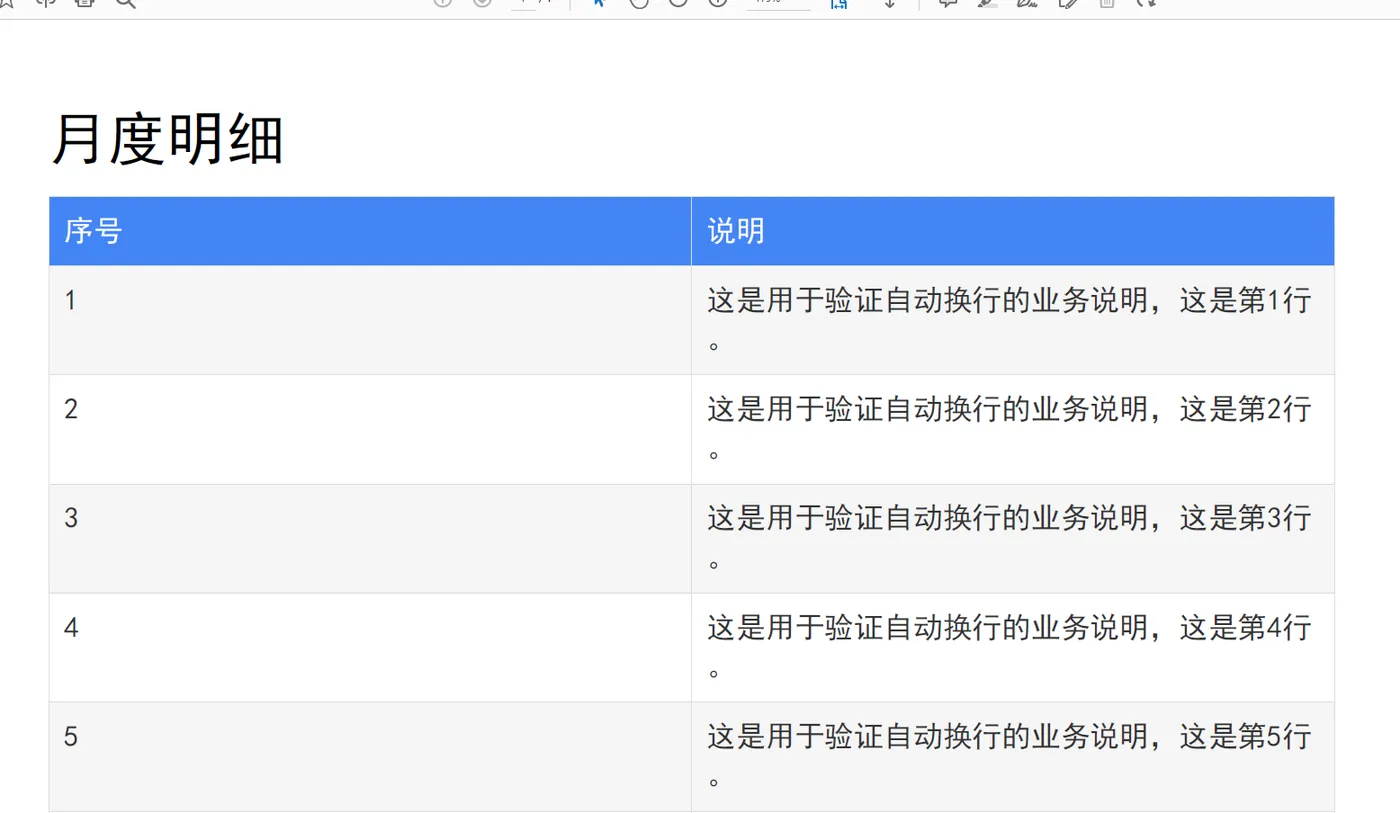
代码分四步:先用 StringBuilder 循环 80 次,每次生成一行两列,第一列是序号、第二列是中文长说明;再把表头行与全部数据行拼进 <table>;随后调用 executeContent,由渲染器决定分页点;最后写文件。运行后应得到一个多页 PDF,较长说明在单元格可用宽度内换行,行高随换行行数增加。建议在验收时逐页核对:行号是否从 1 连续到 80、跨页处是否缺行、说明文字是否被截断。生产环境应把数据切段后在业务层重建表头,并对单次导出行数设置上限。
分页异常排查顺序
- 先确认模板是否合法:根元素为
<pdf>或<html>、文本字面量是否使用单引号、标签是否闭合,语法问题会直接抛出解析异常。 - 检查是否有元素被写死整页高度,挤掉了后续块的分页余量。
- 检查是否存在无法换行的超长字符串,用
maxWidth约束宽度或在业务层插入分隔。 - 把数据量减半复测,区分是数据规模问题还是单行高度问题。
- 核对
keepTogether是否把过大的块绑在一起,导致整块被推到下一页。 - 若启用了分段方案,确认最后一段是否补齐——非整数倍时容易丢行。
总结
本文的结论是:jquick-pdf 的表格由布局引擎负责自然分页,<tr> 可设高度,单元格内长文本会自动换行并带动行高自适应,表格宽度需要与页面可用宽度匹配。常见误区有两个:一是把整页高度写死,导致长说明挤占相邻内容;二是假定重复表头已生效而不做验证。跨页报表的稳妥做法是在业务层切段并显式重建表头,同时用 80 行长文本样例做分页回归。版本基线:jquick-pdfx 4.0.0、JDK 8+,升级前请核对 README_zh.md 的版本对照表;更多示例见 GitHub 仓库。