
之前给客户做一个报告生成项目。测试环境用云厂商的大模型,效果不错,客户也认可;正式交付按要求换成客户集团私有化部署的模型,准确率掉了很多。
模型的更换,对于写代码的人,可能无感,甚至有时候是生产力提升——这个新出的模型实在夯,之前的都弱爆了!但是对于业务来说可能情况就相反了。过去两年给 AI 攒的业务知识:几千条数据字典,一条条核对出来的业务规则,调了几百遍才顺手的提示词。这些东西全是照着现在这个模型的脾气磨出来的。模型一换,还作数吗?
这个其实是两种不同的需求。写代码更多关注模型能力差距,谁强换谁,唯一需要考虑的是价格、成本。另一种是:项目里那套提示词、示范样例、输出格式的约定,全是照着一个模型的脾气磨了几个月的,搬到新模型上,这些调校能不能保持。但现实情况就是这样,同样一句指令,原来的模型懂,新的模型不懂。当时我们管这叫兼容性问题,靠重新调参硬磨了回来,磨到什么程度算恢复,其实也没有裁判,全凭人看着像。
后来读到人民大学 EvoOntology 项目(arXiv 2609.15779)的一组实验,才发现这不是我们项目特有的事故,是有数字的规律。而且实验回答了一个我们当时没顾上想的问题:项目里攒下的那些业务知识——报告怎么组织、数据口径怎么取、哪些数字该进哪张表——换模型的时候,哪些是真的作废了,哪些根本没动过?
上一篇文章里我核过这个项目的评测模块源码,谈的是它怎么让知识库自己长大;这篇只谈迁移——模型换了,长出来的东西还剩多少。
一、同一份业务,四个模型养出四份不一样的知识库
实验设计很干净。GPT 家两款、Claude 家两款,四个模型从同一份初始知识库出发,面对同一份企业数据,各自跑任务、各自积累,互不通信。若干轮之后,把四份知识库放在一起比。
长歪了,而且歪得很明显。两两比较各自沉淀下来的概念集合,重合度最高的一对只有 0.62。交叉使用也一律掉分:把 GPT 养的那本交给 Claude 用,成绩至少掉 6.6 个百分点,最惨的一档平均掉 10.9;每一列都是自己养的那份得分最高,没有例外。
有个细节容易被略过:两款 Claude 之间的重合度(0.55)比两款 GPT 之间(0.61)还低。同一家厂商的模型,互相之间也没养出多少默契。说明这个印记不在「厂商风格」这么粗的层面上,它长在具体模型的行为习惯里——它怎么查知识库、习惯什么粒度的回答、到什么时候觉得信息够了。指望「都选同一家」来躲开迁移成本的团队,这条路走不通。
直觉反应是:攒的东西随模型报废,攒了也白攒。先别急着下这个结论,得先搞清楚一件事——这四个模型各自改来改去的,改的到底是什么。
二、改来改去,改的大半是怎么喂
把四个模型演化中被接受的修改按内容拆开:改「知识怎么喂给模型」的占 57%——入口说明怎么写、查询接口按什么粒度返回、提示词怎么措辞。这一整套安排,下文简称喂法。改业务内容本身的占 34%;剩下 9% 动的是底层结构。
也就是说,超过一半的收益不是往库里补了新的业务知识,而是把知识的喂法调得越来越合这个模型的脾气。论文里有个例子:GPT-5.5 在演化中长出了一套常用查询片段的收藏,它发现存几段验证过的查询、下次直接拿来用,比自己每次现写顺手;Claude-Opus-4.8 完全没长这个,它长出来的是分档更细的入口说明。同一个业务,同一份数据,两个模型给自己配了两套不同的餐具。
餐具随模型作废,天经地义。麻烦的是账没这么干净——第一节里连概念的重合度都只有 0.62,概念总不能算餐具,那是知识本身。
乍看矛盾,拆开不是。概念重合度低,不必然说明两个模型对业务的理解有冲突,它们可能只是给相近的东西起了不同名字、切了不同粒度,论文作者自己也承认,标识符对不上不能判定语义不等价。但交叉使用实打实掉分,说明差别也不只是叫法:概念该切多细、挂在哪个上级概念底下、跟哪些字段映射打包在一起,这些选择都是被模型的行为一轮轮筛出来的。表达什么和怎么表达,在演化里是揉在一起长的,揉进去的那部分就是迁移成本。
所以第一节的实验真正说的是:不是知识作废了,是知识和喂法记在了同一个账本上,换模型时被一起扔掉了。想保住点什么,得先把账本拆成两本。
三、哪种知识不随模型作废
拆账的标准就一条:换一个模型,这条知识会不会变。
业务定义不会变。「收入」按回款算还是按开票算,是业务定的,跟模型无关。字段映射不会变。某个概念对应数据库里哪一列,这是数据库的事实。探针证据不会变。某一列的取值分布长什么样,是发真实查询核对过的,记录的是观测结果,不是谁的看法。人工核定过的标准答案也不会变。历史任务的对错,不随答题的人换人而改变。
这四样的共同点是,它们是对世界的记录,不是模型的生成。EvoOntology 有一条纪律,我在上一篇里说它最值得抄:每条进库的语义,必须由一次可执行的探针查询作凭证。判断某个字段可能是「收入」,不能只写一句「我认为这个字段像收入」,必须真发查询,看字段类型、看真实取值、看关联关系,核对通过才许写入,并且把这次观察一并存档。观测,不随观测者换人而改变。
这个区分在另一篇文章《向量库为什么回答不了「为什么」》里讲得最透:让模型解释一个决策,它给你的是照着结果圆出来的事后叙事,换个模型,叙事就换个样子;而在决策发生那一刻记录下来的证据,不随解释者改变。生成的东西随模型作废,记录的东西不会。
这不是纸上推演,有团队真的完整换过一遍模型。淘天商家财务团队把同一套知识库和决策函数先跑在 opus 上,后来模型换成 gpt5.5、glm5.2、qwen,平台整个换了一遍,真实需求的输出稳定性没有变。活下来的正是记录的那一半——红冲工单要取哪些证据、哪条路绝对不能走,这些判断写在本体和决策函数里,不写在哪个模型的提示词里。
这还能回答一个常见问题:AI 生成的知识文档算不算资产?大部分不算。自动总结出来、没人核对过的业务说明和字段描述是生成物,不等换模型就开始腐化。只有经过探针核对、留下观测凭证、或者人工核定过的那部分,才算完成了从生成到记录的转化。
四、标准答案是唯一中立的资产
记录那一半里,哪种最值钱?这决定了迁移那天手里有没有牌。
把知识库内容层的组件逐个屏掉、重跑同一批任务,账是这样的:去掉字段映射,掉 13.4 分;去掉探针证据,掉 8.7 分。两根最承重的墙,恰好都在记录那一半里。知识库最值钱的部分,正是最不怕模型换代的部分——这是整组实验里我认为最让人安心的结论。
但迁移那天真正决定成败的是第四样:标准答案,也就是验证任务集。原因在演化循环的工作机制里。它敢自动修改知识库,靠的是每次修改都要在同一批验证任务上、同参数同预算地跟旧版本成对比较,赢了才发布——上一篇我核过这道门控的实现,也核过拆掉它的代价:去掉门控,掉 11.2 分,整个系统退化成让模型自由改知识库。
验证任务不依赖任何一版知识库,也不依赖任何一个模型,它是整个系统里唯一中立的资产。迁移那天,知识库可以重长,喂法可以重调,只要标准答案还在,重长就是有裁判、有方向、会收敛的过程;标准答案丢了,迁移就退化成把所有东西凭感觉重调一遍,而且没有任何办法证明调完比原来好——开头报告生成项目里那场「磨到什么程度算恢复、全凭人看着像」的调参,就是这个状态。
拆出来的账本长这样:
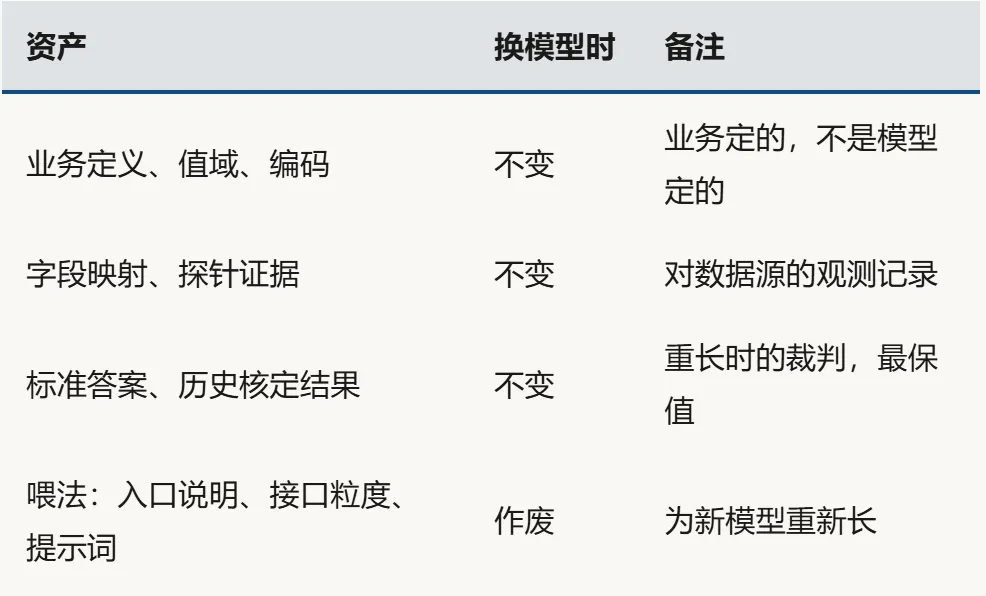
账本对着实验算是算清了。但它管不管用,得拿一个真项目的账来对一对。
五、拿一个真项目的账本来对
我们建筑工程这边有一个本体数据平台,管着元素分类、空间分类和属性字典。它一直在开发基于大模型的语义匹配:设计师的模型里写「砼柱」,物料系统里叫「RC柱」,验收记录里是「结构柱」,让模型判断这些是不是同一个东西。喂法进了生产环境,就是这个样子——一堆照着某个模型的脾气调出来的判断逻辑。
拿账本逐项对。
业务语义已经有了。属性字典的表里躺着 name、definition、unit、data_type、value_limit,这就是业务定义和值域该有的样子。C30 混凝土是什么、强度值域多少,换任何模型都不会变。这部分可以直接入账,而且它已经是以数据库表的形式存在的,比大多数团队「写在文档里」的语义层硬得多。
喂法那本账也很清楚。匹配的提示词、候选项的组织方式、接口返回的粒度,都是照现在这个模型调的,换模型就得重调。这属于正常损耗,不用心疼。
真正的问题在中间地带。「结构柱=砼柱=RC柱」这类判断,现在既不在字典里,也不在任何表里,它活在模型的隐式理解里——每次匹配成功,这个判断就随会话消失了,下次遇到同样的写法再判一遍。按第三节那条标准,这是最典型的生成物:干着记录该干的活,却没留下任何记录。模型明天停服,这些判断全部清零,而且没人说得清清零的到底是哪些。
补法也是照账本来的。每次匹配成功,把表面写法、归一到的概念、来源样本、置信度、有没有人工复核过,存成一条证据;等价关系从反复出现的证据里定期提炼,落进数据库,别再让模型每次现场重判;历史项目的验收台账、算量表这些人工核定过的结果,收进标准答案集。这三样补齐,平台就有了完整的语义和裁判。
到那天再换匹配模型,迁移就是照流程走:字典和证据表冻结不动,旧的提示词和接口配置整份归档(别删,回滚要用,它还是研究「不同模型要不同喂法」的第一手样本),让新模型在真实任务上重新调出它的匹配策略,然后拿历史台账回放验收——新策略算出来的结果跟当年人工核定的对得上、确实更好,才发布。重长也不是从零开始,EvoOntology 的收敛曲线给过参照:概念数从 61 长到 80 就不怎么长了,语义缺口的大头早被已有知识填掉,新模型要长的主要是喂法,收敛得快。这么走下来,迁移从一场事故演练变成一次普通发版。
这里还有个转机。喂法原本最让人沮丧的地方是「随模型作废」,但证据一旦入账,它反而成了语义的原料产地——每一次匹配都在沉淀证据,每一次人工复核都在加厚标准答案集。两者之间不是一堵墙,是一条能修通的转化通道。修不修,取决于第一天记账的时候有没有给证据留位置。
六、多模型并行,和行业标准的形态
迁移是一次性事件,更日常的状态是多个模型同时在跑:不同任务路由到不同模型,或者新旧模型灰度并行。这时候账怎么记?
三条路线摆在一起。每个模型养一份完整的知识库,性能最优——自己养的永远最高——代价是 N 份运维,而且业务定义被复制了 N 份,哪天口径变更,N 份要同步改。所有模型共用一份,运维最省,代价是实测每个模型至少损失 6.6 分。第三条:语义基础共享一份,喂法每个模型各配一套。
我取第三条。理由不是它居中,而是前两条各违反了资产的一半本性:定义和证据本来就不随模型变,就该只有一份;接口粒度本来就模型相关,就该各配各的。
把这个结论再放大一层,就是跨组织行业标准的唯一现实形态:只统一事实的格式,放开事实的用法。行业标准能要求的是每条语义必须带来源、带凭证、带核定记录;不能要求的是所有人用同一种方式建模、组织、暴露——迁移实验已经证明连一个模型家族内部都对不齐,跨组织更不可能。
七、发布之前,三件事说清楚
0.62 是个代理指标,别当精确刻度用。概念标识符的重合度判定不了语义等价,重合度低未必等于知识冲突;但交叉使用的掉分是硬证据,喂法的差异真实存在、真实花钱。我的读法是:知识资产完全可移植被证伪了,完全不可共享没有被证明。哪些能共享,拿第三节那句话逐项过,不能打包下结论。
实验跑在数据智能体基准上,不是真实企业。权限控制、多人修改、规则冲突、审计、长期版本治理,都不在范围内。第五节给建筑平台开的方子是在论文机制上做的工程外推,落地时每一步都会撞上论文没碰的组织问题——人工核定谁来做、按什么节奏做、核错了谁负责,这些比技术难。
「随模型作废」不能当成放弃治理喂法的借口。它会作废,但作废前的每一天都在生产环境里服役,它的每次修改同样要过门控、要能回滚——EvoOntology 对喂法的编辑用的是和业务内容同一套配对验证,没有因为这层是模型相关的就放任自由改。会过期的资产也是资产,过期之前它得是对的。
结语
这篇文章说到底是一个记账原则:知识资产分两种,记录下来的和生成出来的。探针观测、人工核定、标准答案是记录,跟着业务走;调好的提示词、演化出的接口形态是生成,跟着模型走。资产的保值率,等于其中记录的比例。
换模型不是重建,是重长。冻结事实,归档旧的那套喂法,让新模型在标准答案的裁判下重新长出它自己的喂法,迁移就不是一件心里没底的事,而是一件有流程、有验收、能做完的事。
好在最值钱的资产恰好最保值。两根最承重的墙是字段映射和探针证据,都在业务语义里;唯一的裁判是标准答案,换几代模型它都坐在那里。往证据和标准答案里投的每一分钱,都不会给下一款模型陪葬。
模型是公用的,一代代地换;记录是自己的,一寸寸地攒。换模型那天,账本上一眼看得清哪些带得走。语义基础设施做到这一步,才算数。

