数据治理-重点、方法、目标(1)

简介: 20年数据老兵坦言:数据开发、数仓、大数据驾轻就熟,唯数据治理屡感挫败。重读DAMA2后反思:治理核心非文档工具,而是“决策权与问责机制”;落地关键不在顶层设计,而在找准业务痛点——数据质量才是最强驱动力。

 我做了20年的数据工作了,数据开发、数据仓库、大数据我都认为自己手到擒来,唯独在数据治理这个领域,我这些年职业生涯感受到更多的是那种受挫感。在家闲着,把DAMA2这本书又努力看了一遍。说实话这本书里面的知识含量确实太高了,再次看完以后的总体感觉还是知识爆炸,太多的信息看完就忘记了(又又又忘记了)。

  看完这本书我想了三个我问自己的问题,让大模型参考dama2 book 回答:
1-“所有的数据治理工作能力中,最重要的是什么?”
2-“在DAMA2 车轮图框架中最重要的治理工作是那一项?”
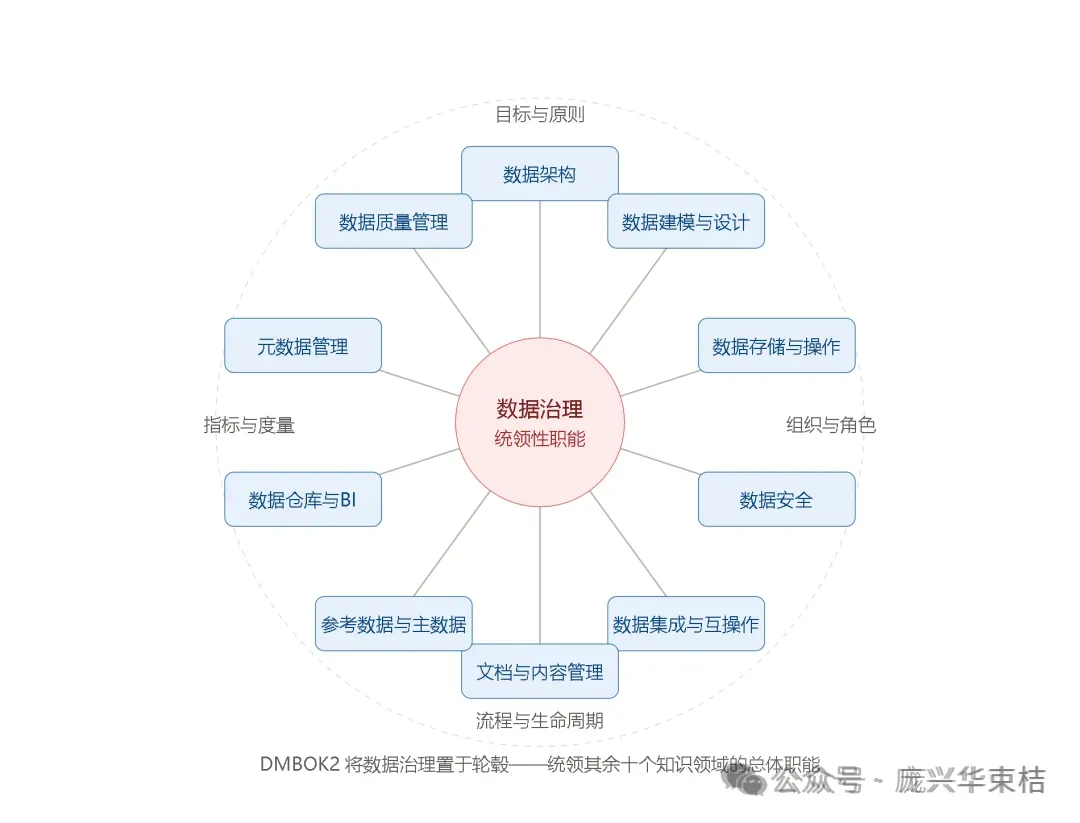
image.png

3-“如果我所在的组织要开展“数据治理”活动,最开始该建议从哪些工作做起,这些工作中最重要的是什么?如果要给这些工作定义一个业务驱动的目标,应该是什么?”

  DMBOK2 将数据治理定义为对数据管理与数据使用进行规划、监督与控制的职能,它的核心不是工具、标准文档,而是权威决策与责任归属:

  • 数据治理本质是回答 谁有权针对数据做什么决定,谁对数据结果承担责任;
  • 政策、标准、数据质量规则、元数据规范,都要依靠这套权责体系才能落地;缺少决策权与问责,所有制度都会停留在纸面,跨部门数据争议无法裁决;
  • 数据所有者(Data Owner,业务角色)承担业务决策责任,数据管家(Data Steward)负责日常落地、定义业务术语、协调数据问题,是治理落地的关键载体;

  按照DAMA2的官方内容,最重要的其实是“建立清晰的数据决策权与问责机制”。我不是不认可,只是认为从实践的角度来看,让决策层认可有“数据治理”这件事情要做,然后才能去把数据治理这么大一摊子内容打包进去,按照这套架构来“建立清晰的数据决策权与问责机制”。否则,就可能是做出一个点状事件形式的“建立清晰的数据决策权与问责机制”,大概率“头痛医头,脚痛医脚”,不得章法。

  那么就需要一个足够重要的需求,让决策层认识到数据领域的管理远不是一个点,而是一个系统性的问题。这个需求需要有强的业务驱动,也有能让管理层能真实体会到其确实需要管理层牵去,构建一套体系化的“数据治理”方案。并由此去构建“建立清晰的数据决策权与问责机制”,这是果,我们最先需要找到的应该是因。

  这也是我读完这本书,会提出这个问题的原因,为什么要做“数据治理”?为什么要去构建“建立清晰的数据决策权与问责机制”。

  我认为从数据治理领域来看,数据质量与数据安全是唯二的“因”,而且从我经历的日常工作角度来看,数据质量的“因”更大,也更容易依靠这“因”把整个“数据治理”的各个领域穿起来。数据安全因为其影响决策时候的“一票否决”,在很多时候可能更容易由此引出企业实际去落地“数据治理”工作。但是很多时候这是一个附加条件,而不是必要条件。业务牵扯面不如数据质量这么深入。

  上面是我回答的我的第一个问题,反过来看我的第二个问题“在DAMA2 车轮图框架中最重要的治理工作”的回答就应该是“数据治理”。因为在这套架构中“数据治理”处于中心环节,第一个问题我的回答案虽然不是“数据治理”,但是也是为了“建立清晰的数据决策权与问责机制”。这就是最重要的,并无异议。

  就剩下三个问题,这是一连串的问题。包括:“从哪儿做起”、“最重要的”、“业务驱动目标”。先说从哪儿做起。

  • 第一步必然是现状评估,识别业务痛点,评估组织当前数据管理成熟度,识别业务最关心的数据问题(统计口径不一致、数据错误、合规风险、数据不可用等),找到业务驱动的切入点,避免纯 IT 驱动治理。
  • 第二步,要开始获取高层支持,建立跨业务治理组织:成立数据治理委员会(DGC),任命业务侧的数据所有者(Data Owner)、领域数据管家(Data Steward),明确角色、RACI 权责;DMBOK2 强调数据所有权属于业务,不是 IT。
  • 第三步, 制定数据治理章程、原则与数据政策:发布治理章程,明确治理的授权、决策流程、争议升级机制、基础治理原则(业务驱动、数据作为资产、共担责任)。
  • 第四步,制定路线图与可度量指标:规划分阶段落地计划,定义治理成效衡量指标,从小范围试点起步,逐步扩大范围。

  上面就是DMBOK2提供的步骤,这期间最重要的我仍然认为是“找到业务驱动的切入点”,万事开头难,第一步就是最重要的一步。做好“数据治理”的开头,找到一个能推动进行后面几步的“切入点”才是最重要的。找到这个点,然后再获得高层支持,再构建“数据治理的组织与流程”,制定“路线图”并坚持走下去。

  让我们都能找到真正能把数据治理工作头开好的“切入点”,做好关键的第一步吧。
相关实践学习
基于Hologres轻量实时的高性能OLAP分析
本教程基于GitHub Archive公开数据集,通过DataWorks将GitHub中的项⽬、行为等20多种事件类型数据实时采集至Hologres进行分析,同时使用DataV内置模板,快速搭建实时可视化数据大屏,从开发者、项⽬、编程语⾔等多个维度了解GitHub实时数据变化情况。
目录
相关文章
|
存储 DataWorks Unix
Dataworks数据集成之“文本数据”
Dataworks不是支持文本数据导入么?为什么Excel数据不能导入?CSV文件不就是Excel文件么?关于这些问题,我整理了一篇文章进行解释。
1790 2
|
1月前
|
人工智能 JavaScript 开发工具
DeepSeek Harness完整实操教程:开源Agent运行框架本地部署、模式选型与插件开发指南
DeepSeek Harness把大模型从单纯对话,推向真实本地环境执行任务,依托Cordis插件架构实现组件完全可替换,给Agent开发者提供了一套能力强大的开源底座。整套工具的使用流程可以概括为:准备适配版本Node.js环境,通过npx一行命令快速拉起Web界面,配置模型密钥或者对接Ollama本地模型,选择隔离的工作目录,根据任务选择合适运行模式,下发指令观察Agent完整执行轨迹。
1312 3
|
1月前
|
人工智能 自然语言处理 JavaScript
最新版阿里云全模型通用节省计划介绍:核心优势、适用场景、模型调用方式及活动解析
阿里云百炼平台推出的全模型通用节省计划介绍,针对大模型调用成本高的行业痛点展开全面解析。该计划是面向大模型场景的预付费折扣方案,核心优势在于跨模型通用、无模型锁定风险,相比按量付费可大幅降低调用成本,同时抵扣规则透明、支持多付费周期选择。文章明确了其适配企业级AI开发、多模型混合调用等五大典型场景,梳理了覆盖通义千问全系列、多模态、代码类等主流模型的支持范围与抵扣逻辑,最后附上当前新购低至4.5折的最新活动档位与优惠券使用指引,帮助用户结合业务规模实现AI调用成本的最优管控。
|
数据采集 SQL 人工智能
DataWorks AI 助理:实现数据异常诊断工作流
本文介绍DataWorks数据异常诊断AI助理,通过语义映射、多维诊断(任务状态/数据质量/代码变更/血缘分析)和经验沉淀,实现业务方自助提报、研发高效定位。典型场景如任务依赖漏配、指标口径不一致等,可大幅压缩排查耗时,提升数据问题响应效率。(239字)
331 0
DataWorks AI 助理:实现数据异常诊断工作流
|
24天前
|
数据采集 人工智能 自然语言处理
个人IP的AI搜索优化:单平台推荐信号如何影响AI引用
本文面向开发者与技术决策者,解析AI搜索引用个人内容的机制:AI引擎依赖平台推荐信号而非自主爬取,单平台垂直深耕比多平台铺量更易被引用。文章剖析抓取逻辑、与传统SEO差异、风险及验证方法,强调账号级信号优化。
160 2
|
25天前
|
存储 缓存 算法
大缓存的机械硬盘真的更好吗?小心买到叠瓦盘(SMR)
买机械硬盘别只看缓存大小!64MB与256MB实际性能差异有限,关键在底层技术:CMR(传统记录)稳定可靠,SMR(叠瓦式)虽容量大、成本低,但频繁写入易掉速。选盘务必先确认CMR/SMR,而非盲目追求大缓存。(239字)
|
26天前
|
存储 数据采集 人工智能
企业如何应用数据中台:避免“重建设轻运营”的五大落地原则
引言:当数据中台“建成即闲置” 过去五年,数据中台在国内企业IT投入中占据了相当比重。但一个被反复验证的现实是:大量项目中,平台搭建顺利交付,上线运行后却逐步边缘化——数据接进来了、ETL任务还在跑,但业务部门依然在微信群里要Excel。Gartner的行业调研指出,超过60%的数据中台项目未能达到预期目标,真正实现业务价值并持续运转的不到20%。 问题的症结不在于技术能力,而在于建设路径的缺失。数据中台不是一次性交付的工程项目,而是需要持续迭代的能力平台。本文结合阿里云瓴羊Dataphin的产品能力与行业实践,梳理五条从“建设”走向“运营”的落地原则。
|
7月前
|
运维 分布式计算 自动驾驶
别再手写运维脚本了:Operator 才是数据平台的“自动驾驶系统”
570 3
|
人工智能 运维 自然语言处理
DataWorks DataAgent 功能系列实践
DataWorks Agent功能系列实践链接收集中
271 0
|
6月前
|
SQL 人工智能 运维
DataWorks Data Agent:一句话搞定数据开发,让周期从天级到分钟级
DataWorks Data Agent 是阿里云推出的AI原生数据开发智能体,覆盖集成、开发、运维、治理、分析全链路。它深度适配业务逻辑与开发规范,支持自然语言一键生成可信SQL及全流程交付。淘宝闪购实测:指标开发从6–8小时缩短至5–10分钟,真正实现“一句话交付”。
1271 2