
快递地址识别解析接口调用详解:参数设计、多语言示例与常见错误排查
本文以一份技术接入手册的形式,讲解「快递地址识别解析」这类接口的能力边界、参数设计与调用方法。目标读者是需要在业务里批量处理收件人信息的开发者:从一段自由填写的收件文本中,抽取姓名、电话、省市区街道等结构化字段,并做行政区补全与纠错。全文只谈技术实现与工程实践,不涉及商业引导。
1. 技术简介
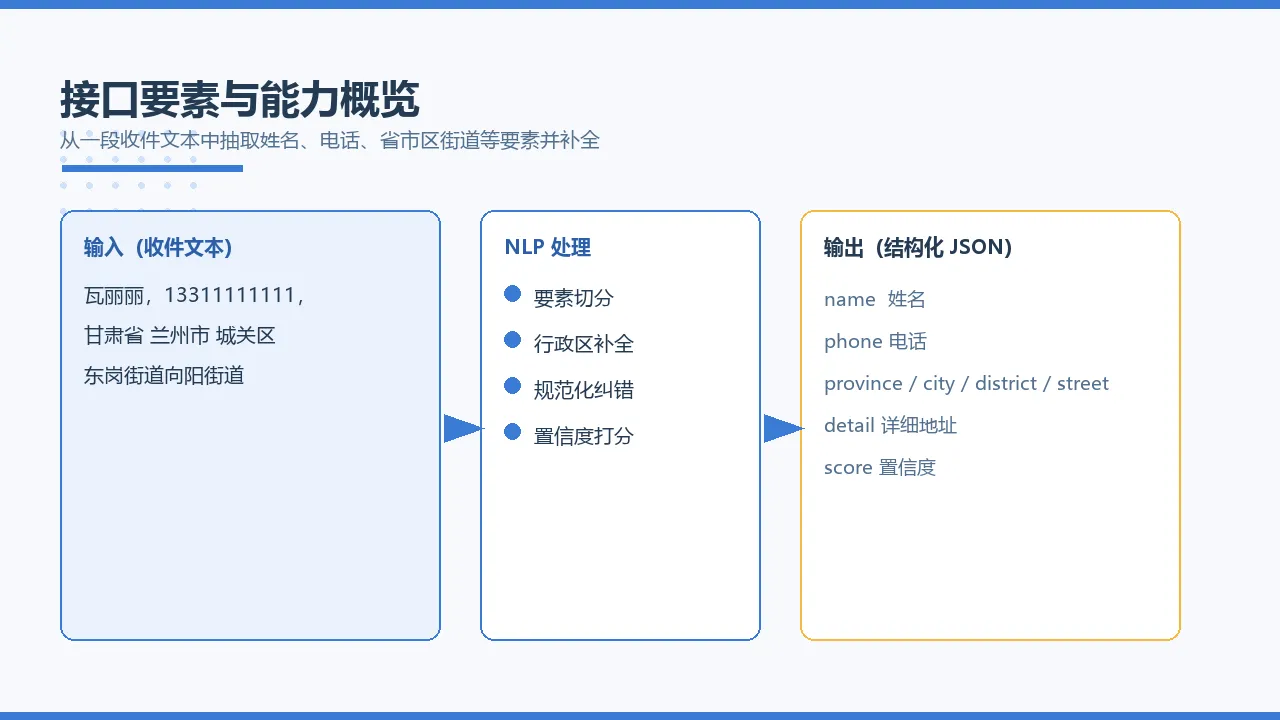
快递地址识别解析接口的输入是一段非结构化的收件文本,输出是结构化的地址要素。典型输入形如:
瓦丽丽,13311111111,甘肃省 兰州市 城关区 东岗街道向阳街道
接口通过自然语言处理(NLP)从文本中识别并抽取以下要素:
- 姓名(收件人)
- 电话(收件手机号)
- 省 / 市 / 区 / 街道 四级行政区
- 详细地址(门牌、楼栋等)
同时会基于行政区数据做自动补全与纠错:当文本里只写到区级、缺了街道,或省份写法不统一时,接口会补出规范化的标准四级地址。最终返回一组标准化的 JSON 字段,方便直接入库或对接下游系统。
一句话定位:它解决的是「收件文本 → 结构化地址数据」的转换问题,属于物流、电商、外卖等单据数字化场景里常见的数据清洗能力。
2. 能力概览
| 能力 | 说明 |
|---|---|
| 要素抽取 | 从收件文本中识别姓名、电话、省、市、区、街道 |
| 行政区补全 | 缺省下补全省 / 市 / 区 / 街道中的缺失层级 |
| 规范化纠错 | 将非标准写法(简称、口语化、繁简混用)映射到标准行政区名 |
| 置信度返回 | 附带 0–100 的结果置信度,便于调用方按阈值过滤 |
| 结构化输出 | 返回 JSON,字段稳定,可直接入库 |
能力的关键点在于「抽取得准」和「补全得对」。抽取依赖 NLP 对姓名、电话、地址段的切分;补全依赖一份标准的行政区库。两者的配合决定了最终结果的可用性。
3. 适用场景
- 快递物流:运单收件信息数字化,把人工录入的收件文本转成可检索的结构化地址。
- 电商 / 外卖:用户下单时自由填写的地址清洗,补全缺失的行政区层级。
- 数据治理:存量地址库的批量规范化,统一省市区街道四级字段。
- 地址标准化:对接地图、路由等下游系统前,先把地址字段拉齐到统一粒度。
共同特征:输入侧是「人写的、格式不一的收件文本」,输出侧是「机器可处理的标准四级地址」。
4. 接入流程
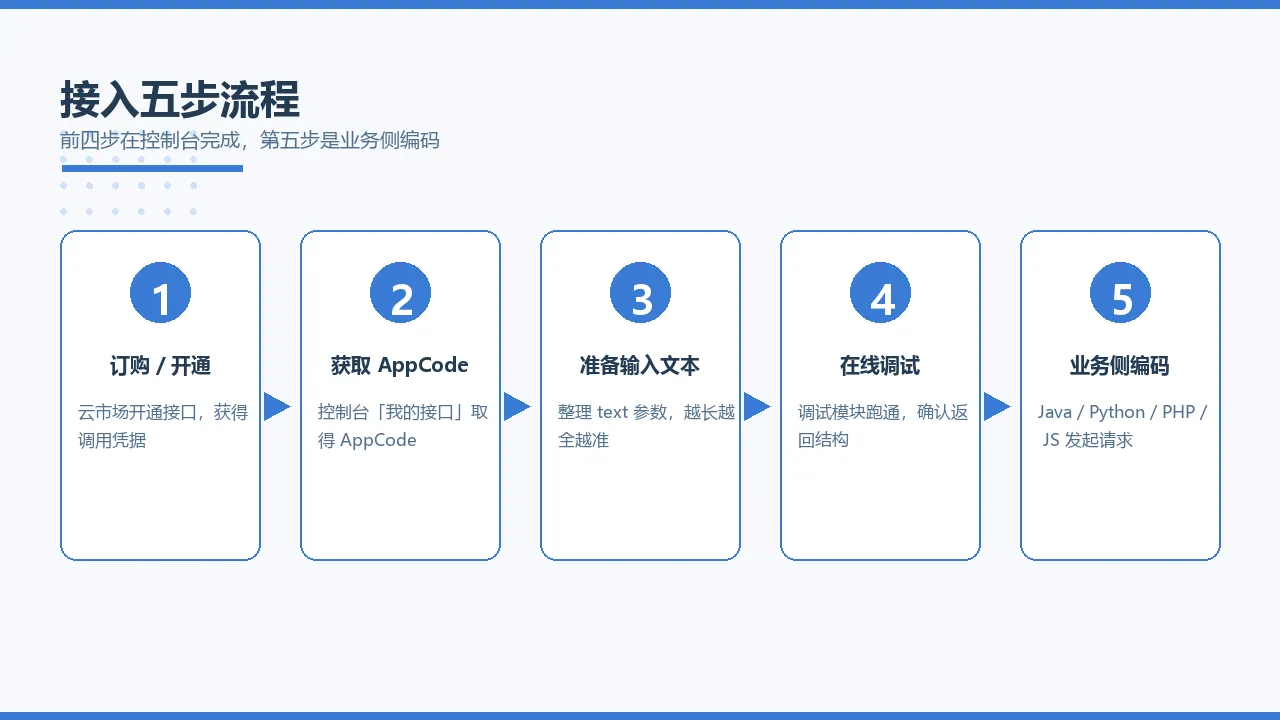
整体接入分五步,前四步在控制台完成,第五步是业务侧编码:
- 订购 / 开通:在云市场完成接口开通,获得调用凭据。
- 获取 AppCode:在控制台「我的接口」中取得 AppCode(或 AppKey / AppSecret)。
- 准备输入文本:把收件文本整理成
text参数,越长越全越准。 - 在线调试:用控制台调试模块跑通一次,确认返回结构符合预期。
- 业务侧编码:在 Java / Python / PHP / JS 中按下方示例发起请求。
控制台「获取 AppCode」入口的位置以你实际登录后的控制台页面为准。
5. 调用示例与返回结构
5.1 请求定义
| 项 | 值 |
|---|---|
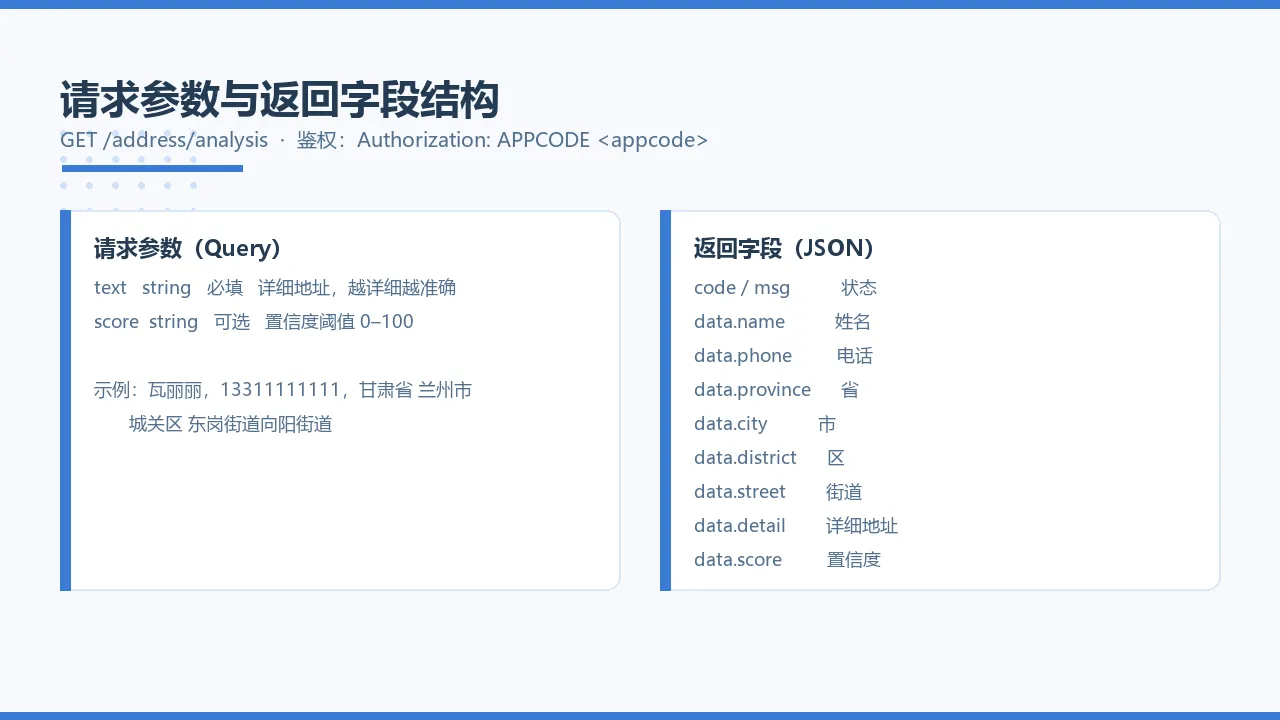
| 请求方式 | GET |
| 路径 | /address/analysis |
| 返回类型 | JSON |
| 鉴权方式 | Authorization: APPCODE <appcode> |
调用地址在控制台「接口信息」中查看,本文用 <调用地址> 占位,避免把凭据端点写死进文档。
5.2 请求参数
| 参数 | 位置 | 类型 | 必填 | 说明 |
|---|---|---|---|---|
| text | Query | string | 是 | 详细地址,越详细越准确;示例:瓦丽丽,13311111111,甘肃省 兰州市 城关区 东岗街道向阳街道 |
| score | Query | string | 否 | 结果置信度阈值 0–100;越高对输入要求越严,建议按场景实测后定值,示例 75 |
5.3 返回字段
成功返回是一个 JSON 对象,核心字段包含收件人姓名、电话、省、市、区、街道、详细地址、置信度等。示例(字段以控制台实际返回为准):
{

  "code": 0,
  "msg": "success",
  "data": {

    "name": "瓦丽丽",
    "phone": "13311111111",
    "province": "甘肃省",
    "city": "兰州市",
    "district": "城关区",
    "street": "东岗街道",
    "detail": "向阳街道",
    "score": 92
  }
}
5.4 多语言调用示例
鉴权统一走 AppCode;请求头里的
Authorization值形如APPCODE 你的AppCode。下面示例中的<调用地址>替换为控制台里的真实端点。
Python
import requests

url = "<调用地址>/address/analysis"
headers = {
   "Authorization": "APPCODE 你的AppCode"}
params = {
   "text": "瓦丽丽,13311111111,甘肃省 兰州市 城关区 东岗街道向阳街道"}
r = requests.get(url, headers=headers, params=params, timeout=10)
print(r.json())
Java
// 使用任意 HTTP 客户端,此处示意 OkHttp
Request req = new Request.Builder()
    .url("<调用地址>/address/analysis?text=" +
         URLEncoder.encode("瓦丽丽,13311111111,甘肃省 兰州市 城关区 东岗街道向阳街道", "UTF-8"))
    .addHeader("Authorization", "APPCODE 你的AppCode")
    .get().build();
try (Response resp = client.newCall(req).execute()) {

    System.out.println(resp.body().string());
}
PHP
$ch = curl_init("<调用地址>/address/analysis?text=" .
    urlencode("瓦丽丽,13311111111,甘肃省 兰州市 城关区 东岗街道向阳街道"));
curl_setopt_array($ch, [
    CURLOPT_RETURNTRANSFER => true,
    CURLOPT_HTTPHEADER => ["Authorization: APPCODE 你的AppCode"],
    CURLOPT_TIMEOUT => 10,
]);
echo curl_exec($ch);
JavaScript (Node)
const axios = require("axios");
const url = "<调用地址>/address/analysis";
const {
    data } = await axios.get(url, {

  params: {
    text: "瓦丽丽,13311111111,甘肃省 兰州市 城关区 东岗街道向阳街道" },
  headers: {
    Authorization: "APPCODE 你的AppCode" },
  timeout: 10000,
});
console.log(data);
6. 在线调试实录
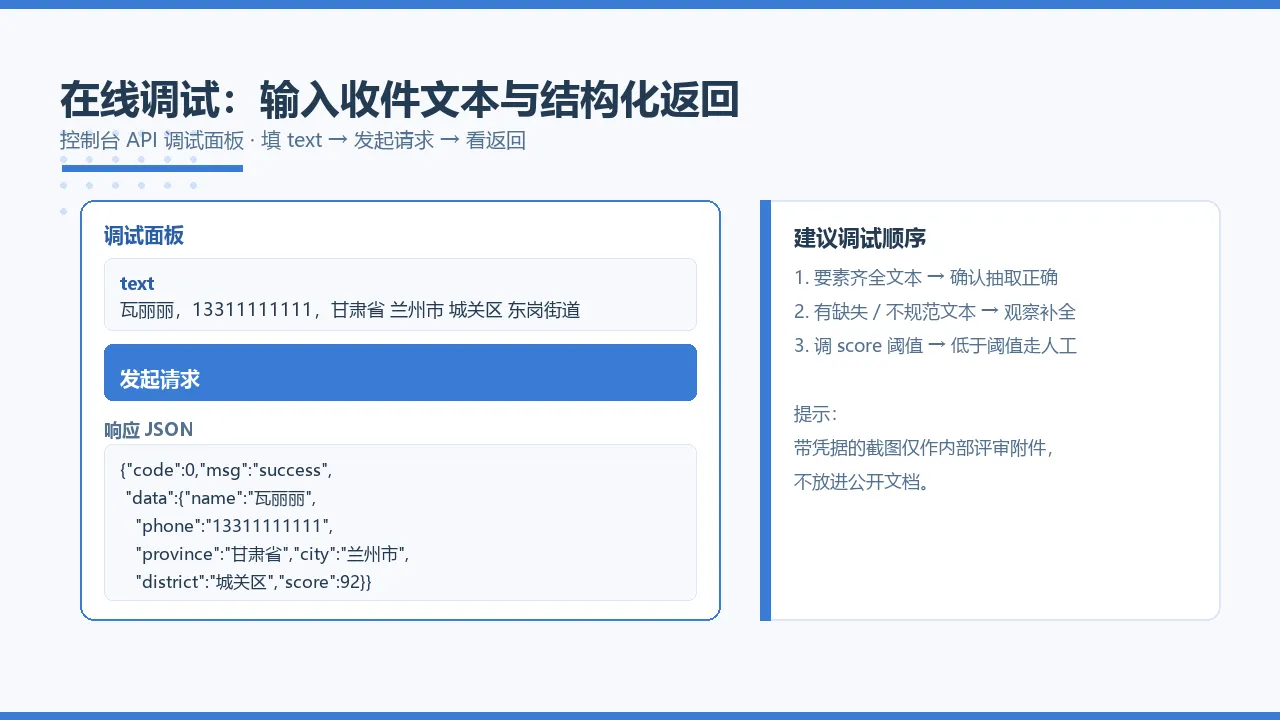
控制台提供「API 调试」面板:填入 text,点「发起请求」,可在同页看到请求、响应与调用结果。建议的调试顺序:
- 先用一段要素齐全的文本(姓名 + 电话 + 省市区街道俱全)确认抽取正确。
- 再用一段有缺失 / 不规范的文本(如只写到区、或省份用简称)观察补全与纠错效果。
- 调整
score阈值,看返回的data.score是否高于阈值——低于阈值的样本要进人工复核队列。
调试面板的截图可留作团队内部评审附件(避免在公开文档里放带凭据的截图)。
7. 调用限制与规范
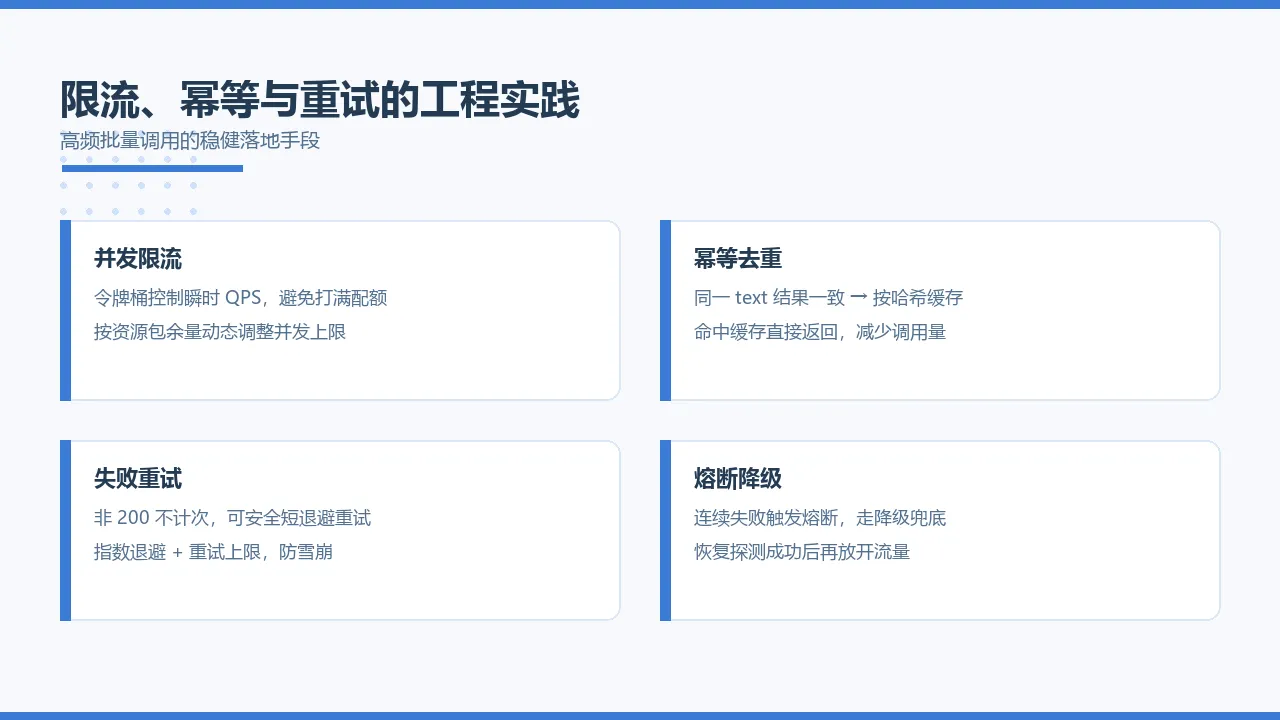
- 计次规则:仅 HTTP 状态码 200 时计次,非 200 不计次。
- 配额 / 有效期:资源包有调用次数与有效期,控制台会做余量预警与到期提醒;具体额度以你订购的版本为准。
- 频次控制:高频批量场景建议加限流(令牌桶)与重试退避,避免瞬时打满。
- 幂等:同一
text重复调用结果应一致,可据此做结果缓存,减少调用量。 - 编码:Query 参数中的中文需做 URL 编码(UTF-8)。
8. 能力边界与免责
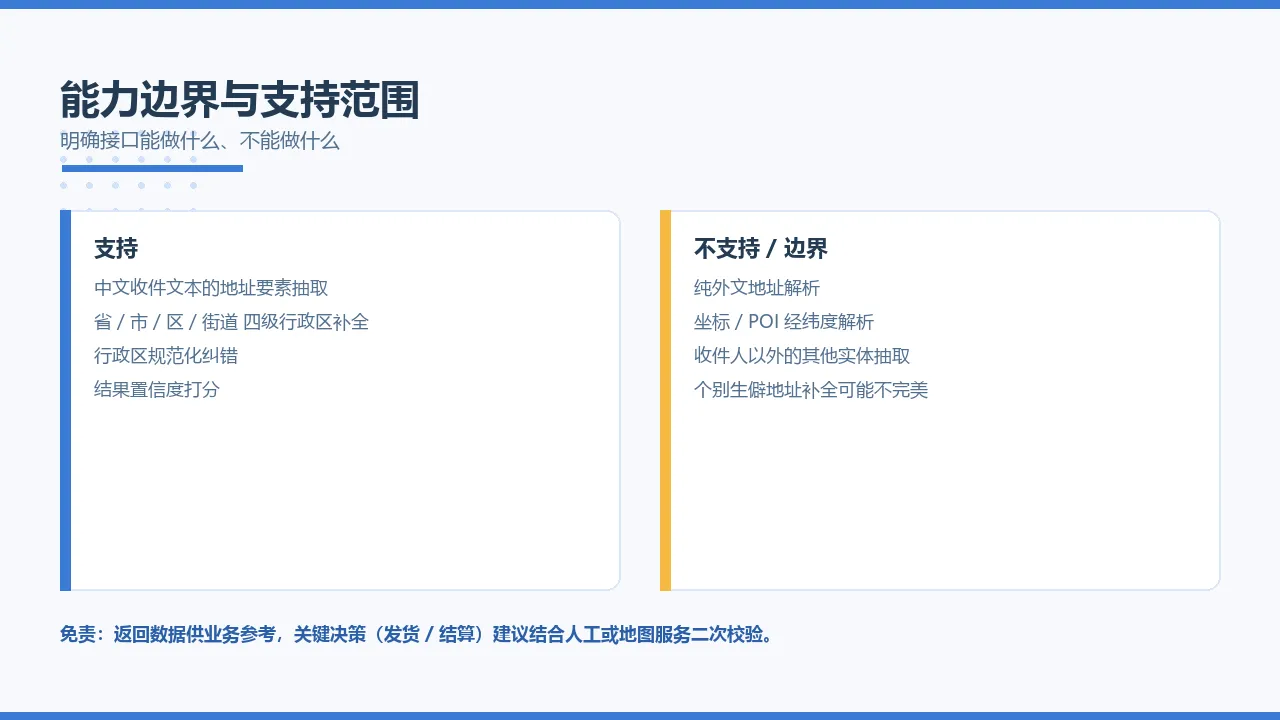
| 维度 | 说明 |
|---|---|
| 支持 | 中文收件文本的地址要素抽取与四级行政区补全 |
| 不支持 | 纯外文地址、坐标 / POI 经纬度解析、收件人以外的其他实体 |
| 边界 | 结果准确度受输入质量影响,输入越全越准;个别生僻地址可能补全不完美 |
| 免责 | 返回数据供业务参考,关键决策(如发货、结算)建议结合人工或地图服务二次校验 |
9. 错误码排查
| 现象 | 可能原因 | 处理 |
|---|---|---|
| 鉴权失败 / 无权限 | AppCode 错误或未开通 | 核对控制台 AppCode,确认已订购生效 |
| 400 类参数错误 | text 缺失或编码异常 |
补全参数,确认中文已 URL 编码 |
| 429 / 限流 | 触发 QPS 或配额上限 | 加退避重试,确认资源包余量 |
| 403 / 签名错误 | 走签名鉴权时 AppSecret 不对 | 核对 AppKey / AppSecret,重算签名 |
| 5xx | 服务端异常 | 短退避重试;持续异常走控制台故障渠道 |
10. 技术 FAQ
Q1:输入文本必须包含姓名和电话吗?
不强制。接口主要抽地址要素;姓名、电话若文本里没有则对应字段为空或置信度下降。
Q2:score 阈值设多少合适?
没有统一的标准取值。建议按业务容错度实测:对地址准确性要求高的场景把阈值调高,低置信度样本走人工;量大且可接受部分噪声则调低。
Q3:能不能批量调用?
可以。批量时建议做并发限流 + 结果缓存(按 text 哈希去重),并对 200/非 200 做不同计数。
Q4:中文里的全角、空格、换行会影响结果吗?
会。建议入库前先做规范化清洗(全角转半角、去多余空白、统一分隔符),能显著提升抽取稳定性。
Q5:支持哪些省份 / 直辖市?
覆盖全国标准行政区划,含直辖市、自治区、特别行政区按国标映射;港澳台数据以接口实际支持为准。
11. 内容小结
- 接口做一件事:把自由收件文本转成「姓名 + 电话 + 省市区街道 + 详细地址」的结构化 JSON。
- 接入关键:AppCode 鉴权、
text参数尽量全、score按场景实测定阈值。 - 工程要点:URL 编码、限流重试、按
text幂等缓存、200 才计次。 - 边界:中文地址抽取与补全,结果供业务参考,关键场景二次校验。

