pdf版下载链:https://pan.quark.cn/s/9cc742e9c2a8
19 大模型推理框架:vLLM、SGLang 与 TensorRT-LLM
难度: ⭐⭐⭐⭐⭐
更新: 2026-10-12
考点: vLLM、SGLang、TensorRT-LLM、PagedAttention、RadixAttention、推理优化时效口径:版本只表示 2026-10-12 检索到的官方发布快照,不是长期选型结论;性能结论必须来自同模型、同权重/量化、同硬件与并行拓扑、同输入/输出长度分布、同并发与同 SLO 的复现实验。
📋 目录
- 三大推理框架概述
- 核心技术对比
- 性能基准对比
- 选型与落地实践
- 高频面试题
一、三大推理框架概述
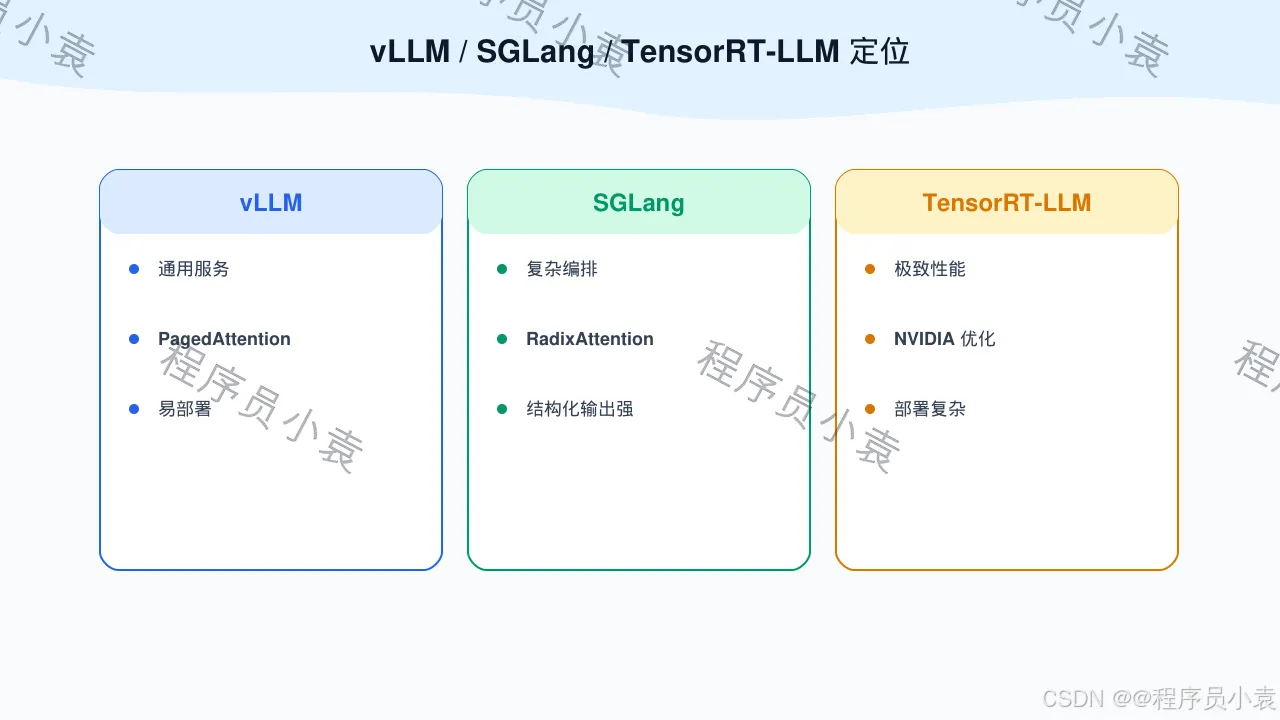
Q1: vLLM、SGLang、TensorRT-LLM 三大推理框架各自定位是什么?
图解:vLLM / SGLang / TensorRT-LLM 定位
💡 答案要点
三大框架定位对比:
| 框架 | 开发团队 | 核心定位 | 设计理念 |
|---|---|---|---|
| vLLM | vLLM 社区 / PyTorch Foundation | 通用开源推理与 OpenAI 兼容服务 | V1 统一调度、PagedAttention、广泛模型与硬件支持 |
| SGLang | SGLang 社区 | LLM/VLM 高性能服务与程序化生成 | Radix Cache、HiCache、PD 分离、结构化输出 |
| TensorRT-LLM | NVIDIA | NVIDIA 平台上的生产推理栈 | PyTorch 后端、优化内核、并行/量化与 KV 复用 |
一句话总结:
- vLLM:优先考虑生态兼容、快速接入和跨模型迭代。
- SGLang:优先考虑高前缀复用、分层 KV 缓存或复杂服务拓扑。
- TensorRT-LLM:在 NVIDIA 硬件上做深度联合优化;是否更快仍要以本地 workload benchmark 为准。
截至 2026-10-12 的官方发布快照:
- vLLM
v0.29.0(2026-09-09):Model Runner V2 默认启用;V1 统一调度覆盖 prefix caching、chunked prefill、speculative decoding 等能力。 - SGLang
v0.5.21(2026-10-02):Rust 前缀缓存核心默认启用,PD 实例支持运行时切换角色,并继续增强 HiCache/异构 PD。 - TensorRT-LLM 官方 Releases 在检索日列出
v1.3.0rc29;1.3.0rc23起已移除旧 TensorRT execution backend,PyTorch 成为唯一执行后端。预发布版不等于生产稳定版。
面试话术:
"我不会先给框架排固定名次,而是先冻结模型、精度、并行拓扑和流量分布,再比较 TTFT、TPOT、端到端吞吐、P99、显存、错误率和单位成功请求成本。"
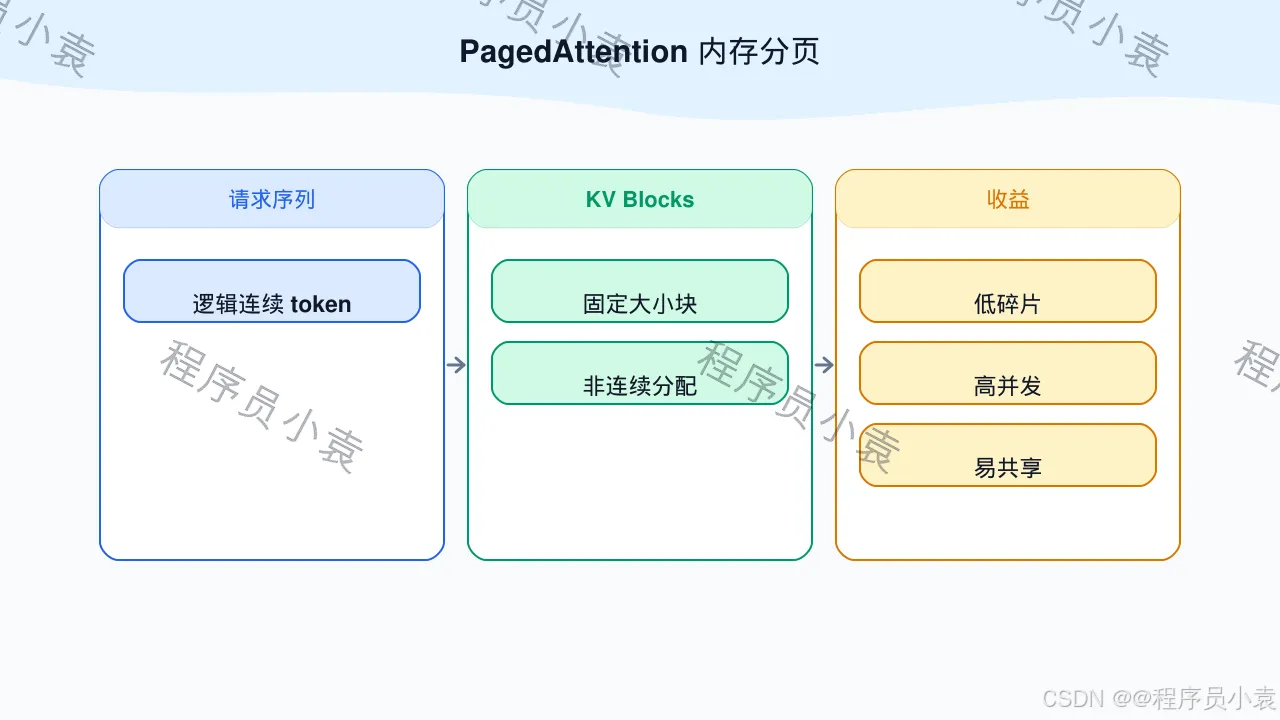
Q2: 什么是 PagedAttention?它解决了什么问题?
图解:PagedAttention 内存分页
💡 答案要点
问题背景:
- LLM推理需要存储KV Cache(键值缓存)
- 传统方案:连续内存分配,预分配固定大小
- 问题:连续预留会产生内部/外部碎片,并因请求长度未知而过度预留
PagedAttention 解决方案:
传统方案:
显存: [请求1的KV  ][请求2的KV  ][    空闲    ]
      4GB        3GB         9GB → 碎片,无法分配

PagedAttention(分页式):
显存: [块0][块1][块2][块3][块4][块5][块6][块7]
      逻辑 KV 序列映射到可非连续物理块,按需分配和复用
      → 减少碎片与预留浪费,容纳更多活跃序列
核心原理:
- 受操作系统虚拟内存/分页启发
- KV Cache 按固定大小 block 管理;block size 是实现/配置细节,不应背成永远 16 tokens
- 一个逻辑序列的物理块不要求连续;block table 完成逻辑到物理映射
性能提升:
- 原论文报告的收益依赖模型、序列分布与对照系统,不能外推为所有场景固定倍数
- 它直接改善 KV 内存管理;最终吞吐仍受调度、内核、带宽、量化和请求分布影响
面试话术:
"PagedAttention 把逻辑 KV 序列映射到按需分配的物理块,减少连续预留和碎片;它不是‘物理连续’,也不能脱离 workload 承诺固定利用率或吞吐倍数。"
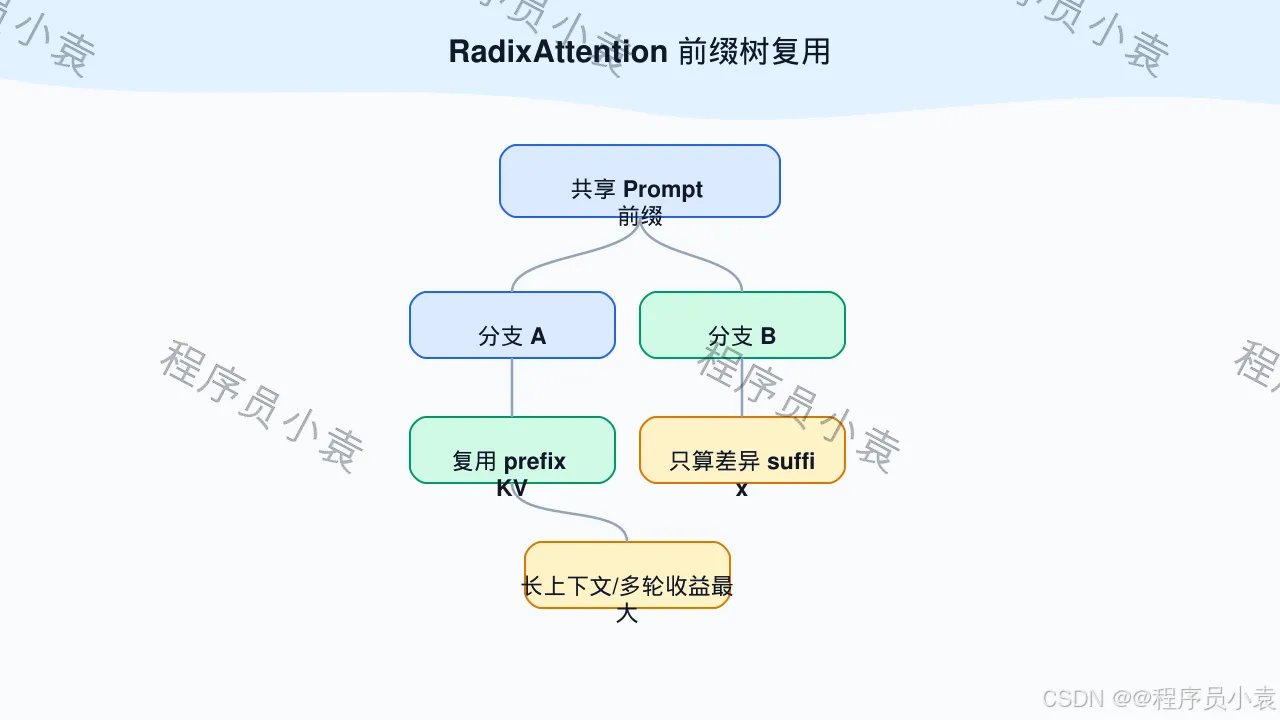
Q3: 什么是 RadixAttention?和 PagedAttention 有什么区别?
图解:RadixAttention 前缀树复用
💡 答案要点
RadixAttention = SGLang 的核心技术创新
核心思想:
- 多轮对话场景中,前缀(system prompt、few-shot examples)通常是共享的
- RadixAttention 用基数树(Radix Tree)管理 KV Cache
- 实现跨请求的前缀复用和自动缓存
工作原理:
请求1: [System] + [User1] → 生成 [Response1]
请求2: [System] + [User2] → 生成 [Response2]
请求3: [System] + [User1追问] → 生成 [Response3]

RadixAttention 的 KV Cache 结构:
         [System]
           ↓
    [User1] ← → [User2]
      ↓            ↓
  [Response1]  [Response2]
      ↓
  [User1追问] → [Response3]

→ System prompt 的 KV Cache 被三个请求共享
性能对比:
| 指标 | PagedAttention (vLLM) | RadixAttention (SGLang) |
|---|---|---|
| 主要抽象 | 分页 KV 内存管理 | 以前缀树组织可复用 KV |
| 前缀缓存 | V1 已支持 automatic prefix caching | 核心能力,Unified Radix Cache 持续演进 |
| 关注点 | 降低块分配浪费、支撑调度 | 匹配、复用和淘汰共享前缀 |
| 收益条件 | 并发和长度分布 | 前缀命中率、容量与淘汰策略 |
面试话术:
"RadixAttention 用基数树管理共享前缀,命中时可跳过重复 prefill。vLLM 也支持前缀缓存,因此要比较实际命中率、淘汰策略、并发和尾延迟,不能简单说某框架固定省一半显存。"
二、核心技术对比
Q4: 三大框架的内存管理机制有什么区别?
💡 答案要点
| 框架 | 技术 | 特点 |
|---|---|---|
| vLLM | PagedAttention + prefix caching | 分块 KV 分配、统一调度、可选跨请求前缀复用 |
| SGLang | Unified Radix Cache + HiCache | 前缀树匹配;可扩展 GPU/主机/外部存储分层缓存 |
| TensorRT-LLM | Paged KV Cache + KV reuse | NVIDIA 优化内核、in-flight batching、分离式 serving |
面试话术:
"三者都在做分页、复用和调度,差异已不是‘有没有某功能’,而是缓存索引、分层存储、调度耦合、硬件覆盖和运维成熟度。"
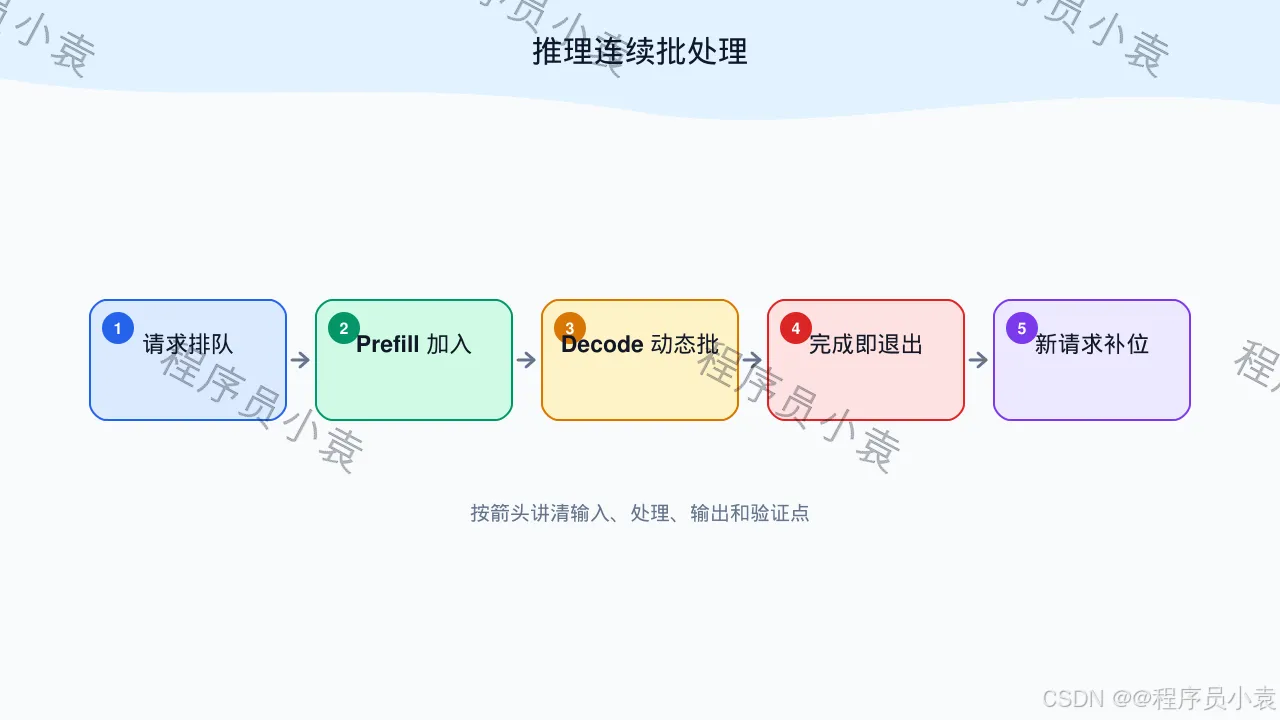
Q5: 什么是连续批处理(Continuous Batching)?
图解:推理连续批处理
💡 答案要点
连续批处理 vs 传统批处理:
传统批处理:等所有请求同时开始,同时结束
请求A: [AAAA][BBBB][CCCC][DDDD] → 需要等
请求B: [EEEE][FFFF]               → 必须等
请求C: [GGGG][HHHH][IIII][JJJJ] → 憋住

连续批处理:新请求随时加入,完成即退出
时间t1: [请求A][请求B][请求C] → 一起跑
时间t2: [请求A][请求B][新请求D] → A走了,D加入
时间t3: [请求D][新请求E][新请求F] → B走了
→ GPU利用率大幅提升
性能影响:
- 通常提高 GPU 利用率和吞吐,但也可能增加单请求排队或 TPOT
- 必须同时观察 offered load、goodput、TTFT/TPOT/P99,而不是只报 tokens/s
Q6: 三大框架的结构化输出能力有什么差异?
💡 答案要点
| 框架 | 截至 2026-10 的能力口径 | 核对点 |
|---|---|---|
| vLLM | V1 支持 structured outputs,可使用 XGrammar 等后端 | 当前版本支持的 schema 子集、reasoning parser、spec decode 组合 |
| SGLang | 支持 JSON Schema、regex、EBNF 等约束输出 | reasoning/tool parser 与约束解码兼容矩阵 |
| TensorRT-LLM | PyTorch 后端支持 guided decoding,release notes 记录了分离式模式支持 | 对应容器/版本、模型与 disaggregated mode 限制 |
面试话术:
"三者都不能再简单归类为‘支持/不支持’。我会用真实 schema 测合法率、语义正确率、停止条件、流式增量 JSON、tool/reasoning parser 和投机解码组合;语法合法不等于字段语义正确。"
三、性能基准对比
Q7: 三大框架的性能对比数据是什么样的?
💡 答案要点
没有脱离实验条件仍然真实的固定横评数字。正确 benchmark 至少固定:
- 相同模型 commit、tokenizer、chat template、精度/量化与最大长度。
- 相同 GPU 型号/数量、驱动/CUDA、TP/PP/DP/EP 拓扑、网络和功耗模式。
- 相同请求集:输入/输出长度联合分布、到达过程、共享前缀比例和采样参数。
- 相同服务语义:流式、structured output、tool parser、spec decode、prefix cache 冷/热状态。
- 先预热,再分别报告 request/s、output token/s、TTFT、TPOT/ITL、P50/P95/P99、错误率和峰值显存。
- 以 SLO 下的 goodput 与单位成功请求成本为主指标,并公开命令、配置和原始结果。
面试话术:
"我不会引用跨环境排行榜。先固定模型、硬件、流量和功能开关,再比较 SLO 下 goodput、P99 与成本;框架升级后必须重跑。"
Q8: 三大框架的量化支持有什么差异?
💡 答案要点
三者都已覆盖多种低精度/量化路线,旧的“vLLM/SGLang 不支持 FP8”已过时。不要维护一个脱离版本、模型架构和 GPU 的 ✅/❌ 大表,应按当前官方 support matrix 检查:
- 权重量化、激活量化与 KV Cache 量化是不同维度,不能只说“INT4”。
- AWQ/GPTQ/FP8/NVFP4 等格式能否加载,取决于模型架构、checkpoint、kernel 和硬件代际。
- 量化可能降低显存或带宽压力,但也可能受反量化、batch、内核覆盖影响而不加速。
- 对 reasoning、tool call、长上下文和多语言分别做质量回归,并记录量化校准集。
面试话术:
"我把量化拆成权重、激活和 KV 三层,先查当前版本的模型/硬件支持,再同条件测质量、TTFT、TPOT、吞吐和显存,不承诺固定 1.5 倍。"
四、选型与落地实践
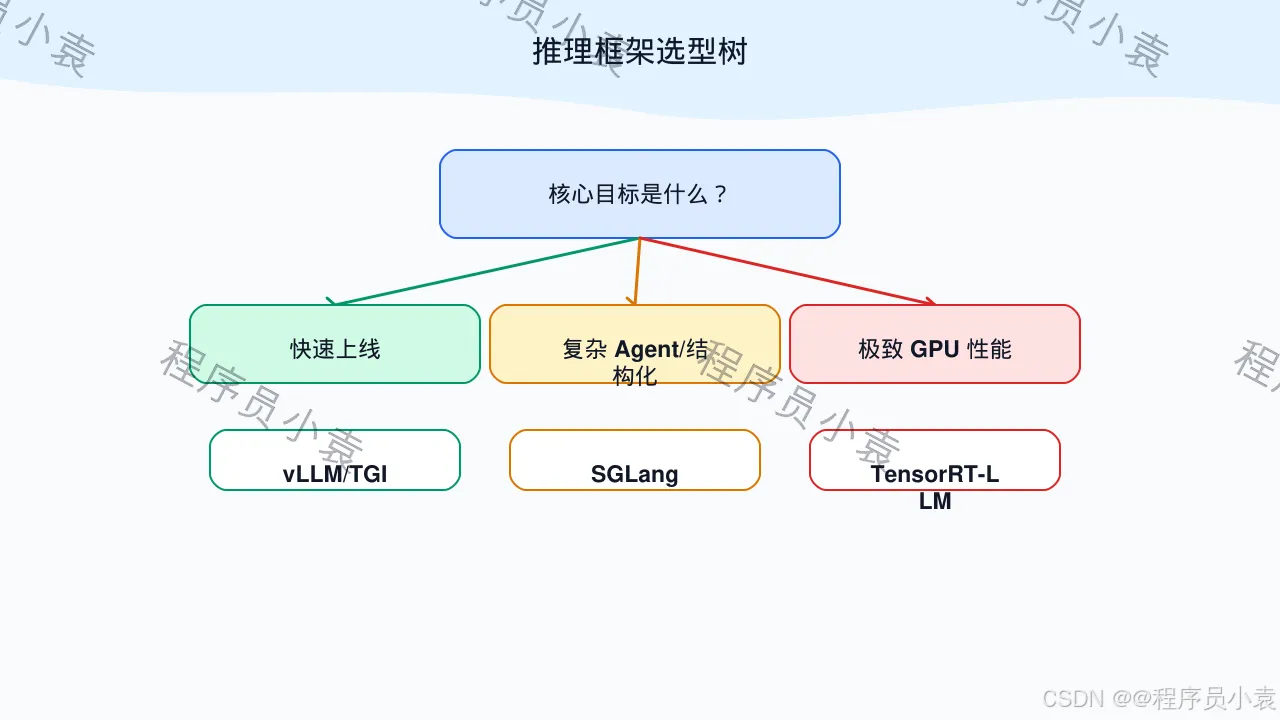
Q9: 如何根据场景选择推理框架?
图解:推理框架选型树
💡 答案要点
场景选型建议:
| 场景 | 优先进入候选集 | 原因 |
|---|---|---|
| 快速适配新模型/通用 API | vLLM | 生态与模型覆盖广,但仍需核对模型页 |
| 高共享前缀/分层 KV/PD | SGLang | Radix/HiCache 与 PD 能力突出 |
| NVIDIA 专用优化 | TensorRT-LLM | 与 NVIDIA 软件硬件栈联合演进 |
| 非 NVIDIA | vLLM/SGLang 等 | 只按当前官方 wheel/支持矩阵筛选 |
| JSON/Tool Call | 三者均需实测 | 比 parser、schema 子集和语义正确率,不按品牌下结论 |
面试话术:
"先做兼容性和正确性门槛,再在目标 SLO 下横评;POC 与生产可以是同一引擎,也可以不同,取决于回归和运维成本。"
Q10: 推理框架在生产环境有哪些常见问题?如何解决?
💡 答案要点
常见问题与解决方案:
问题1:显存溢出(OOM)
# 限制最大序列长度
vllm = LLM(max_model_len=8192, gpu_memory_utilization=0.9)
# 量化降低显存
llm = LLM(model="Qwen2.5-7B-AWQ", quantization="AWQ")
问题2:延迟不稳定
# 启用 chunked prefill
vllm = LLM(enable_chunked_prefill=True, max_num_batched_tokens=8192)
# 启用投机解码
vllm = LLM(speculative_model="Qwen2.5-0.5B")
问题3:吞吐量低
# 调整 GPU 利用率
vllm = LLM(gpu_memory_utilization=0.95)
# Tensor并行
llm = LLM(tensor_parallel_size=4)
生产环境监控指标:
| 指标 | 应如何设目标 | 说明 |
|---|---|---|
| GPU/显存/网络 | 依据容量模型与瓶颈设区间 | GPU 利用率低不一定异常,可能在等 I/O 或受低负载影响 |
| TTFT/TPOT/ITL | 按业务 SLO 与输入输出长度分桶 | 不用统一 <1s 覆盖所有 workload |
| 错误率 | 按 OOM/超时/取消/解析错误分类 | 总错误率会掩盖根因 |
| goodput/成本 | 满足质量和延迟约束下统计 | 比裸 tokens/s 更接近业务价值 |
面试话术:
"优化开关不是万能药:先按请求长度、排队、prefill/decode、通信和解析分解延迟,再一次只改一个变量,用 canary 验证收益和回归。"
五、高频面试题
Q11: PagedAttention 为什么能大幅提升吞吐量?
💡 答案要点
核心原因:解决显存碎片化问题
- 传统连续预留会产生碎片和过度预留
- PagedAttention 允许逻辑序列映射到非连续物理块并按需分配
- 节省出的 KV 容量可支撑更多并发序列;实际吞吐取决于是否仍受算力、带宽或调度限制
面试话术:
"就像内存管理从固定分区变成分页。固定分区会产生内存碎片,分页管理按需分配,内存利用率大幅提升。PagedAttention 正是这个思想在 GPU 显存管理上的应用。"
Q12: SGLang 的 RadixAttention 在什么场景下优势最大?
💡 答案要点
最佳场景:多轮对话 + 前缀复用
| 场景 | 前缀特征 | 缓存收益 |
|---|---|---|
| 客服机器人 | System prompt 相同 | 高 |
| AI 助教 | Few-shot examples 相同 | 高 |
| 代码助手 | 项目 context 相同 | 高 |
| 单轮问答 | 无前缀复用 | 无收益 |
优势最大时通常具备:长而重复的 system/few-shot 前缀、较高命中率、足够缓存容量,以及合理的租户隔离和淘汰策略。单轮随机 prompt 或频繁变动的模板收益可能很小。
面试话术:
"先测 prefix cache hit rate 和避免的 prefill tokens,再看 TTFT、显存与尾延迟;不能把单一实验的百分比外推到所有 Agent。"
Q13: TensorRT-LLM 为什么能实现极致性能?它的局限是什么?
💡 答案要点
性能潜力的来源:
- 内核融合:减少显存访问次数
- 低精度与优化 kernel:利用目标 NVIDIA 架构能力
- in-flight batching、KV reuse、并行策略、投机解码与分离式 serving
局限:
| 局限 | 说明 |
|---|---|
| 硬件绑定 | 面向 NVIDIA 生态 |
| 版本耦合 | 容器、驱动、CUDA、模型实现和 checkpoint 要匹配 |
| 预发布风险 | 1.3.0rc 系列仍需关注 breaking changes 与已知问题 |
面试话术:
"1.3.0rc23 起旧 TensorRT execution backend 已移除,不能再把‘必须先编译 TensorRT engine’当成当前通用流程。它的优势候选是 NVIDIA 联合优化,是否胜出由同条件 benchmark 决定。"
Q14: 什么是 Speculative Decoding?
💡 答案要点
投机解码:用小模型"打草稿",大模型"批改"
Draft Model(小模型0.5B):一次生成 k=4 个候选
生成: [今天][天气][很][好]

Target Model(大模型70B):并行验证这4个token
- 今天 ✓  天气 ✓  很 ✓  好 ✗

接受: [今天][天气][很] → 接受3个
继续: [不错]...

原本逐 token 解码;若接受率足够高,可用一次目标模型验证接受多个 draft token
适用条件:
- Draft 和 Target 模型相近(同系列)
- 输出有一定可预测性
面试话术:
"投机解码保持目标分布不变,但速度不保证提升;要同时测接受长度、draft 开销、batch/并发、额外显存和端到端 TPOT。"
Q15: vLLM 和 SGLang 可以一起用吗?
💡 答案要点
通常把二者视为独立 serving engine,通过统一的 OpenAI 兼容 API、网关或路由层并存,而不是默认把一个“叠加”为另一个的后端。
- 可以按模型、租户或 workload 路由到不同引擎。
- 需要统一鉴权、限流、错误语义、流式事件、parser 和可观测字段。
- vLLM 当前已经支持前缀缓存,不应再说“正在加入”。
面试话术:
"可以在同一平台并存,但一般是网关后面的两个独立引擎;先按 workload 路由,再分别容量规划和回归。"
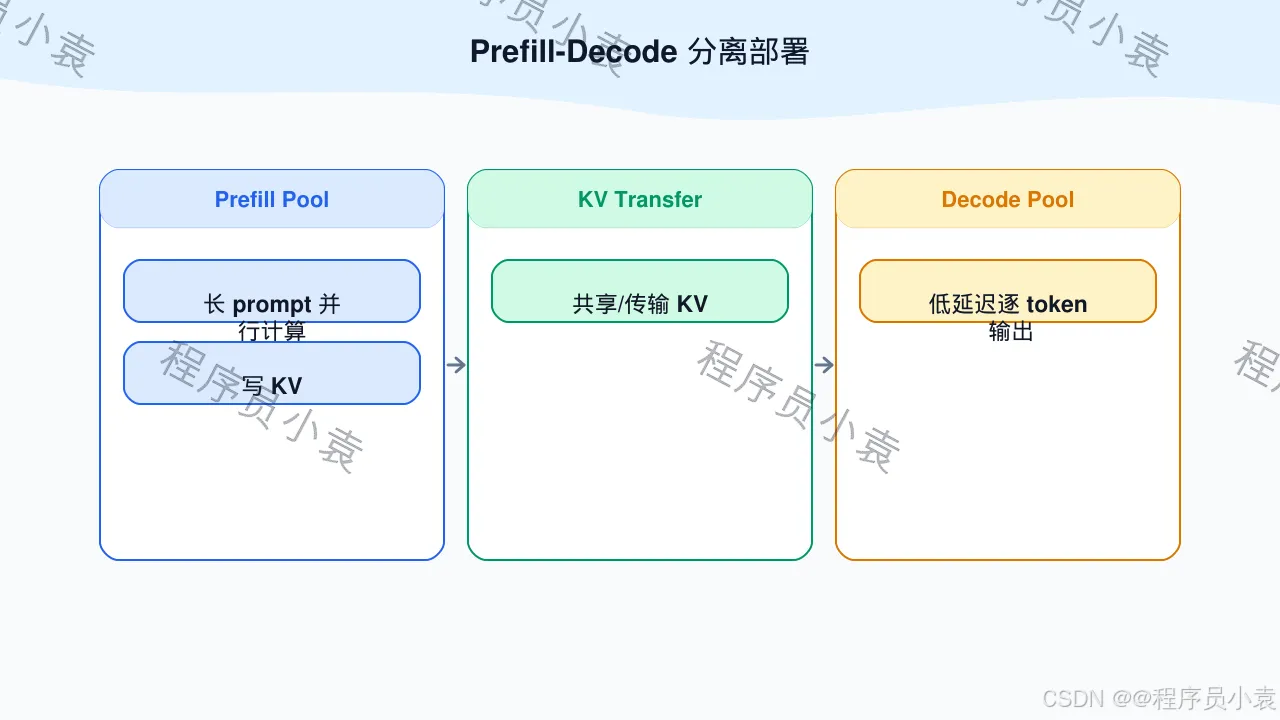
Q16: 什么是PD分离(Prefill-Decode分离)?为什么是2026年重要优化方向?
图解:Prefill-Decode 分离部署
💡 答案要点
背景问题:
- Prefill阶段:计算密集型(大量矩阵运算),需要高算力
- Decode阶段:访存密集型(带宽瓶颈),需要高带宽
- 传统方案:Prefill和Decode混在同一个GPU上,互相干扰
PD分离解决方案:
传统方案(混合部署):
GPU A: [Prefill] [Decode] [Prefill] [Decode] → 互相争抢资源

PD分离方案( disaggregation):
GPU集群A(高算力): 专门处理所有Prefill请求
GPU集群B(高带宽): 专门处理所有Decode请求
      ↓                        ↓
  KV Cache传输 ←→ 高速网络(RDMA)
收益取决于 prefill/decode 比例、KV 大小、网络带宽/拓扑、路由与排队。PD 分离主要价值是独立扩缩和隔离资源干扰;KV 传输也会新增延迟,因此短 prompt、低并发或网络不足时可能不划算。
适用场景:
- 长上下文应用(RAG、知识库)
- 高并发API服务
- 追求稳定低延迟的生产环境
实现方案:
class DisaggregatedLLM:
    def __init__(self):
        self.prefill_cluster = PrefillEngine()   # A100/H100
        self.decode_cluster = DecodeEngine()     # H100/H200
        self.kv_transfer = RDMATransfer()       # 高速KV传输

    async def generate(self, prompt, max_tokens):
        # Step 1: Prefill(算力优先)
        prefill_result = await self.prefill_cluster.forward(prompt)

        # Step 2: 传输KV Cache(RDMA,高带宽)
        kv_cache = self.kv_transfer.send(prefill_result.kv_cache)

        # Step 3: Decode(带宽优先)
        tokens = [prefill_result.last_token]
        for _ in range(max_tokens):
            decode_result = await self.decode_cluster.forward(kv_cache, tokens[-1])
            tokens.append(decode_result.token)
            kv_cache = decode_result.kv_cache

        return tokens
面试话术:
"PD分离是2026年推理优化的重要方向。核心思想是'术业有专攻':Prefill吃算力,Decode吃带宽,把它们分开部署能最大化硬件效率。DeepSeek-V3和很多国产大厂都在用PD分离。面试时能说出PD分离的原理和适用场景,说明你对推理优化有实战理解。"
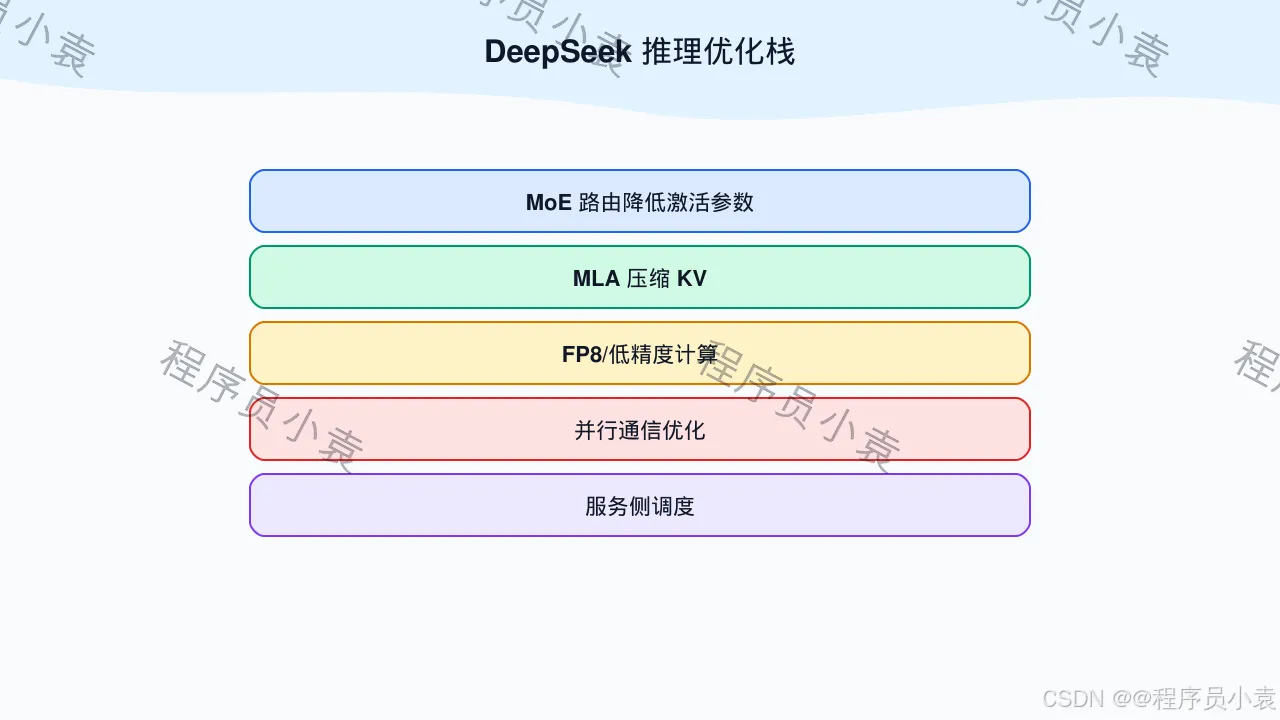
Q17: DeepSeek-V3/R1有哪些独特推理优化?为什么是2026年热点?
图解:DeepSeek 推理优化栈
💡 答案要点
DeepSeek-V3的核心技术创新:
| 技术 | 原理 | 效果 |
|---|---|---|
| MoE架构 | 混合专家,按需激活 | 激活参数仅37B,推理成本大幅降低 |
| 多头潜在注意力(MLA) | 低秩表示降低 KV 存储/带宽压力 | 实际占用取决于模型配置与引擎表示 |
| DeepSeek-R1推理强化 | 强化学习优化推理链 | 数学/代码推理能力对标o1 |
| FP8量化 | 低精度路径降低存储/带宽并利用对应硬件 | 质量与速度按硬件、内核和 workload 实测 |
DeepSeek的MLA(多头潜在注意力):
传统MHA(Multi-Head Attention):
每个token存储完整的K和V向量 → 显存占用大

MLA(Multi-head Latent Attention):
先压缩到低维潜在向量 → 解码时再恢复
→ KV Cache 体积由具体 latent 维度、RoPE 分量与引擎布局决定

代码示意:
# 传统MHA
k = W_k @ x  # [batch, seq, heads, dim]
v = W_v @ x

# MLA
z = W_down @ x          # 压缩到低维 [batch, seq, latent_dim]
k = W_k @ W_down @ x   # 解码时恢复
v = W_v @ z
为什么DeepSeek是2026年热点:
| 原因 | 说明 |
|---|---|
| 架构特征 | MLA、MoE、低精度训练/推理需要引擎专门适配 |
| 开源部署 | 权重可部署不等于目标硬件上已有高性能 kernel |
| 引擎关注点 | expert parallel、通信、KV 表示、MTP/spec decode 与 parser |
| 评估要求 | 使用当前模型卡、许可证、官方 benchmark 条件和自有任务集 |
面试话术:
"DeepSeek 类模型对推理引擎的考点是 MLA、MoE、expert parallel、通信和投机解码适配,而不是背 API 价格比例。价格和相对榜单会变化,必须引用对应日期的官方页面。"
六、2026年推理引擎最新格局
Q18: SGLang和LMDeploy在2026年有哪些新突破?如何选择?
💡 答案要点
截至 2026-10-12,值得关注的是能力演进,而不是无条件性能排行:
| 引擎 | 已核对的当前机制 | 选型时重点验证 |
|---|---|---|
SGLang v0.5.21 |
Rust 前缀缓存核心默认启用;HiCache;Mooncake/NIXL PD;prefill/decode 角色可运行时切换 | 高前缀命中、超长上下文、异构 PD、VLM/MoE 工作负载 |
vLLM v0.29.0 |
V1 + Model Runner V2;prefix caching、chunked prefill、spec decode;多硬件 wheel | 模型首日兼容、OpenAI API 行为、硬件覆盖与运维生态 |
TensorRT-LLM 1.3.0rc 系列 |
PyTorch 唯一执行后端;NVIDIA 优化内核;NIXL/UCX 分离式 serving | 指定 NVIDIA 平台上的性能、版本兼容和预发布风险 |
| LMDeploy | TurboMind 与 PyTorch engine 并存 | 目标模型/量化格式/硬件是否在官方支持矩阵;自行实测 |
不能把“量化模型必选 LMDeploy”“共享前缀必选 SGLang”写成规则。框架对量化格式、VLM、MoE、投机解码和硬件的支持更新很快,必须先过功能兼容,再做同条件 benchmark。
面试话术:
"2026 年的变化是缓存层次、PD 分离、异构并行和 VLM/MoE 支持快速演进。选型顺序是兼容性门槛、正确性回归、同条件性能、稳定性与运维成本,不按博客单点峰值排名。"
七、2026-10 官方版本与迁移事实
Q19: 截至 2026-10-12,三大框架有哪些必须知道的版本变化?
💡 答案要点
| 框架 | 官方快照与日期 | 必须知道的变化 |
|---|---|---|
| vLLM | v0.29.0,2026-09-09 |
Model Runner V2 默认覆盖全部模型;V1 统一 scheduler/KV cache manager/worker/sampler/API server;前缀缓存与 chunked prefill 已不是 SGLang 独占能力 |
| SGLang | v0.5.21,2026-10-02 |
Rust prefix-cache core 默认;PD 角色可运行时切换;HiCache 与 Mooncake/NIXL、异构 TP/DCP 持续增强 |
| TensorRT-LLM | Releases 检索日最新可见 v1.3.0rc29 |
1.3.0rc23 Release Notes 明确:旧 TensorRT backend 已移除,PyTorch 是唯一 execution backend;仍应区分 release 与 pre-release |
迁移检查清单:
- 固定镜像 tag、驱动/CUDA、模型 commit 与 tokenizer,不使用
latest。 - 阅读 breaking changes:CLI、backend、parser、量化 checkpoint 和 KV connector 都可能变化。
- 用 golden prompts 回归文本、tool call、reasoning、structured output、logprobs 与流式事件。
- 用目标流量做性能回归;发布说明里的单点提升只适用于其注明的模型、硬件和配置。
- 保留旧镜像、配置与模型工件,采用 canary/影子流量并设置回滚门槛。
面试话术:
"截至 2026-10,最容易答错的是继续背 vLLM 0.5、TensorRT-LLM 1.8 之类的固定横评。当前应讲官方 release 快照和 breaking changes,并明确版本号会过期。"
Q20: 2026年如何做可复现的推理框架横评并选型?
💡 答案要点
推荐使用两阶段横评:
阶段 A:功能与正确性门槛
- 模型/VLM、量化、LoRA、tool/reasoning parser、structured output、logprobs、长上下文是否完整支持。
- 同一 golden set 比较 greedy token 一致性、schema 合法率、工具参数正确率和任务质量;量化必须单独做质量回归。
- 覆盖取消、超时、OOM、worker 故障、滚动升级、缓存冷启动和多租户隔离。
阶段 B:SLO 下性能
固定输入:
  model commit + tokenizer + dtype/quant
  GPU/driver/CUDA + TP/PP/DP/EP + network
  prompt/output 联合分布 + arrival rate + prefix hit ratio
  相同功能开关与采样参数

逐级加压:
  找出 TTFT、TPOT、P99、错误率同时满足目标时的最大 offered load

报告:
  goodput(request/s) + output tok/s + TTFT/TPOT/ITL 分位数
  峰值显存 + 功耗/成本 + 冷热缓存结果 + 失败请求分类
选型不是按“并发用户数 > 100”这类阈值,而是:
| 问题 | 倾向 |
|---|---|
| 新模型适配和多硬件覆盖最重要? | 先验证 vLLM |
| 共享前缀/分层 KV/PD 拓扑是核心? | 先验证 SGLang |
| 已锁定 NVIDIA 平台并愿意跟随其发布栈? | 先验证 TensorRT-LLM |
| 本地/边缘/移动端? | 另评 llama.cpp、MLC LLM、Ollama/MLX 等,不与数据中心引擎混榜 |
面试话术:
"统一基准不是一张来源不明的 H100 表,而是同工件、同拓扑、同请求分布、同功能和同 SLO。最终以 goodput、尾延迟、错误率、质量和单位成功请求成本决策。"
版本: v3.0 | 更新: 2026-10-12
八、新兴推理框架补充(Ollama / XInference / TGI / llama.cpp)
Q21: Ollama 和 vLLM 有什么区别?各自适用场景是什么?
💡 答案要点
Ollama vs vLLM 核心对比:
| 维度 | Ollama | vLLM |
|---|---|---|
| 定位 | 本地模型运行平台 | 高性能推理服务引擎 |
| 使用方式 | 下载即用,无需代码 | API 服务化部署 |
| 适用人群 | 个人开发者、本地测试 | 企业级生产部署 |
| 模型支持 | 专注开源模型(Llama/Qwen等) | 所有 HuggingFace 模型 |
| 性能 | 中等(本地推理) | 极致优化(高并发) |
| 部署难度 | ⭐(5分钟上手) | ⭐⭐⭐⭐(需要配置) |
Ollama 核心优势:
# 一键运行模型,零配置
ollama run llama3.2        # 运行 Llama 3.2
ollama run qwen2.5:14b      # 运行 Qwen 2.5 14B
ollama run deepseek-r1:7b   # 运行 DeepSeek R1

# API 模式
curl http://localhost:11434/api/generate -d '{
  "model": "llama3.2",
  "prompt": "解释 Transformer 架构"
}'
选型建议:
| 场景 | 推荐 | 原因 |
|---|---|---|
| 本地开发/个人使用 | Ollama | 零配置,一键运行 |
| 快速验证 POC | Ollama | 5分钟跑起来 |
| 生产环境/高并发 | vLLM | 极致性能,支持分布式 |
| 需要 API 服务化 | vLLM | 原生 OpenAI 兼容 |
| 资源受限(Mac/Windows) | Ollama | 原生支持 Mac GPU |
面试话术:
"Ollama 偏本地模型运行与分发,vLLM 偏数据中心 serving。是否能生产使用取决于并发、HA、鉴权、审计和 SLO,不能用‘100 QPS’一刀切。"
Q22: XInference 和 vLLM 有什么区别?什么场景选 XInference?
💡 答案要点
XInference(Xorbits Inference)定位:
- 一句话定位: 统一的多模型推理平台,支持 LLM + Embedding + 重排序 + 图片生成
- 核心理念: 一个平台跑所有模型,不需要分别部署
XInference vs vLLM 对比:
| 维度 | XInference | vLLM |
|---|---|---|
| 模型类型 | LLM + Embedding + 重排序 + 图生模型 | 仅 LLM |
| 部署模式 | 统一平台,多模型管理 | 单一模型服务 |
| 多模型支持 | ✅ 原生支持 | ❌ 需要分别部署 |
| 推理优化 | 中等 | 极致 |
| 适用场景 | 多模型企业应用 | 单一模型高并发 |
XInference 典型场景:
# 一个平台启动多种模型
from xinference import LLM, Embedding

# 启动 LLM
llm = LLM("qwen2.5-14b")

# 启动 Embedding(向量化模型)
embedding = Embedding("bge-large-zh")

# 启动 Rerank(重排序模型)
rerank = Rerank("bge-reranker-large")

# RAG 场景:一套代码跑完所有模型
query_embedding = embedding.encode("用户问题")
docs = vector_db.search(query_embedding, k=20)
reranked = rerank.rerank("用户问题", docs, top_k=5)
answer = llm.generate("用户问题", context=reranked)
选型建议:
| 场景 | 推荐 | 原因 |
|---|---|---|
| RAG + Embedding + Rerank | XInference | 一个平台跑完所有模型 |
| 只需要 LLM 推理 | vLLM | 性能更极致 |
| 多模型管理平台 | XInference | 统一 API,统一管理 |
| 超高并发 LLM 服务 | vLLM | 推理优化更强 |
面试话术:
"XInference 的核心价值是'统一'——一个平台同时跑 LLM、Embedding、Rerank 模型。vLLM 只管 LLM,Embedding 和 Rerank 得另外部署。我的 SaaS 平台用 XInference,因为要给用户同时提供问答和语义搜索功能,一个平台管所有模型,运维成本低。但如果你的场景只有一个 LLM 模型需要高并发服务,vLLM 性能更强。"
Q23: HuggingFace TGI 和 vLLM 有什么关系?各自优劣是什么?
💡 答案要点
TGI(HuggingFace Text Generation Inference)定位:
- 开发方: HuggingFace 官方
- 核心理念: HuggingFace 生态的最佳推理底座
- 定位: vLLM 的主要竞争对手
TGI vs vLLM 对比:
| 维度 | TGI | vLLM |
|---|---|---|
| 开发方 | HuggingFace 官方 | UC Berkeley(非官方) |
| 生态集成 | ✅ HuggingFace 原生 | 需转换格式 |
| 量化支持 | BF16/FP16/INT8/INT4 | 更丰富(AWQ/GPTQ) |
| 多模态支持 | ✅ 原生(VLLM 支持) | ✅ 支持 |
| 吞吐量 | 高 | 极高(vLLM 略优) |
| 稳定生产时间 | 2023年 | 2023年 |
| 社区活跃度 | HuggingFace 背书 | 最活跃 |
TGI 特色功能:
# TGI 部署命令
model=meta-llama/Llama-3.1-8B-Instruct
volume=$PWD/data

docker run -d --gpus all \
  -p 8080:80 \
  -v $volume:/data \
  --shm-size 1g \
  ghcr.io/huggingface/text-generation-inference:latest \
  --model-id $model \
  --num-shard 1 \
  --quantize bitsandbytes
TGI vs vLLM 选型决策树:
已在 HuggingFace 生态?
    ├── 是 → TGI(无缝集成)
    ↓ 否
追求极致吞吐量?
    ├── 是 → vLLM
    ↓ 否
需要快速部署/文档齐全?
    ├── 是 → TGI(HuggingFace 官方背书)
    ↓ 否
需要自定义量化(AWQ/GPTQ)?
    ├── 是 → vLLM
    ↓ 否
选择 TGI
面试话术:
"TGI 是 HuggingFace 亲儿子,对自家模型支持最好,文档齐全,生态集成无缝。vLLM 是 UC Berkeley 的开源项目,社区更活跃,性能通常比 TGI 略强。我的选型是:如果模型直接来自 HuggingFace,用 TGI 更省心;如果追求极致性能或者需要自定义量化,用 vLLM。两者都支持 OpenAI 兼容 API,迁移成本不高。"
Q24: llama.cpp 是什么?它有哪些独特优势?
💡 答案要点
llama.cpp 核心定位:
- 开发方: Georgi Gerganov(非主流 AI 团队)
- 核心理念: 纯 CPU 运行大模型,极致量化,Mac/Windows 友好
- 独特价值: 让没有 GPU 的机器也能跑大模型
llama.cpp 核心创新:
| 技术 | 说明 | 效果 |
|---|---|---|
| GGUF 量化格式 | 专为本地运行设计的量化格式 | 4GB 显存跑 7B 模型 |
| 纯 CPU 推理 | 不需要 GPU | MacBook 也能跑 Llama |
| Metal 加速(Mac) | 苹果 GPU 加速 | M1/M2/M3 Mac 流畅运行 |
| 轻量级 | 单文件,无依赖 | 嵌入式/边缘部署 |
llama.cpp 的速度和内存必须按模型版本、GGUF 量化、上下文、offload 层数、CPU/GPU/Metal 后端实测,不保留跨机器固定 tok/s 表。
llama.cpp 适用场景:
| 场景 | 适用性 | 原因 |
|---|---|---|
| Mac/Windows 本地运行 | ✅ 最佳选择 | Metal/CPU 原生支持 |
| 边缘/嵌入式部署 | ✅ 候选之一 | 轻量、跨平台,但不是唯一实现 |
| CPU-only 服务器 | ✅ 可选 | 量化后可用 |
| GPU 高并发生产环境 | ❌ 不推荐 | 性能不如 vLLM/TGI |
面试话术:
"llama.cpp 的价值是 GGUF、CPU/GPU 混合卸载和广泛本地平台支持。可运行模型规模与速度取决于量化、上下文和设备内存;它也可服务化,是否用于生产由 SLO 与运维要求决定。"
Q25: 如何根据场景选择推理框架?完整的选型决策树是什么?
💡 答案要点
完整选型决策树:
第一步:你在什么环境?
    ├── 个人电脑/Mac(无 GPU)
    │   └── ✅ Ollama 或 llama.cpp
    │       (零配置,快速上手)
    │
    ├── Linux 服务器(GPU)
    │
    ↓
第二步:你的场景是什么?
    ├── 数据中心高并发服务
    │   └── ✅ vLLM / SGLang / TensorRT-LLM 同条件横评
    │
    ├── 需要多模型(LLM + Embedding + Rerank)
    │   └── ✅ XInference
    │       (统一平台,一个 API 管所有)
    │
    ├── HuggingFace 模型,快速部署
    │   └── ✅ TGI
    │       (官方支持,文档齐全)
    │
    ├── 本地开发/快速验证
    │   └── ✅ Ollama
    │       (5分钟跑起来)
    │
    └── NVIDIA 生产环境深度优化
        └── ✅ TensorRT-LLM 进入候选集并实测
实际场景选型案例:
| 场景 | 推荐框架 | 配置 | 效果 |
|---|---|---|---|
| Mac 开发 | Ollama | ollama run qwen2.5:14b | 5分钟跑起来 |
| Linux 数据中心生产 | vLLM/SGLang/TRT-LLM | 按模型与并行拓扑设计 | 以 SLO 下 goodput 实测 |
| 多模型 RAG 平台 | XInference | LLM + bge + reranker | 一个平台管所有 |
| 企业内网(无外网) | llama.cpp | Q4 量化 + CPU | 无 GPU 也能跑 |
| NVIDIA 深度优化 | TensorRT-LLM | 对应支持的 GPU 集群 | 同条件实测 |
面试话术:
"先按端侧/数据中心、硬件和模型支持缩小候选集,再按正确性、SLO、成本和运维实测;不要用 QPS 或硬件名称直接映射唯一框架。"
九、2026年七框架终极对比:oMLX/MLC LLM/LMDeploy新成员与硬件选型(Q26)
Q26: 除了vLLM/SGLang/TensorRT-LLM,2026年还有哪些推理框架值得关注?oMLX/MLC LLM/LMDeploy各适合什么场景?如何按硬件选框架?
💡 答案要点
2026年多类框架定位矩阵
框架         定位                  核心优势                      最佳硬件
─────────────────────────────────────────────────────────────────────────────
vLLM         数据中心通用服务       V1、模型生态、多硬件             以官方支持矩阵为准
TensorRT-LLM NVIDIA生产推理         PyTorch后端、NVIDIA优化内核       NVIDIA GPU
SGLang       数据中心高性能服务     Radix/HiCache、PD、程序化生成     以官方支持矩阵为准
LMDeploy     LLM/VLM部署工具箱      TurboMind/PyTorch engine         以官方支持矩阵为准
MLX/相关服务 Apple本地推理          Apple Silicon统一内存生态         Apple Silicon
Ollama       本地模型运行与分发     易用、模型打包、跨桌面平台        CPU/消费级GPU
MLC LLM      跨端编译部署           iOS/Android/WebGPU等              移动端/浏览器/边缘
Apple Silicon 本地服务
MLX 生态适合 Apple Silicon 本地推理;Ollama、llama.cpp 等也可使用。
“某工具是 Mac 唯一选择”“某配置必然流畅跑 70B”都不成立;
应按统一内存容量、量化、上下文长度、热管理和目标 tokens/s 实测。
MLC LLM:跨端方案之一
核心定位:跨端跨平台部署,iOS/Android/WebGPU
价值:把模型编译到多种端侧 runtime。
注意:它不是“唯一”移动端框架;可行模型规模、速度和能耗由设备、量化、
上下文与算子支持共同决定,医疗合规也不能由框架名称推导。
LMDeploy:模型与后端兼容性优先
LMDeploy 来自 OpenMMLab / InternLM 生态,包含 TurboMind 与 PyTorch engine。
不能把它写成“小米出品”,也不能无官方支持矩阵就声称对某国产卡“首选”。
编译时间、性能差距和量化收益都必须针对具体版本、模型和硬件验证。
按硬件缩小候选集
Apple Silicon:MLX、llama.cpp、Ollama 等本地路线。
移动/Web:MLC LLM、llama.cpp 等端侧路线。
NVIDIA 数据中心:vLLM、SGLang、TensorRT-LLM 等进入同条件横评。
AMD/Intel/其他加速器:只选当前官方 release 明确支持的组合,再做功能回归。
不要把本地 runner、端侧编译栈和数据中心 serving engine 放进一张无来源吞吐榜;比较对象与服务目标不同。
三大常见误区
误区①:"TRT-LLM一定需要旧式engine编译"
  → 1.3.0rc23起旧TensorRT execution backend已移除,PyTorch是唯一执行后端

误区②:"Ollama太简单,不适合生产"
  → 是否适合取决于SLO、并发、HA、观测、安全和运维,不由“日请求数”单独决定

误区③:"国产框架性能肯定不如国外"
  → 跨硬件性能不可直接比较;先确认官方支持,再在同硬件同负载下测
面试话术:
"硬件会缩小候选集,但不会替你完成选型。先看官方支持矩阵和功能正确性,再按目标流量比较 goodput、尾延迟、质量、能耗和运维成本;端侧 runner 与数据中心 serving engine 应分开评估。"
Q27: DFlash是什么?为什么"块扩散"是2026年投机采样新的突破方向?
💡 答案要点
DFlash 是什么?
DFlash(Block Diffusion for Flash Speculative Decoding)是 2026 年 z-lab 发布的基于块扩散模型的投机采样方法,用于加速 LLM 推理。
| 指标 | 数值 |
|---|---|
| 论文 | arXiv:2602.06036 |
| 支持框架 | vLLM(nightly)、SGLang、Transformers |
| 支持模型 | Qwen3.5、Kimi-K2.5、LLaMA3.1 等 10+ 模型 |
核心原理:块扩散 vs 传统投机采样
传统投机采样(Speculative Decoding):
小模型 → 生成 k 个候选 token → 大模型并行验证 → 接受/拒绝
问题:小模型生成的 token 质量有限,拒绝率高时效率下降
DFlash 改进思路:
用块扩散模型(Block Diffusion Model)作为 draft model
     ↓
块级生成:一次生成一个 block(多个 token)
     ↓
大模型并行验证整个 block
     ↓
接受率更高(因为扩散模型能捕捉更长依赖)
Draft model 必须与 verifier 和引擎支持矩阵匹配,不能根据名字任意混配。模型清单变化快,应以论文项目页、vLLM Speculators 文档或 SGLang 当前实现为准。
为什么值得关注:
| 优势 | 说明 |
|---|---|
| 更高接受率 | 块扩散能捕捉更长依赖关系,draft 质量更高 |
| 端到端加速 | 与 vLLM/SGLang 原生集成,一行命令启用 |
| 多模型支持 | 开源 10+ 预训练 draft 模型,覆盖主流 LLM |
| 支持代码场景 | Qwen3-Coder-Next-DFlash 专门针对代码生成优化 |
vLLM 使用示例:
验证顺序:
1. 从当前引擎文档确认 verifier ↔ speculator 配对和安装版本。
2. 记录平均接受长度、draft latency、额外显存和端到端 TPOT。
3. 分别测试同步低并发与服务高并发;论文峰值不能直接外推。
4. 回归 grammar、logprobs、VLM、page size 等当前限制。
面试话术:
"DFlash 用扩散 draft model 单次并行提出一个 token block,再由 target 无损验证。论文和框架文档已给出实现,但收益依赖 draft/target、接受率、并发和硬件;SGLang 对应实现仍列出 grammar、logprobs、page size 等限制,不能直接写成‘所有生产环境可用’。"