
云上健康检查是标配,内网穿透隧道的"最后一跳"谁在盯?
一、一个有意思的对比
在云上,健康检查几乎是标配:负载均衡会定期探测后端 ECS 是否存活,容器服务会通过探针判断 Pod 是否 Ready,网关有主动健康检查……这些机制保证了"流量不往挂掉的节点打"。
但很多团队用内网穿透把 OA、API、服务器映射到公网后,恰恰漏了这一层:隧道建好、测试通过,之后应用"活没活着"就没人管了,只能等用户报障。云上处处有健康检查,到了内网穿透的"最后一跳",反而回到了"靠人肉发现故障"的原始状态。
二、为什么隧道也需要健康检查
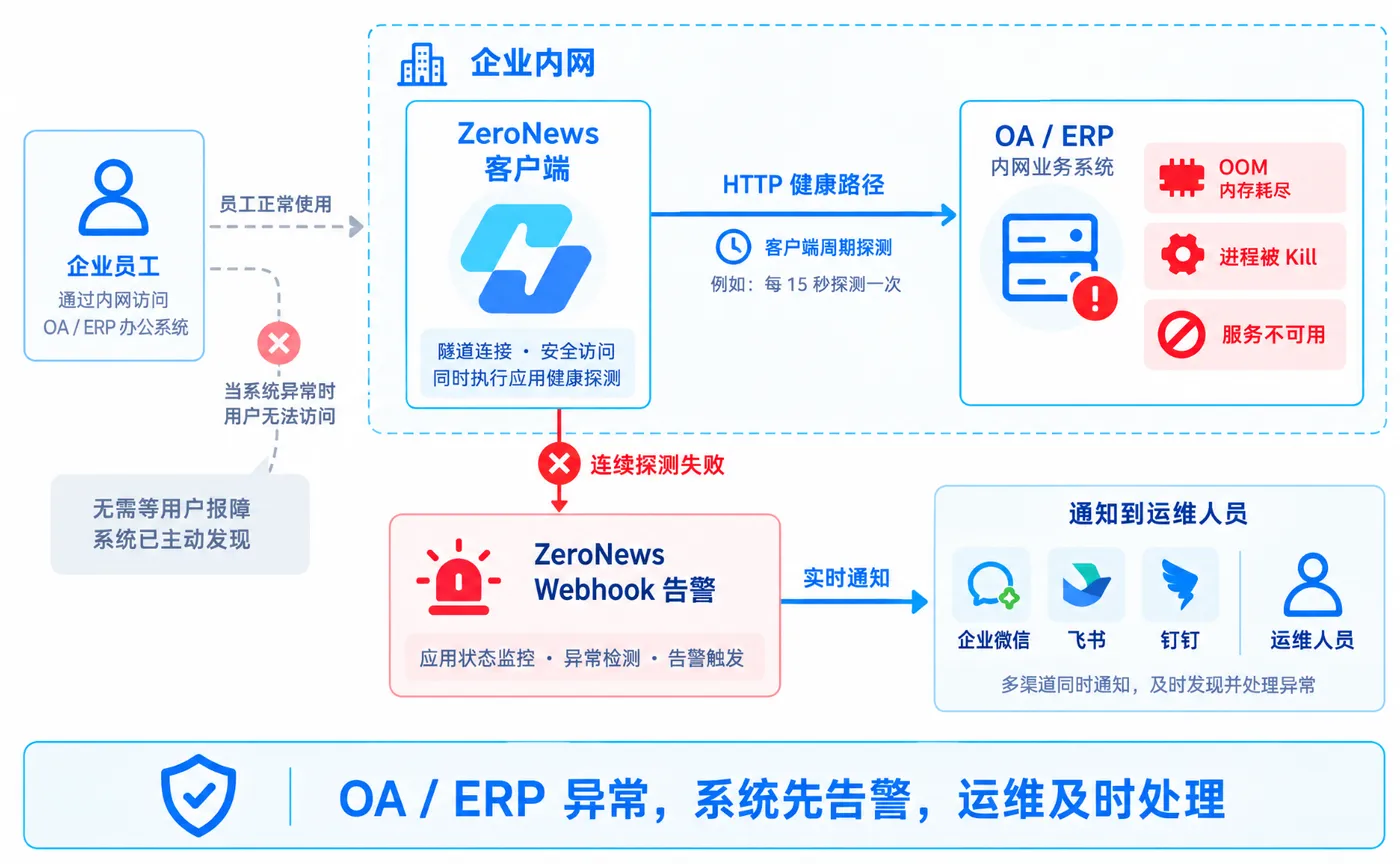
内网穿透解决的是"可达性",不解决"可用性":隧道在线,只说明链路通;后端应用是正常、还是已经挂了几小时,公网侧一概看不到。容器 OOM 被 Kill、进程退出、端口停止监听,这些在隧道侧都无感。
结果就是故障发现完全被动——员工打不开 OA 了、合作方调接口超时了、服务器连不上了,才有人通知运维。业务影响时间被显著拉长。
三、隧道应用探测的实现思路
给隧道补上健康检查,思路与云上一致,但要解决"最后一跳"的特殊性:
- 谁探测:由运行在内网的客户端发起,请求走内网/本机回环转发给应用——不依赖公网访问流量,应用没访问量时状态也在被持续监控;
- 探什么:HTTPS/HTTP 隧道探测健康 URL(如 /health),TCP 隧道探测端口连通(如 SSH 22 端口);
- 怎么判定:以固定周期(如 15 秒)持续探测,连续多个周期无响应才判定异常,避免单次抖动误报;
- 怎么通知:判定异常后经 Webhook 推送到企微/飞书/钉钉,与值班响应链路打通。
关键设计是探测路径贴近真实转发路径:探测请求走的就是真实流量的路径,端口配错、进程未启动这类问题,比真实用户访问更容易提前暴露。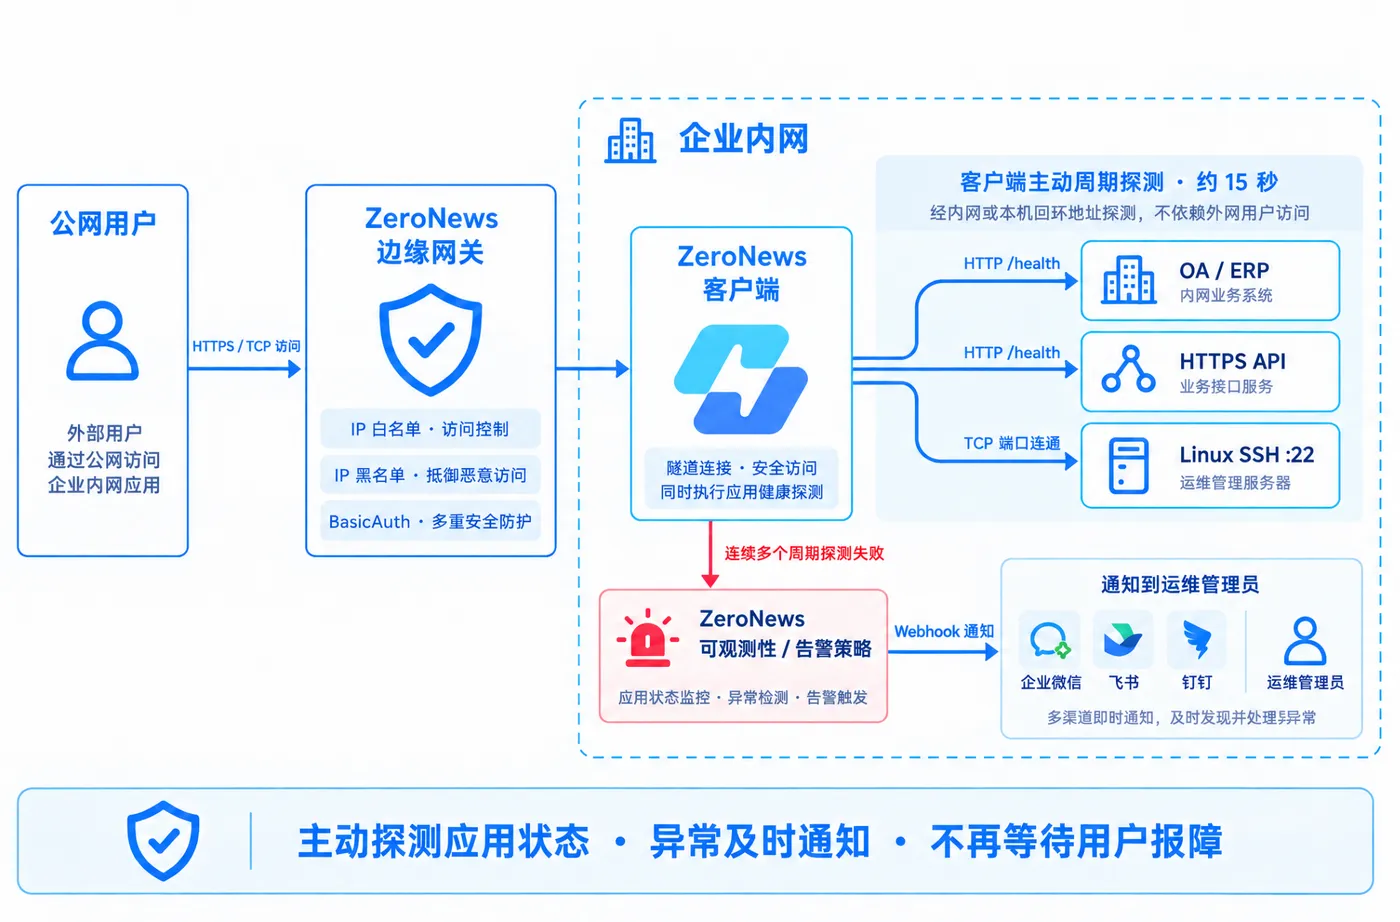
四、与云上健康检查的关系:互补,不重复
- 云上健康检查(SLB、容器探针)负责"流量调度层"的可用性,保证请求不发给不健康的节点;
- 隧道应用探测负责"内网最后一跳"的可观测性,保证运维能第一时间知道内网应用异常。
两者互补:前者管"流量怎么走",后者管"故障怎么知道"。对于部署在云服务器上的内网穿透网关,建议两者都配。
五、典型场景
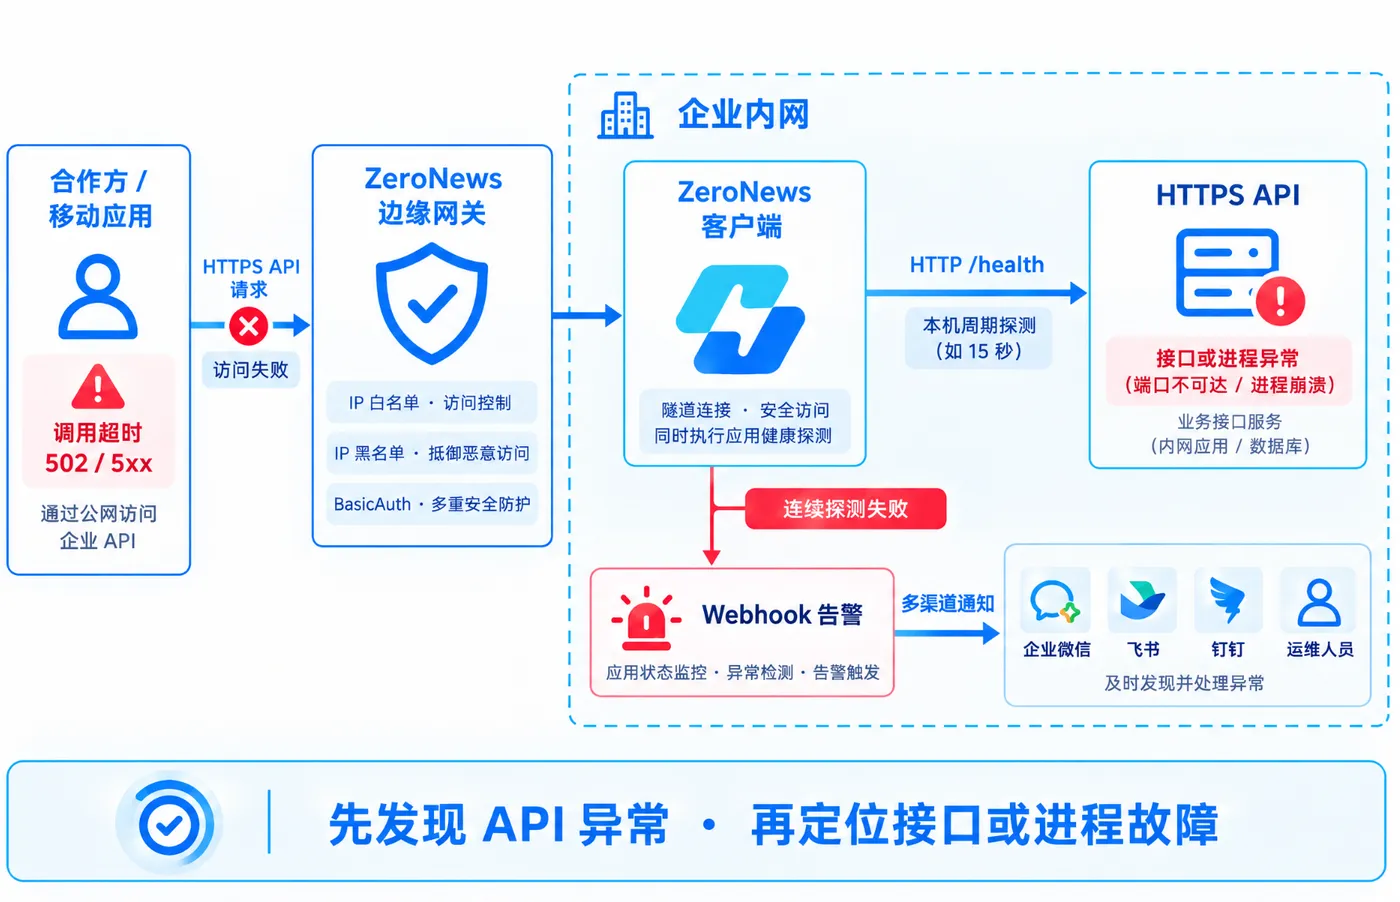
对外 API:健康路径探测异常即告警,直接把定位方向指向"服务异常",缩短排查链路;
容器化的业务系统:内存配额不足、OOM 被 Kill 时,探测在业务侧大面积反馈前触发告警;
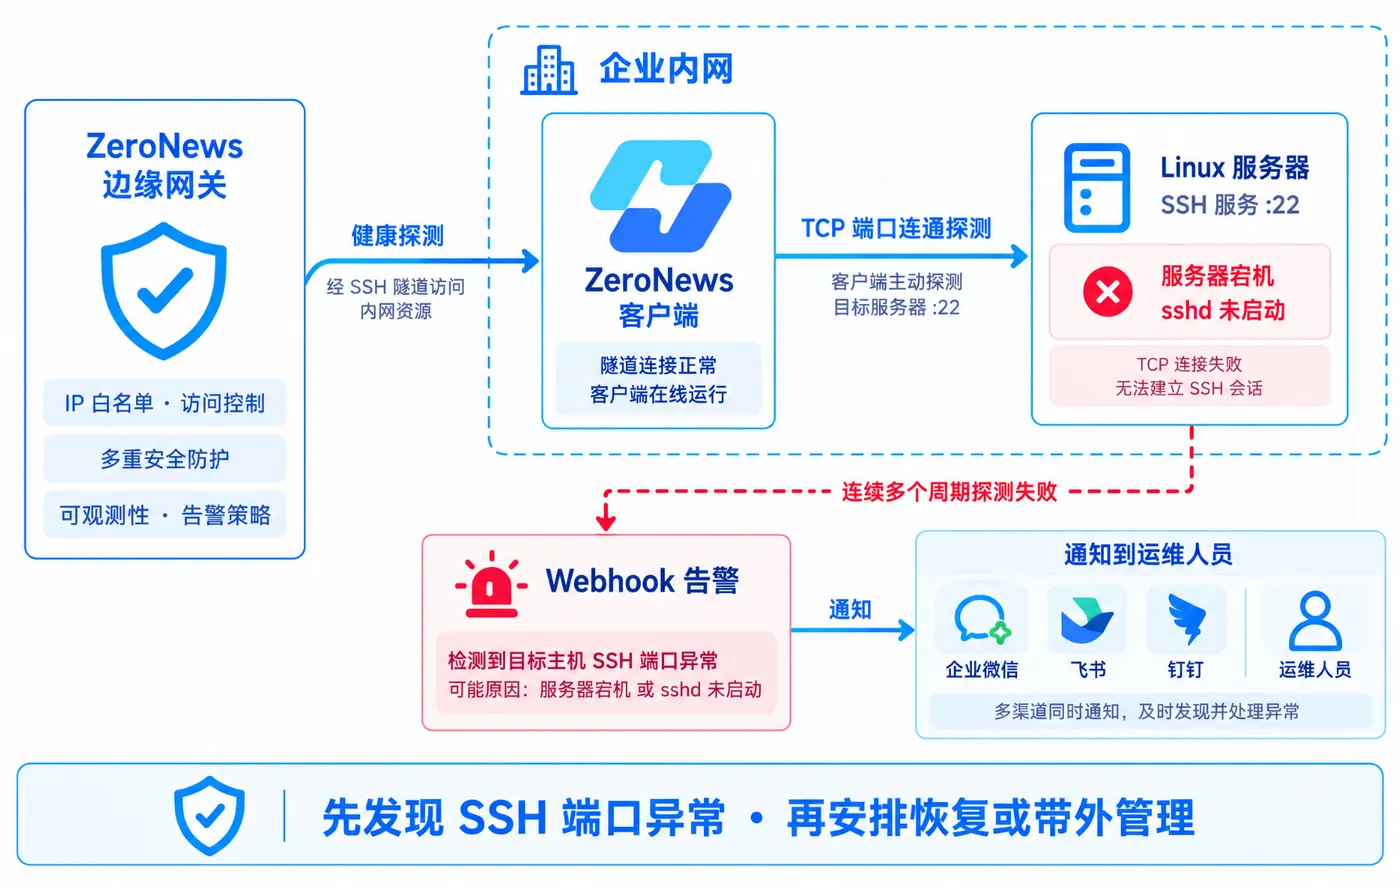
SSH 远程运维:服务器宕机、sshd 未启动、磁盘打满时,端口探测失败即告警,避免"所有人连不上才发现"。
六、落地建议
为关键业务隧道开启应用探测,探测地址用真实的健康检查路径(/health、/readyz),避免用首页路径代替;
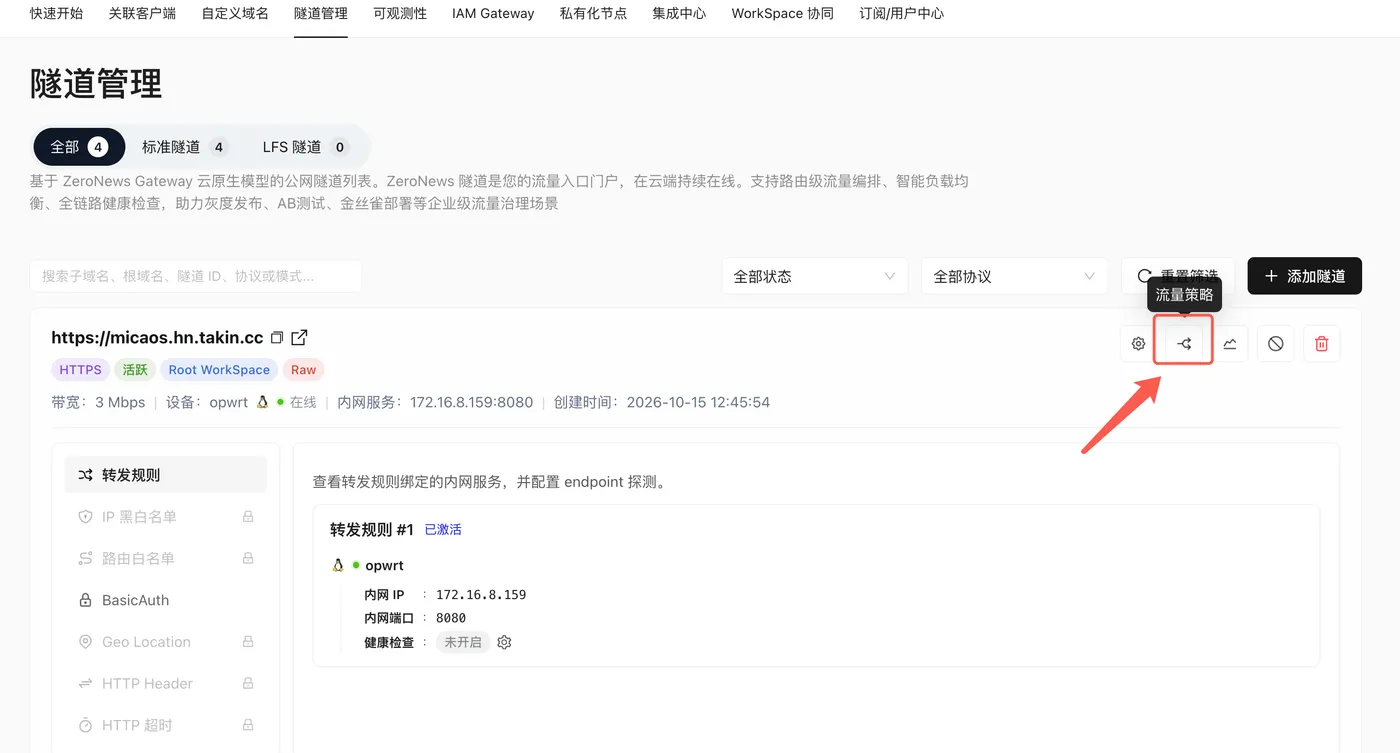
告警对象配置到值班群,与云监控告警(如 ECS 状态、云监控指标)放同一套通知链路,统一收口;
- 上线前做一次故障演练:手动停止服务,确认告警能正常到达;
- 与入口访问控制(IP 黑白名单)、应用认证组合使用——探测解决"从哪发现故障",黑白名单解决"谁能访问",认证解决"你是谁",三层各司其职。
