
谈到 Text2SQL,行业目光总容易投向大模型:参数够不够大、写 SQL 的语法准不准、演示场景够不够惊艳。但真正落地到业务场景就会发现:SQL 语法早就不是瓶颈,业务语义才是真正的门槛。
纯大模型方案之所以一到复杂业务就翻车,本质上缺的不是写 SQL 的能力,而是一套足够厚重、足够精细的语义层。Text2SQL 的长期竞争力,最终比拼的是语义层的复杂度,而不是模型的聪明程度。
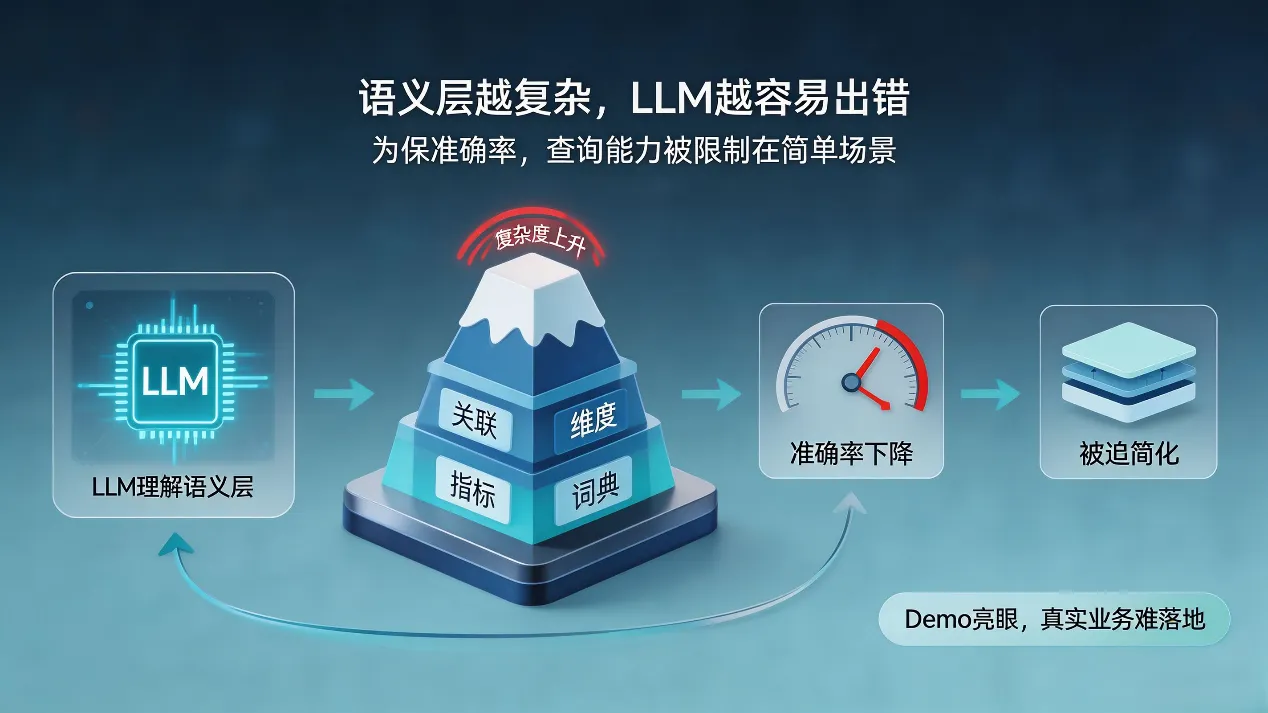
为什么市面上绝大多数方案的语义层都做不复杂?因为 LLM 生成 SQL 的路线需要 “理解” 语义层的全部定义,语义层越复杂、关联维度越多,LLM 的误判概率就越高。为了保住准确率,不得不主动简化语义层。有时甚至简化到只支持单表查询,多表关联、子查询、主子表等复杂场景一概不支持。
这就形成了死循环:语义层越简单,能支持的查询场景越少;场景越少,企业越用不上;用不上,就越不敢投入把语义层做复杂。最终结果就是:Demo 跑得很好,一到真实业务就废了。
Text2SQL 的真正难点,是业务语义
很多人对 Text2SQL 的理解停留在 “把自然语言翻译成 SQL 语法”。可 SQL 语法本身就那点规则,大模型早已熟练掌握。真正难的,从来都不是语法,而是语义。
同样一句 “上个月华北区销量”:
“销量” 按订单金额算还是按产品数量算?含不含退款?
“华北区” 是按客户所在地划分,还是按发货城市划分?
“上个月” 是自然月还是财月?口径和财务系统对不对得上?
数据散在订单表、订单明细表、客户表三张表里,该怎么关联、按什么维度汇总?
这些问题没有标准答案,每个企业的业务口径都不一样。没有语义层的大模型,只能靠训练数据里见过的表结构去猜,见过就对,没见过就错;换个问法,可能又错。数据治理越不规范、业务逻辑越复杂,翻车概率越高。
真正的语义层,远不止给字段起中文名
润乾 NLQ 的核心竞争力,恰恰在于这套完整厚重的语义层架构。远不止给表和字段起个中文名,而是一整套结构化的业务语义体系,包含四大核心支柱,每一层的复杂度,都直接决定了 Text2SQL 的真实能力边界。
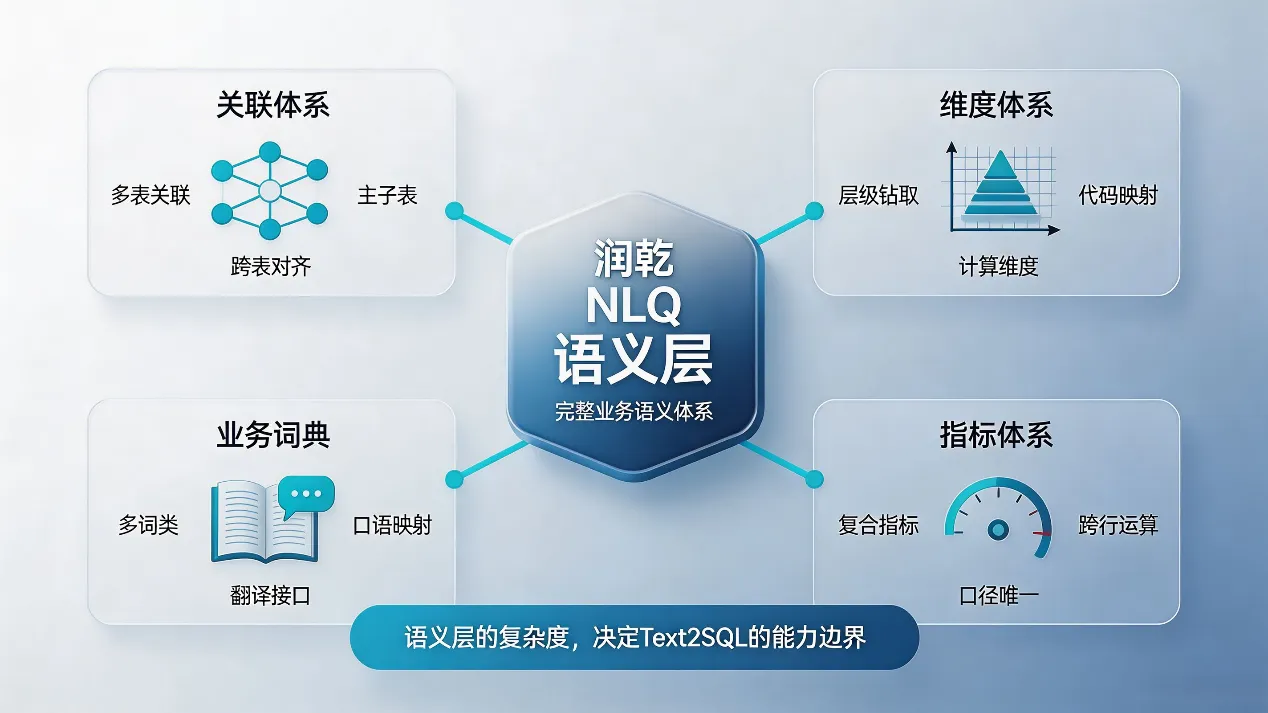
- 关联体系:语义层的骨架
关联能力是语义层最基础的能力,也是纯 LLM 最容易翻车的重灾区。关联体系远不止主键外键配对,它包含主子表关系、多级关联链路、同维度跨表自动对齐,甚至跨事实表的维度对齐。订单、回款、支付三张独立事实表,只要同属 “年” 维度,语义层就能自动按维度对齐关联,用户无需写任何 JOIN 条件。这也是 DQL 语义层能轻松处理复杂多表查询,而大模型一遇 JOIN 就容易出错的根本原因。
- 维度体系:语义层的坐标系
维度是分析的坐标系,但维度体系远不止 “地区”“日期” 这些字段本身。它包含维度的层级结构(年 - 季 - 月 - 日、省 - 市 - 区),支持上钻下取;包含代码与名称的映射关系,让编码自动转成业务可读的名称;还包含计算维度,比如按年龄分段、按客户价值分层。NLQ 的维度体系越精细,能支持的切片、分组、钻取就越灵活,用户提问的自由度就越高。
- 指标体系:语义层的价值核心
指标是业务的语言,也是语义层最有价值的部分。基础的求和、计数只是入门,真正复杂的指标体系,包含复合指标的计算口径、聚合前后的过滤逻辑、跨行运算指标(同比、环比、累积、占比、排名),以及业务专属的复杂计算指标。在 NLQ 语义层中,每个指标都有明确业务定义,一次配置永久生效,不会出现同一个词两种口径,查询深度远不止返回明细数据。
- 业务词典:语义层的翻译接口
业务人员不会按表名字段名提问,把日常口语映射到结构化语义对象上,靠的就是 NLQ 词典。它不只是同义词对照,还包含实体词、字段词、聚合词、比较词、宏词、字段簇、动词、常数词等多种类型。词典越贴合企业用语习惯,口语化查询的通过率就越高,它是自然语言和结构化语义之间的翻译器,也是语义层面向用户的接口。
语义层的复杂度,决定了 Text2SQL 的上限
为什么说语义层的复杂度才是制胜点?因为它从三个维度上,决定了一套 Text2SQL 方案的真实能力。
第一,决定了查询能力的边界。 单表过滤是入门级,多表关联是进阶级,跨事实表多维对齐、复杂指标计算才是真正的企业级场景。语义层能描述多复杂的业务逻辑,就能支持多复杂的查询。没有厚语义层支撑,大模型只能在简单单表场景里表现亮眼,一到真实的多表业务、一到复杂指标计算就失灵。
第二,决定了结果的确定性。 纯大模型方案是概率生成,这次对了不代表下次也对,换个说法可能就错。语义层是规则驱动,每个关联、每个维度、每个指标都有明确定义,一旦配置验证正确,永久正确。SQL 的编译过程是 100% 确定性的,不会因为提问方式不同就跑出不同的结果。对严肃业务场景来说,确定性比 “大概率正确” 重要得多。
第三,决定了落地的可行性。 数据治理不完善的企业,恰恰可以通过建设语义层来逐步梳理业务口径。建设语义层的过程,本身就是业务语义标准化的过程。不用等全公司数据治理完再上线,从几个核心表、几个高频指标开始,配置一个、验证一个、上线一个,边用边建、逐步迭代。语义层越用越厚,系统越用越准。
Text2SQL 的竞争,现在已经是语义层的竞争。
比模型参数、比演示效果、比单表准确率,都是表层的热闹。真正落到企业里用,拼的是谁的语义层更厚、更全、更贴合业务,谁能把关联、维度、指标、术语这些业务底层逻辑做深做透。
毕竟用户要的从来不是 “AI 写的 SQL 语法对不对”,而是 “查出来的数对不对、符不符合业务口径”。而这件事,最终只能靠足够复杂、足够严谨的语义层来保证,这正是润乾 NLQ 在走的路。
