0 前言
只要上下文窗口足够大,就可以把可能用到的所有内容——工具、文档、指令等——统统放进提示词里,剩下的工作交给模型处理就行了。
长上下文一度:
- 削弱了人们对RAG热情(既然可以把所有内容都放进提示词,又何必费心寻找最合适的文档?)
- 推动 MCP 的热潮(只要连接所有工具,模型就能胜任任何任务!)
- 进一步激发对智能体的期待
但上下文越长,并不意味着回答质量越高。上下文中塞入过多信息,可能会以一些意想不到的方式导致智能体和应用程序失效。上下文可能受到错误信息的污染,也可能让模型分心、产生混淆,甚至出现相互矛盾的内容。这对智能体尤其不利,因为智能体需要依靠上下文收集信息、整合发现,并协调执行各种操作。来看如下各种上下文失效情况:
1 上下文污染
幻觉或其他错误信息进入上下文,并在后续处理中被反复引用。
这个问题尤其严重的一种表现形式是“上下文污染”:上下文中的多个部分,例如目标和摘要,都被错误的游戏状态信息所污染。这类问题往往需要很长时间才能纠正。因此,模型可能会执着于实现不可能完成或与当前任务无关的目标。
如果上下文中的“目标”部分受到污染,智能体就可能制定毫无道理的策略,并不断重复某些行为,只为追求一个根本无法实现的目标。
2 上下文干扰
上下文变得过长,导致模型过度关注上下文内容,反而忽略了训练过程中学到的知识。
在智能体执行任务的过程中,随着模型不断收集信息、积累历史记录,上下文会越来越长。但这些累积的信息不一定总能提供帮助,有时反而会干扰模型。Gemini 智能体玩《宝可梦》的案例就清楚地展示了这一问题:
当上下文长度大幅超过 10 万个 Token 时,模型开始倾向于重复庞大历史记录中的既有操作,而不是综合信息、制定新的计划。虽然这一现象只是观察性证据,但它揭示了一个重要区别:利用长上下文进行信息检索,与利用长上下文进行多步骤生成式推理,是两种不同的能力。
模型没有利用训练中学到的知识制定新策略,反而执着于重复上下文历史中已经出现过的操作。
对于较小的模型,这种干扰出现得更早。Databricks 的研究发现,Llama 3.1 405B 的回答正确率在上下文长度达到约 32K Token 时就开始下降,而更小的模型往往更早受到影响。
既然模型在上下文窗口还没填满之前就可能开始表现异常,那么超大上下文窗口究竟有什么用?简单来说,它最适合用于信息摘要3和事实检索。如果你的任务不涉及这两类工作,就需要留意所选模型能够承受的上下文干扰程度。
3 上下文混淆
模型利用上下文中多余的信息生成质量较差的回答。
曾经有那么一段时间,似乎所有人都准备推出自己的 MCP。当时,人们相信,只要让强大的模型连接所有服务和工具,就能轻松处理各种日常琐事。这个愿景看起来触手可及:只需把所有工具的描述都放进提示词,然后启动模型即可。Claude 的系统提示词也让人看到了这种做法的可能性,因为其中大部分内容都是工具定义或工具使用说明。
但即使MCP 的整合趋势和市场竞争不会让其发展放缓,上下文混淆也可能成为制约因素。事实证明,工具并不是越多越好。
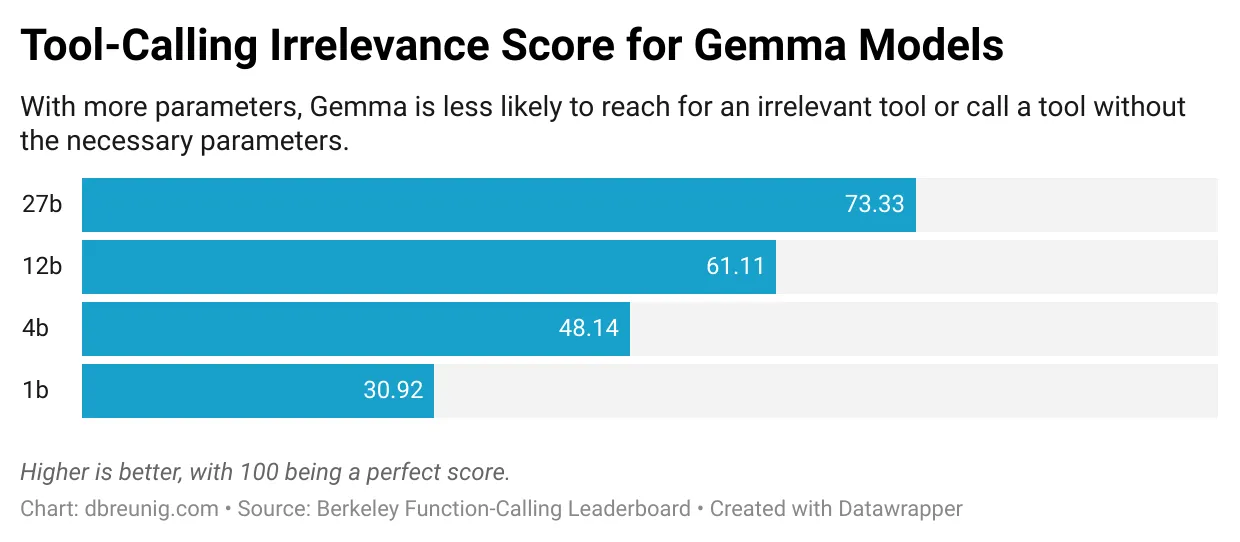
伯克利函数调用排行榜(Berkeley Function-Calling Leaderboard)是一项用于评估模型工具调用能力的基准测试,主要考察模型能否有效使用工具来响应提示词。该排行榜目前已发展到第三个版本,结果显示,当提供的工具数量超过一个时,所有受测模型的表现都会变差4。此外,伯克利团队还设计了一些场景,其中提供的所有函数都与任务无关,预期模型不应该调用任何函数。然而,所有模型都偶尔会调用与任务无关的工具。
浏览函数调用排行榜的数据还可以发现,模型越小,这个问题通常就越严重:
最近的一篇研究论文提供了一个很有代表性的案例。该研究评估了小型模型在 GeoEngine 基准测试中的表现。这个测试包含 46 种不同的工具。研究团队向经过量化压缩的 Llama 3.1 8B 提供了全部 46 种工具及一个查询。尽管这些内容完全没有超出模型 16K Token 的上下文窗口限制,模型仍然未能完成任务。但当工具数量减少到 19 个时,模型却成功了。
问题在于:只要把某些内容放进上下文,模型就可能不得不分配注意力去处理它。 这些内容可能是无关信息,也可能是不必要的工具定义,但模型仍然可能受到它们的影响。大型模型,尤其是推理模型,正在逐渐提高忽略或舍弃多余上下文信息的能力,但无用的信息仍然可能导致智能体出错。更长的上下文确实让我们能够塞入更多信息,但这种能力也伴随着相应的代价。
4 上下文冲突
随上下文不断累积,新增的信息和工具与已有信息发生矛盾。
这是比上下文混淆更严重的问题:这里的问题不只是上下文中的信息无关紧要,而是不同信息之间存在直接冲突。
微软和 Salesforce 的一个研究团队在最近的一篇论文中,出色地记录了这一现象。研究团队从多个基准测试中选取提示词,并将其中的信息拆分到多个提示词中,分阶段提供给模型。可以这样理解:有时,你会在向 ChatGPT 或 Claude 提问之前,先花时间输入好几段文字,把所有必要的细节一次性说明;另一些时候,你可能先提出一个简单的问题,等聊天机器人的回答不够理想时,再逐步补充细节。微软和 Salesforce 团队对基准测试中的提示词进行了改造,让它们变成类似后一种情况的多轮对话:
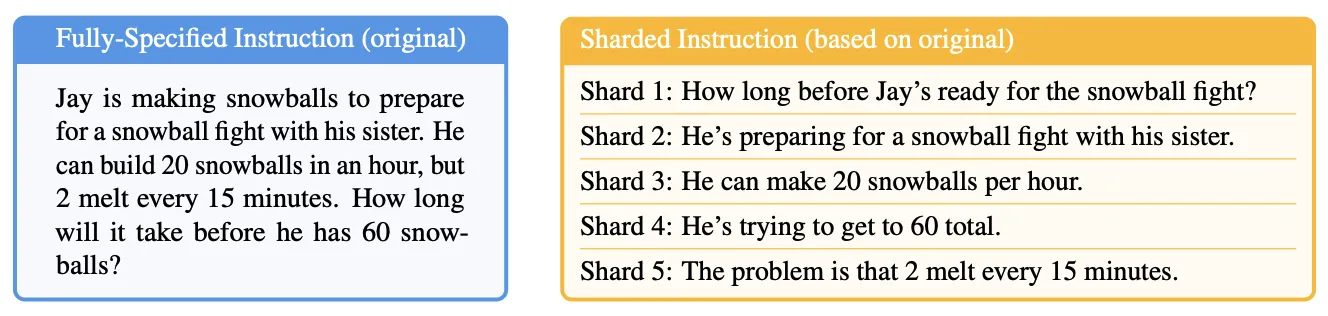
左侧提示词中的所有信息,都被包含在右侧的多条消息中,只不过右侧的内容需要通过多轮聊天逐步输入。
实验结果显示,将提示词拆分成多轮对话后,模型的表现明显变差,平均得分下降了 39%。研究团队测试了多种模型,其中备受关注的 OpenAI o3,得分也从 98.1 降至 64.1。
为什么分阶段收集信息,会比一次性提供全部信息更容易导致模型表现下降?
仍与上下文混淆有关:当模型将整段聊天记录整合为上下文时,其中会包含模型在尚未获得全部信息之前,对任务作出的早期尝试和回答。这些可能并不正确的回答会一直留在上下文中,并在模型生成最终答案时继续产生影响。研究团队这样写道:
大语言模型经常会在对话的早期轮次作出假设,并过早尝试生成最终解决方案,而后续又会过度依赖这些早期结果。简单来说,当大语言模型在对话中走错方向时,往往会迷失其中,难以自行纠正。
这对智能体开发者来说并不是一个好消息。智能体需要从文档、工具调用结果,以及其他负责处理子任务的模型那里收集信息,并将这些信息整合为上下文。但这些来自不同来源的内容,彼此之间可能存在矛盾。此外,当你连接自己并未开发的 MCP 工具时,这些工具的描述和使用说明也更有可能与提示词中的其他内容发生冲突。
百万 Token 级别上下文窗口的出现,曾让人们觉得这将带来一场变革。只要把智能体可能用到的所有内容都放进提示词,就有机会打造出近乎全能的智能助手:它们可以访问任何文档、连接所有工具,还能拥有完美的记忆能力。
然而,正如我们所看到的,更大的上下文也带来了新的失效模式。上下文污染会让错误不断累积;上下文干扰会让智能体过度依赖历史记录,不断重复过去的操作,而不是继续探索新的解决方案;上下文混淆会导致模型使用无关的工具或文档;上下文冲突则会制造内部矛盾,破坏模型的推理过程。
这些问题对智能体的影响尤其严重,因为智能体的工作方式恰好会导致上下文不断膨胀:它们需要从多个来源收集信息、连续调用工具、进行多轮推理,并积累大量历史记录。
这些问题是有办法解决的!如动态加载工具,以及建立上下文隔离区,从而更好地控制上下文信息。