
选中转站,我会看一周里真正完成了哪些工作
一次顺利的演示,会让人愿意继续尝试;真正准备长期使用时,我更想知道普通的一周能完成多少工作。周一读项目,周三整理资料,周五修一个小问题,这些任务没有统一格式,却更接近日常需求。入口是否适合自己,也应该放在这种连续使用里判断。
不必为了记录,再增加一项重工作
我会准备一份很短的使用笔记,每个任务只记目的、模型标识、结果、人工补充和实际费用。能直接使用、需要少量修改、需要重做、尚未完成,分别标记。没有准确测量的数据就不填,不为了表格整齐给出估算值。
这份笔记不追求覆盖所有能力,也不需要每天跑同一道测试。它更像工作记录:今天原本要做什么,模型帮到了哪一步,剩下什么由自己完成。这样一周结束以后,可以看出入口是否进入了真正的工作流程。
不同任务分开看,别急着算一个总分
项目阅读重点是引用准确和路线清楚;中文整理重点是保留事实;代码修改重点是边界与验证;数据处理重点是原始含义和异常项。把这些结果都塞进同一个分数,可能掩盖真正影响自己的问题。
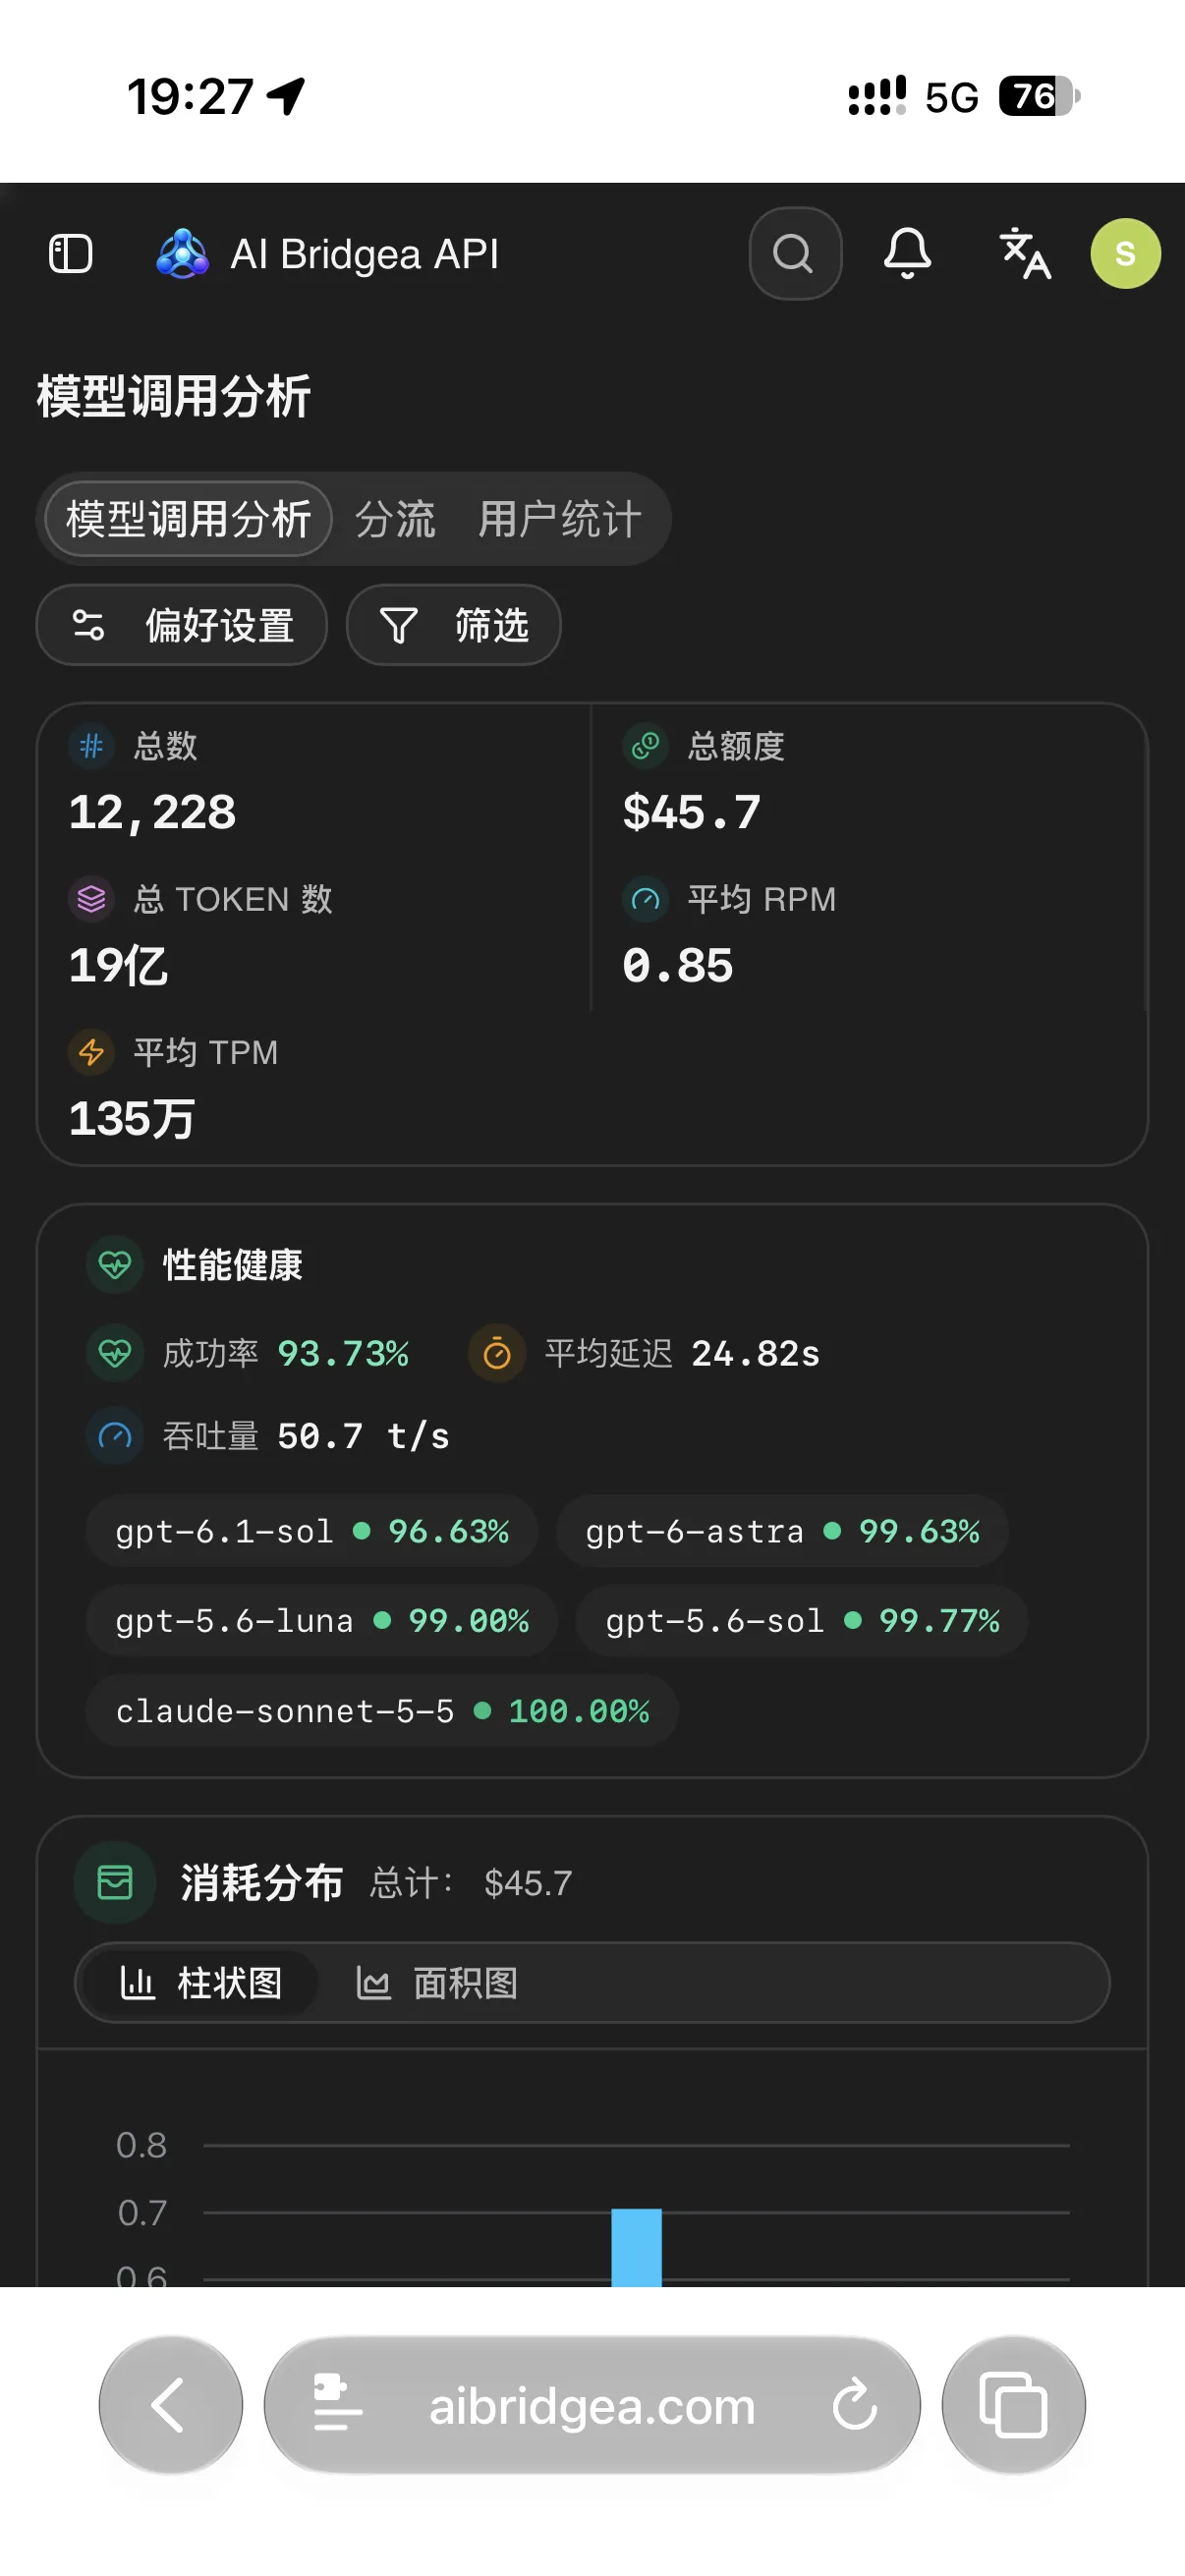
如果 gpt-6-astra 和 gpt-6.1-sol 都是可用候选,我会记录各自用于什么任务、使用了哪些配置。任务类型不同,就先不做谁更强的结论。需要比较时,再挑同类材料做对照,避免把工作难度差异误写成模型差异。
看“需要帮忙的次数”,也看帮忙有没有价值
有些任务需要人工补充资料,这很正常。值得关注的是,模型是否指出了真正缺失的信息,以及补充以后有没有推进。反复问同一个已回答的问题,和主动发现一个未明确的关键条件,不能简单计为一样的沟通次数。
使用 Codex 时,我会把实际修改和检查结果留在笔记旁边。对于阅读或文案任务,也保存输入版本与输出。以后发现体验变化,可以抽出同类材料复查,而不是只凭记忆说“上周好像更聪明”。
一周以后,给出有限但有用的决定
我会问自己三个问题:哪些任务愿意继续使用,哪些只适合辅助,哪些暂时不交给模型?答案可以很具体,例如“项目梳理可以继续,小改动需要检查,复杂业务判断还要补资料”。不必把使用记录扩展成对所有人的推荐。
“不降智”对我而言,是不同日期、不同普通任务里,理解和约束能够保持在可接受范围。短期记录只能反映那段时间和那批任务,无法变成永久保证,但它比一次展示更容易帮助自己调整工作安排。
把 aibridgea点com 放进候选名单,我会从这样的一周开始:控制测试范围,保存必要证据,最后根据实际完成的事情决定后续使用。选入口最终是为了让工作更顺,而不是让模型列表、截图和宣传词替自己做判断。
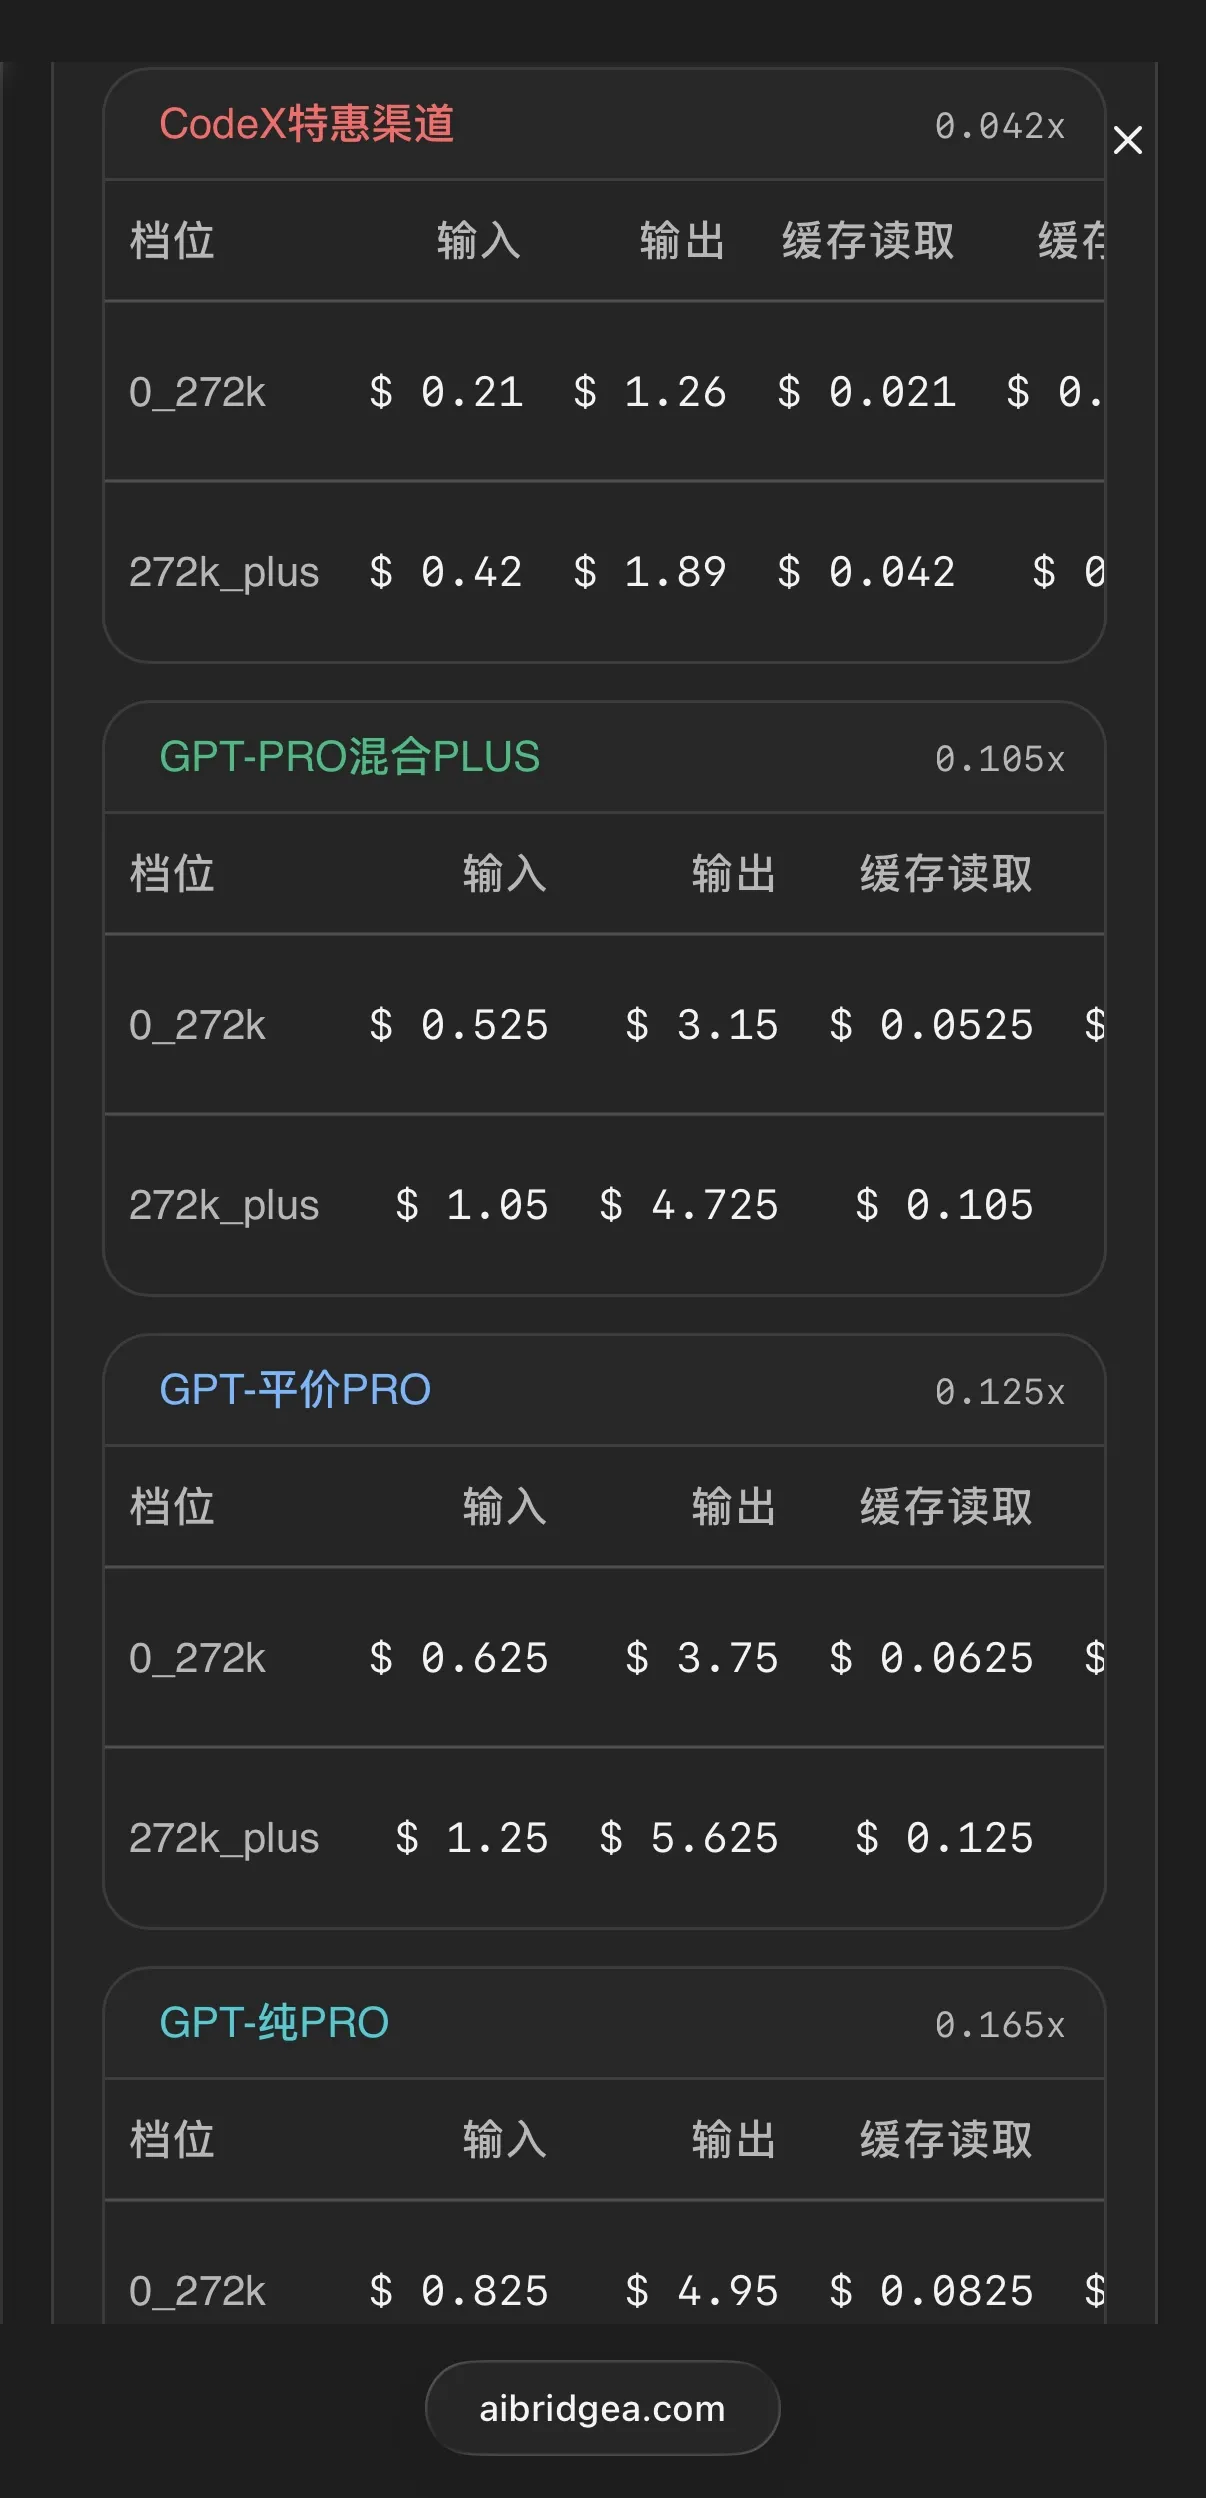
本文提供记录方法,不声称已经完成一周实测。两张图片沿用历史素材;当前模型、功能和费用应以使用前核对及实际记录为准。


