
上下文压缩(Context Compaction)是一种把长对话中较旧的部分收缩成简短摘要的技术——重要事实得以保留,模型的上下文窗口重新腾出空间。
在这篇博客中我们会看到:长对话为何会撑爆上下文窗口、摘要化(summarization)如何在丢失要点的前提下收缩旧消息、以及上下文压缩在真实 AI 智能体中的应用。
我们将涵盖以下内容:
- 什么是大语言模型(LLM)?
- 什么是上下文窗口(context window)?
- 什么是上下文(context)?
- 长对话的问题
- 朴素方案及其失败原因
- 什么是上下文压缩?
- 摘要化如何驱动压缩
- 一步步走一遍流程
- 上下文压缩的代码实现
- 真实 AI 智能体中的压缩
- 上下文压缩为什么重要
什么是大语言模型?
在深入了解上下文压缩之前,我们必须先知道什么是大语言模型。
大语言模型(LLM) 是一种阅读文本并预测下一个词的模型。
简单来说,它是一台非常擅长“猜”的机器。我们给它几个词,它猜出下一个词;然后把猜出的词加回去,再猜下一个。如此循环,一次一个词。
假设我们输入“我想学习”。模型猜出“机器”。现在文本变成了“我想学习机器”。模型重新读一遍全部内容,再猜下一个词。模型就是这样一个词接一个词地写出长答案的。
注意:模型实际处理的是称为 token 的词的小片段。一个 token 可以是一个完整的词、一个词的一部分,甚至单个字母。为了便于理解,我们可以把一个 token 当作一个词。
这就是大语言模型的工作方式。现在,让我们理解上下文窗口。
什么是上下文窗口?
模型无法阅读无限量的文本,它一次能容纳的词数有上限。
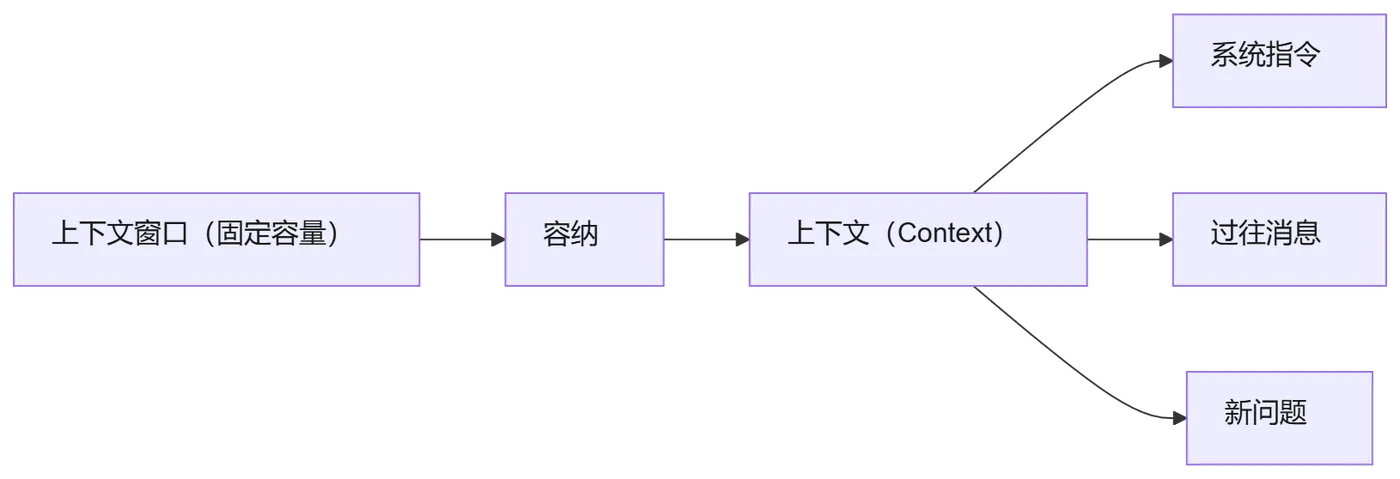
上下文窗口是模型一次能摆在面前的 token 的最大数量。
简单来说,上下文窗口就是模型短期记忆的容量。如果上限是 4,000 个 token,模型就只能记住最近的 4,000 个 token,超出的部分装不下。
可以把上下文窗口想象成一块小白板:只能在上面写这么多字,白板一旦写满,不先擦掉点什么,就一个新字都加不上去了。
所以,上下文窗口是一块固定大小的空间。这个单一事实,就是我们要解决的问题的根源。现在,让我们看看实际上往这块窗口里装的是什么。
下面是上下文窗口与上下文关系的示意图:
什么是上下文?
我们一次性发给模型的全部内容称为上下文(context)。
简单来说,上下文就是模型回答前所阅读的那一整堆文本,是模型在当前这个任务上的工作记忆。
所以,上下文就是模型此刻正在看的所有词的总和。在一场对话中,上下文装着系统指令、过往的每一条消息,以及我们刚提出的新问题。
假设我们正在和一个聊天机器人对话,上下文就是到目前为止整场对话的连续记录。模型每次回复前都会把这份记录完整读一遍——它就是这样“记得”我们之前说过什么的。
这里有一个要点:上下文装在上下文窗口里面。窗口是箱子,上下文是我们塞进箱子的东西。
设计并管理好塞进上下文的一切,本身就是一门手艺(即上下文工程,Context Engineering)。
这就是上下文的运作方式。现在,让我们看看催生上下文压缩需求的那个问题。
长对话的问题
假设我们在构建一个聊天机器人或 AI 编程助手,想连续使用几个小时。对话越变越长:我们发的每条消息、模型给的每个回答,都会被加进上下文。
问题来了:上下文这个箱子的尺寸是固定的,而对话的增长永不停歇。或早或晚,箱子总会被填满。
把箱子逐渐填满的过程可视化如下:
上下文窗口(一个固定容量为 8 条消息的箱子)

对话早期:  [ msg1  msg2  ........................ ]  空间充裕
对话后期:  [ msg1  msg2  msg3  msg4  msg5  msg6 .... ]  逐渐填满
超长对话:  [ msg1  msg2  msg3  msg4  msg5 ... msg8 ]  已满,没有空间

新消息 msg9 到达 -> 装不下了。怎么办?
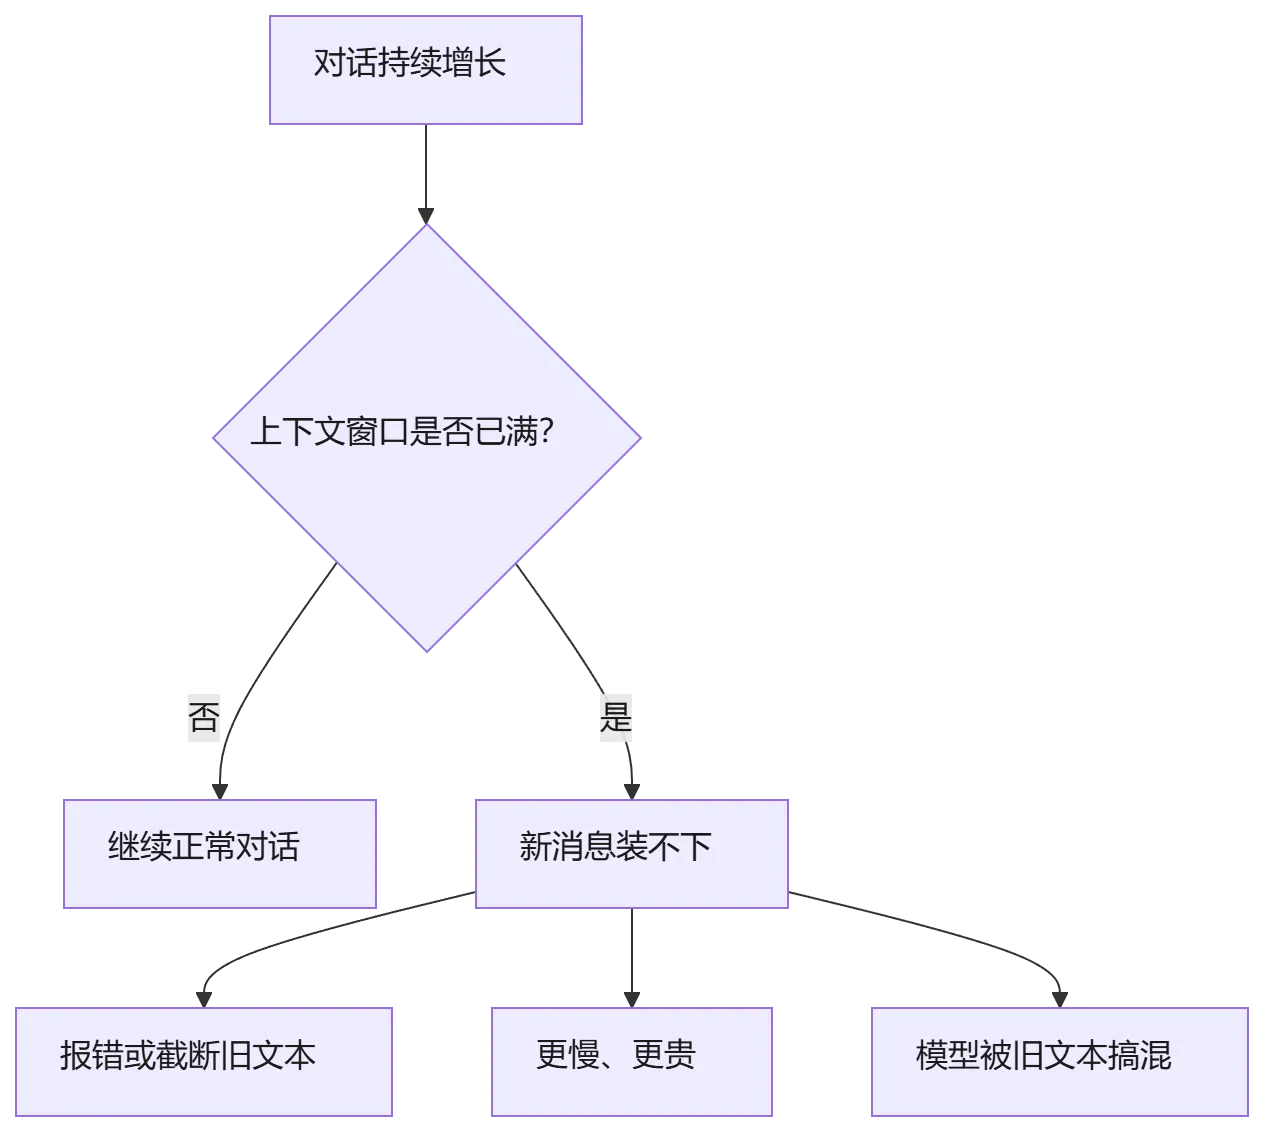
可以看到,随着对话变长,箱子被逐渐填满。当新消息到达而箱子已满时,我们就卡住了:不先移除一些旧的内容,新消息就放不进去。
当上下文溢出时,会发生三件坏事。第一,模型装不下新消息,于是报错或截断旧文本。第二,更满的上下文让模型更慢、更贵,因为它每一轮都要读更多的 token。第三,模型可能被过多的旧文本搞混,失去对重点的把握。
甚至在箱子装满之前,还有一个坑:模型对长上下文的开头和结尾的阅读效果远好于中间(即“中段盲区”问题)。
所以问题就是:如何让对话连续进行几个小时,箱子却不溢出?
上下文溢出的问题可以用下面的流程图来概括:
朴素方案及其失败原因
最显而易见的想法很简单:箱子满了,就把最旧的消息扔掉,只保留最新的那些。这叫滑动窗口(sliding window)。
简单来说,滑动窗口保留一扇“最近消息”的窗口,让旧消息从后面掉出去——就像行进中的火车车窗,旧风景不断向后滑走。
在模型内部,丢掉最旧的文本同样有风险:最开头的那些 token 绝不能掉出窗口(即注意力沉淀池,attention sinks 问题)。
举个例子。假设箱子装 4 条消息,对话是:
msg1 msg2 msg3 msg4 msg5 msg6
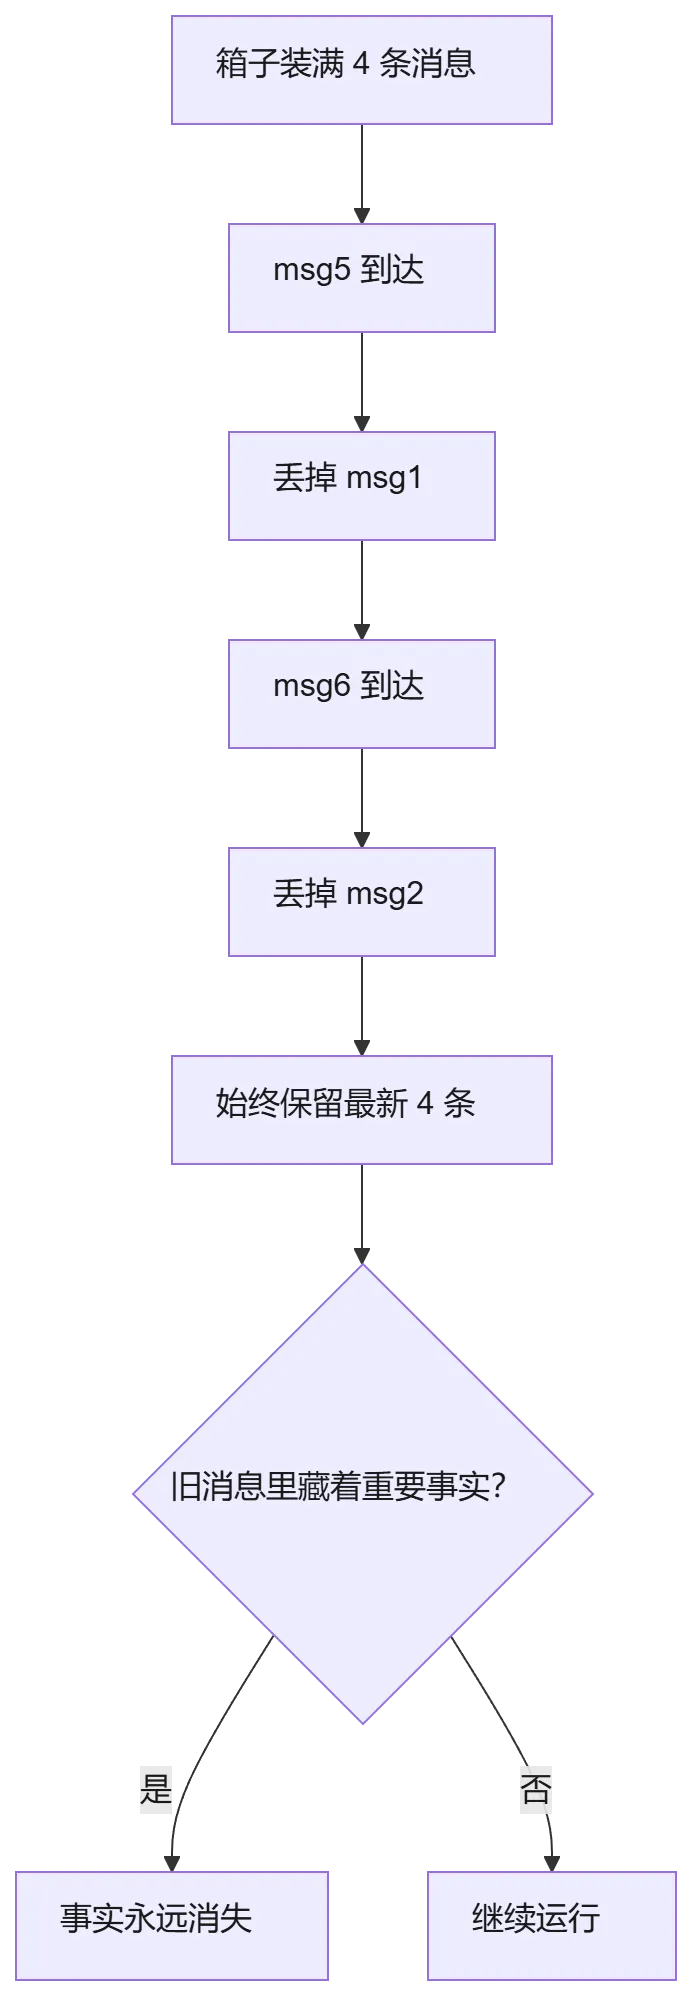
这里有 6 条消息,但箱子只装得下 4 条。msg5 到达时,丢掉 msg1;msg6 到达时,丢掉 msg2。我们始终保留最新的 4 条。
听起来很完美。但问题来了:旧消息里往往藏着我们仍然需要的事实。
假设 msg1 是“我叫 Amit,正在用 Kotlin 开发一个 Android 应用”。几个小时后我们问:“我用的是什么语言?”如果 msg1 早被丢掉了,模型就无从知晓。这个事实永远消失了,模型要么猜错,要么直接说不知道。
这个方案的问题在于:扔掉旧消息,同时也扔掉了藏在里面的重要事实。我们丢失的是记忆,而不只是文字。看看下一个想法如何解决。
滑动窗口方案的运作与缺陷可以用下面的图来展示:
什么是上下文压缩?
于是,上下文压缩登场救场。
上下文压缩是这样一种技术:把旧对话收缩成一份简短摘要,让重要事实留下,同时让箱子重新腾出空间。
简单来说,我们不是删除旧消息,而是把它们“挤压”一下——用一份保留了关键事实的小笔记,替换掉一大堆旧文本。箱子变空了,记忆却活了下来。
为了便于理解,把这个词拆开:
上下文压缩(Context Compaction)= 上下文(Context)+ 压缩(Compaction)
“上下文”是模型阅读的全部文本;“压缩”指把东西压得更小。所以上下文压缩就是:在保住要害的前提下,把文本压小。
假设我们有一本 20 页的当日日记。明天我们并不需要全部 20 页——可以写一份半页纸的摘要,记下重要事件,然后扔掉那 20 页。我们丢了细枝末节,但留住了故事主线。那半页纸,就是压缩后的上下文。
把行李箱类比映射过来,让这个概念在脑子里立住:
| 收拾行李箱 | 上下文压缩 |
|---|---|
| 行李箱 | 上下文窗口(尺寸固定) |
| 全部衣物 | 完整的对话历史 |
| 衣物塞到溢出 | 上下文被填满 |
| 把衣物叠紧、真空压缩 | 对旧消息做摘要 |
| 叠放整齐的行李箱 | 压缩后更小的上下文 |
| 扔掉垃圾、留下衣物 | 丢掉填充性内容、留住关键事实 |
可以看到:箱子满了,我们并不是把衣服扔掉,而是把它们叠紧来腾出空间。上下文压缩对文字做的正是同样的事。
这是整个主题的心脏。现在,让我们理解驱动压缩运转的引擎。
摘要化如何驱动压缩
收缩旧文本的方式是摘要化(summarization)。
简单来说,摘要化就是让模型自己去读旧消息,写一份只保留关键点的简短笔记。
巧妙之处在于:回答我们问题的那个大语言模型,本身也非常擅长总结文本。所以我们让它身兼两职。我们对它说:"读读这段旧对话,把重要事实写成一份简短摘要。"它交给我们一张小小的便条。
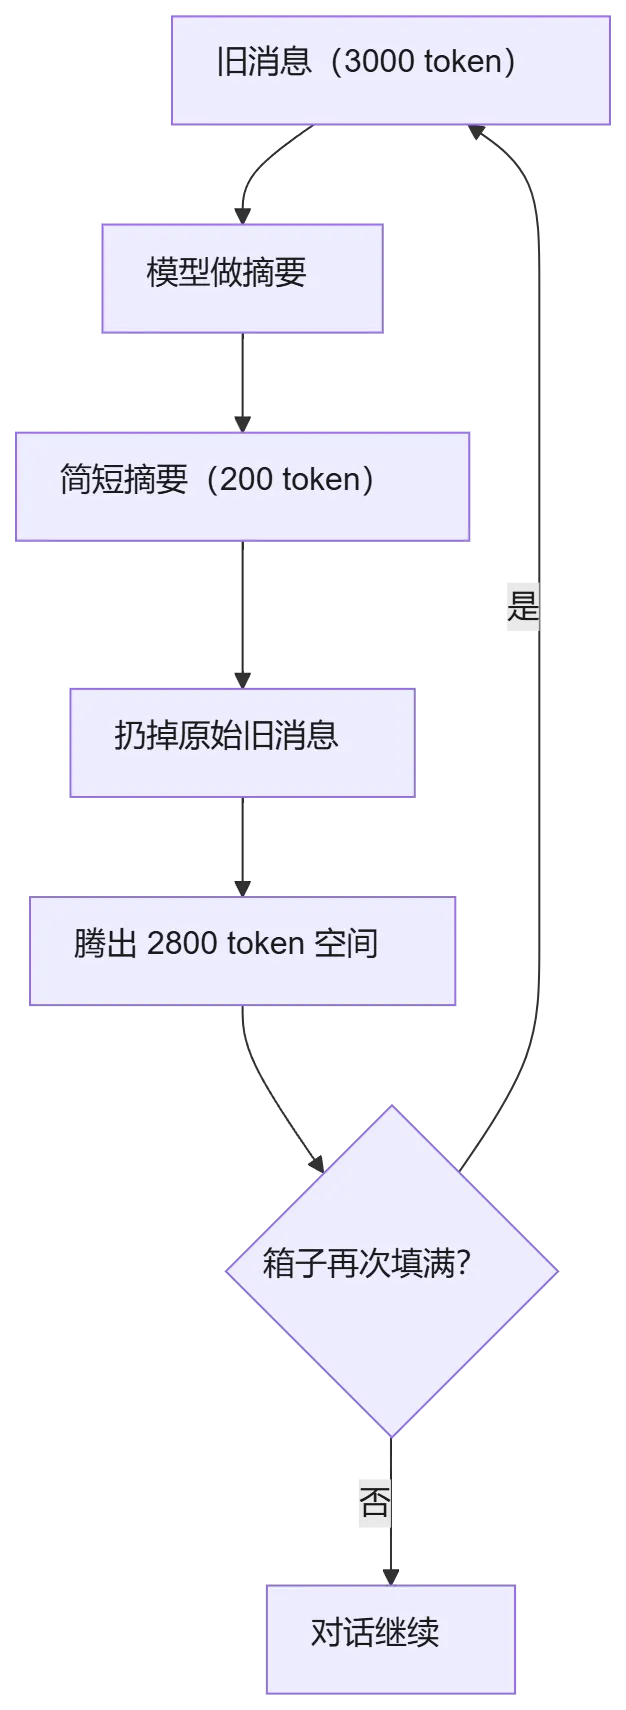
假设旧消息长 3,000 个 token。我们把它喂给模型并要求摘要,模型返回一份 200 token 的笔记,里面仍然记着用户的名字、项目、所用语言和至今做过的决策。
然后我们扔掉 3,000 token 的原始旧消息,只保留这份 200 token 的摘要。我们刚腾出了 2,800 token 的空间,而且没有丢失重要事实。这就是全部诀窍。
这个流程可以画成:
 旧消息              模型              简短摘要
 (3000 token)      (做摘要)          (200 token)
 +-------------+                +-----------+
 | msg1 msg2   |                | 关键事实  |
 | msg3 ...旧  |  --> 读取并 --> | 名字      |
 | 原始历史    |      摘要       | 项目      |
 +-------------+                +-----------+

 扔掉 3000 个原始 token,留下 200 token 的笔记。
可以看到:原始旧消息进入模型,一张小笔记被吐出来——回答我们问题的同一个模型,同时也是收缩文本的引擎。
还有一点值得注意:这件事可以反复做。下次箱子再满时,我们把"新的旧消息"连同上一份摘要一起,再总结成一份全新的、更短的摘要。所以每当箱子被填满,压缩就再跑一轮。
所以,摘要化是引擎,压缩是结果。现在,让我们用具体数字看它跑起来。
摘要化驱动压缩的完整循环可以用下面的图来展示:
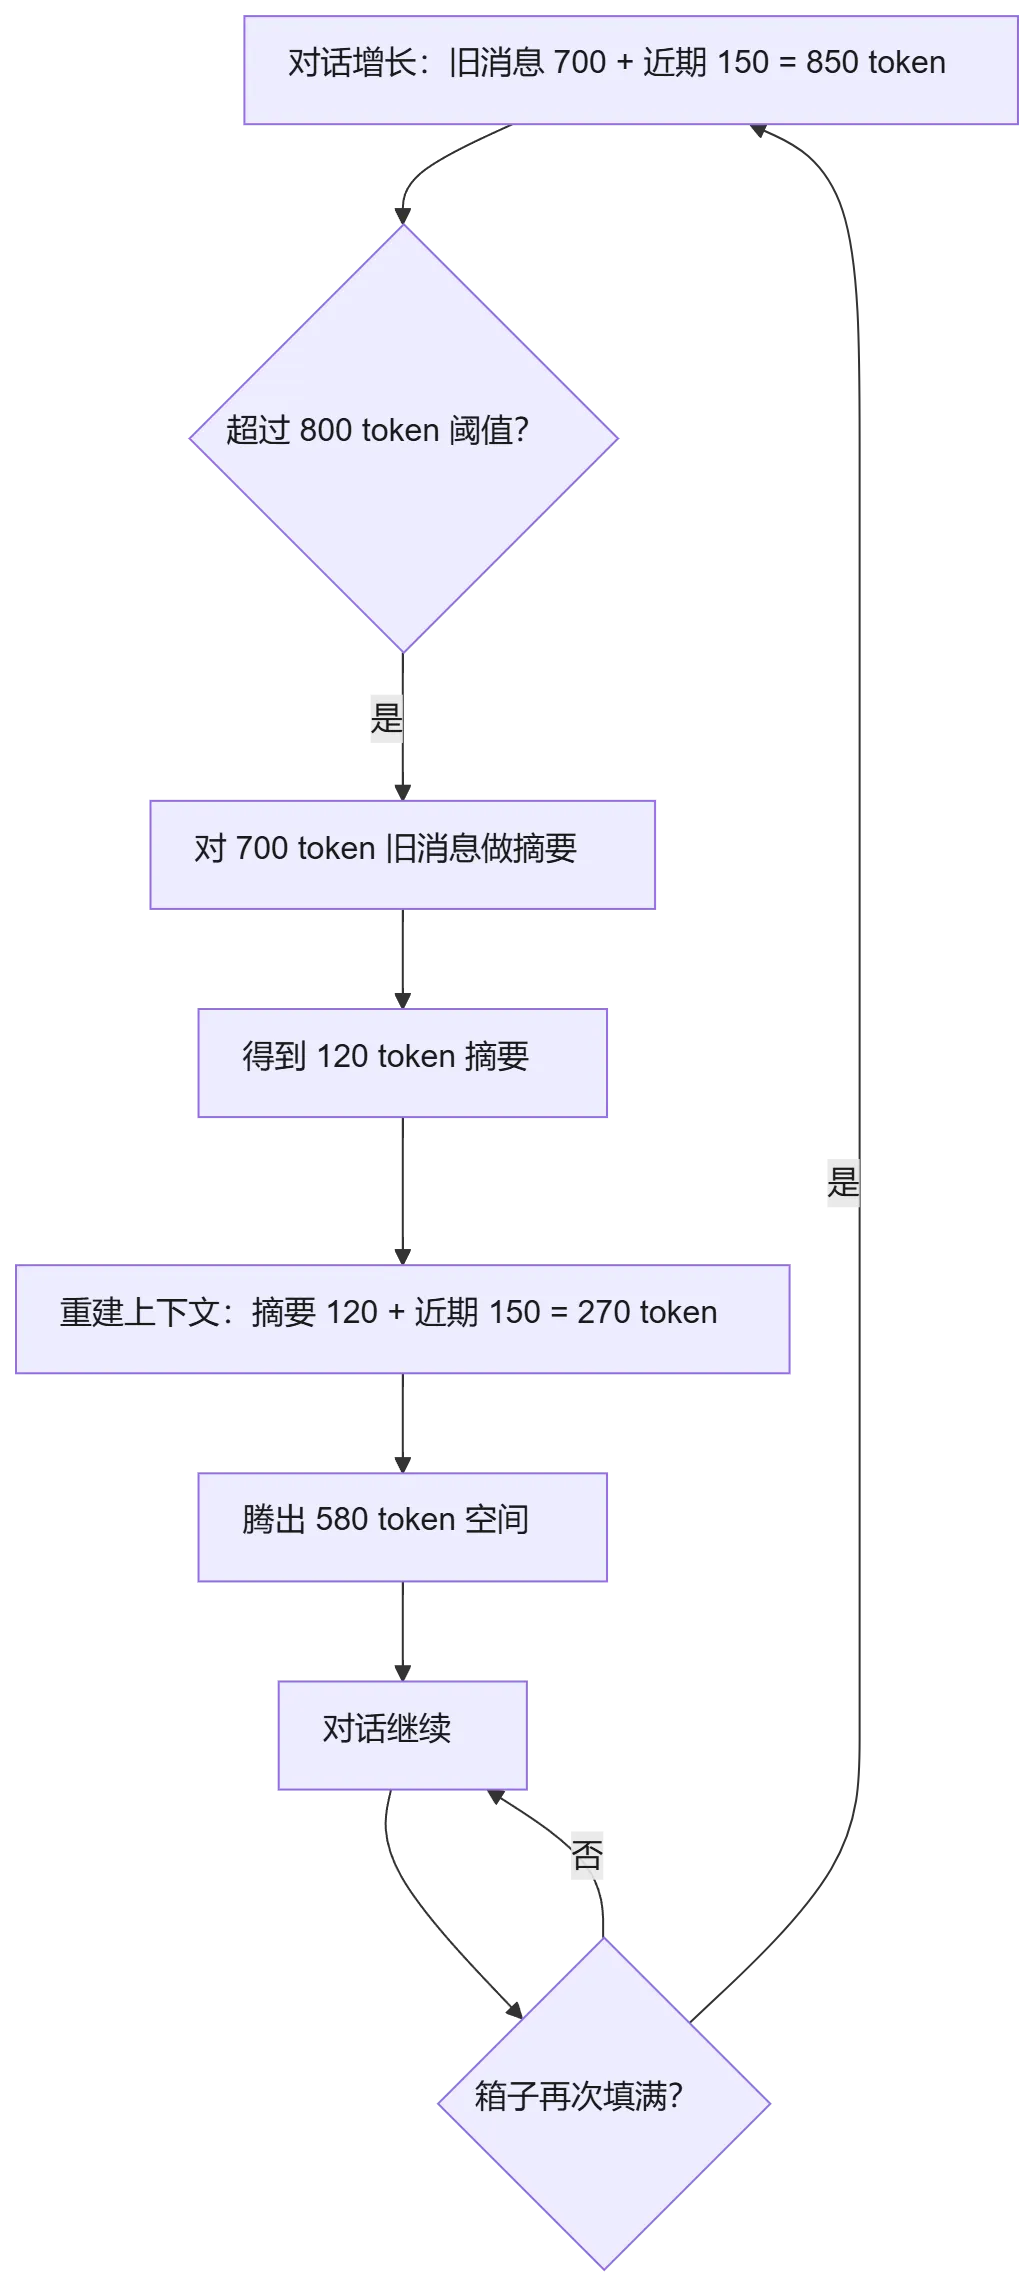
一步步走一遍流程
通过例子学习是最好的方式。我们取一个小例子,跟着数字走。
假设上下文窗口容量 1,000 token。我们定一条规则:当上下文超过 800 token 时,执行压缩。
第 1 步:对话增长。多轮之后,旧消息占了 700 token,近期消息占 150 token,总计 850 token。已越过 800 token 线,该压缩了。
第 2 步:我们取那 700 token 的旧消息,让模型做摘要。模型读完,返回一份只有 120 token 的简短摘要,其中保住了用户的名字、项目目标和关键决策。
第 3 步:重建上下文。扔掉 700 token 的旧消息,把 120 token 的摘要放到原来的位置。150 token 的近期消息原封不动地保留,因为它们还很新鲜、很详细。
新上下文如下:
压缩前(850 token,超限):
 [ 旧消息: 700 ] + [ 近期消息: 150 ]  ->  850(太大)

压缩后(270 token,空间充裕):
 [ 摘要: 120 ] + [ 近期消息: 150 ]   ->  270(大量空间)

腾出了 580 token,且保住了全部重要事实。
可以看到,上下文从 850 token 降到了 270 token,腾出了 580 token 的空间。近期消息保持完整细节,旧消息变成一份仍然承载事实的简短摘要。
第 4 步:对话继续。模型现在读的是“小摘要 + 近期消息”。它仍然知道我们的名字和项目,所以回答正确。之后箱子再次填满时,再跑一轮压缩即可。
数字就是这样算的。现在让我们看代码。
一步步走一遍流程的完整过程可以用下面的图来展示:
上下文压缩的代码实现
先看代码。首先是朴素滑动窗口——那个会“忘事”的坏版本:
def naive_sliding_window(messages, max_messages):
    # 只保留最近的消息
    return messages[-max_messages:]
这里只保留了最后 max_messages 条。它把旧消息丢得一干二净,也就意味着旧消息里藏着的每个事实都丢了。这是会遗忘的版本。
现在是我们改进后的代码——压缩而非删除:
def compact_context(messages, recent_count, summarize):
    # 把历史切分为“旧”与“近期”两部分
    old = messages[:-recent_count]
    recent = messages[-recent_count:]

    # 把旧消息变成一份简短摘要
    summary = summarize(old)

    # 重建:简短摘要在前,近期消息在后
    return [summary] + recent
看看我们做了什么:
- 把历史切分为
old(旧消息)和最后recent_count条近期消息。 - 调用
summarize(old),让模型把旧消息压缩成一份简短笔记。 - 把上下文重建为:简短的
summary在前,详细的recent在后。
旧事实活在摘要里,近期细节保持完整,上下文重新变小,对话得以继续。问题解决了。
注意:实践中我们不是每条消息后都压缩,而是只在上下文越过阈值(比如窗口的 80%)时才执行压缩。这能把成本控制在低位。
这就是代码的工作方式。现在看看真实的 AI 工具是怎么用它的。
真实 AI 智能体中的压缩
上下文压缩不只是纸面上的想法,它被大量用于现代 AI 智能体和编程助手中。
简单来说,AI 智能体是一个借助大语言模型连续执行多个步骤的程序——比如读文件、跑命令、修代码。每一步都会往上下文里添加更多文本。一个长任务跑下来,上下文会变得非常庞大。决定何时压缩、以及这个循环还要控制些什么,属于循环工程(Loop Engineering)的范畴。
假设一个编程助手已经工作了一个小时:它读了几十个文件、跑了许多命令,原始历史已经膨胀到箱子几乎装满。没有压缩的话,助手就会忘掉任务最初的目标。
于是助手在后台执行上下文压缩:把旧步骤总结成一份简短笔记,比如"目标:修复登录 bug。已改过 auth.py 和 login.py。测试已通过。"然后带着这份小笔记加上最新步骤继续工作。
还有更进一步的一步:好的压缩会把一些内容完整保留、永不摘要掉。原始系统指令要保留;用户的主要目标要保留;最新的几条消息保持完整细节。只有杂乱的中间部分被压缩。
所以,现代智能体把压缩当作一个被规划好的特性,而不是事后补救。它们保护最重要的部分,挤压其余部分。这就是一个智能体能在长任务上连续工作数小时而不迷失方向的原因。
上下文压缩为什么重要
现在我们已经完整理解了上下文压缩。来看看它为什么对我们都重要:
- 它让聊天机器人和智能体可以连续运行数小时,而不会撑爆上下文窗口
- 它让重要事实一直存活,只扔掉填充性的内容
- 它让成本和速度可控,因为模型每轮读的 token 更少
- 它把一个硬性的记忆上限,变成一场平滑的、永不终结的对话
这样,我们就能用上下文压缩解决这个有趣的问题:在一个小而固定的记忆里装下长对话,同时不忘掉真正重要的东西。
常见问题(FAQ)
上下文压缩和滑动窗口有什么区别?
滑动窗口删除最旧的消息,而上下文压缩对它们做摘要。用滑动窗口,藏在旧消息里的事实永远消失;用压缩,旧消息变成一份保留关键事实的简短摘要,所以模型仍然记得它们。
上下文压缩会丢失信息吗?
会,但只丢细枝末节。压缩用一份保留重要事实(用户名字、项目目标、关键决策)的简短摘要替换掉长长的原始历史。被丢弃的只有填充性内容,所以模型保住了故事主线,上下文窗口也重新腾出了空间。
上下文压缩应该多久跑一次?
应该只在上下文越过阈值时才压缩,而不是每条消息后都压。比如可以设在上下文达到窗口的 80% 时执行,这样成本可控。之后窗口再次填满时,再跑一轮压缩即可。
上下文里哪些部分永远不该被摘要?
原始系统指令、用户的主要目标,以及最新的几条消息应保持完整。好的压缩保护这些部分,只压缩杂乱的中间。这就是智能体能在长任务上连续工作数小时而不迷失方向的原因。
上下文压缩能降低成本吗?
能。更满的上下文让模型更慢更贵,因为每轮要读更多 token。压缩把旧历史收缩成简短摘要,模型每轮读的 token 更少,成本和速度就都可控了。

