从一张十亿行的表里按行号取一行,Parquet 读进来的往往远不止那一行。
这不是引擎笨,是它的文件布局从出生那天起就冲着顺序扫描去的,一次把一整列从头读到尾的吞吐。
而随机访问,按行号点查、随机采样、多模态数据里跳着取记录,是另一套完全不同的负载。
于是就有一个很具体的问题,为什么随机访问在 Parquet 上这么贵,Lance 和 Vortex 又是怎么把它修便宜的。
把这三份格式规范摆在一起读,你会发现大家争的其实是一个很底层的东西,谁来决定行的物理边界,以及那个边界有多粗。
先把 Parquet 那一边拆开看。
它的文件是一层套一层的容器,最外面是行组(row group),一个横向按行切开的块。
一个行组里,每一列都有一段属于自己的数据,叫列块(column chunk),这段数据在文件里还是连续存放的。
列块再往下切,切成页(page)。
规范给页下的定义很关键,页是压缩和编码上不可再分的最小单元。
你想取某一行,得先定位它在哪个行组、哪一列、哪一页,然后把这一整页读进来,解压,解码,再从里面挑出你要的那一行。
一页里装着成千上万行。
你要一行,它给你一整页。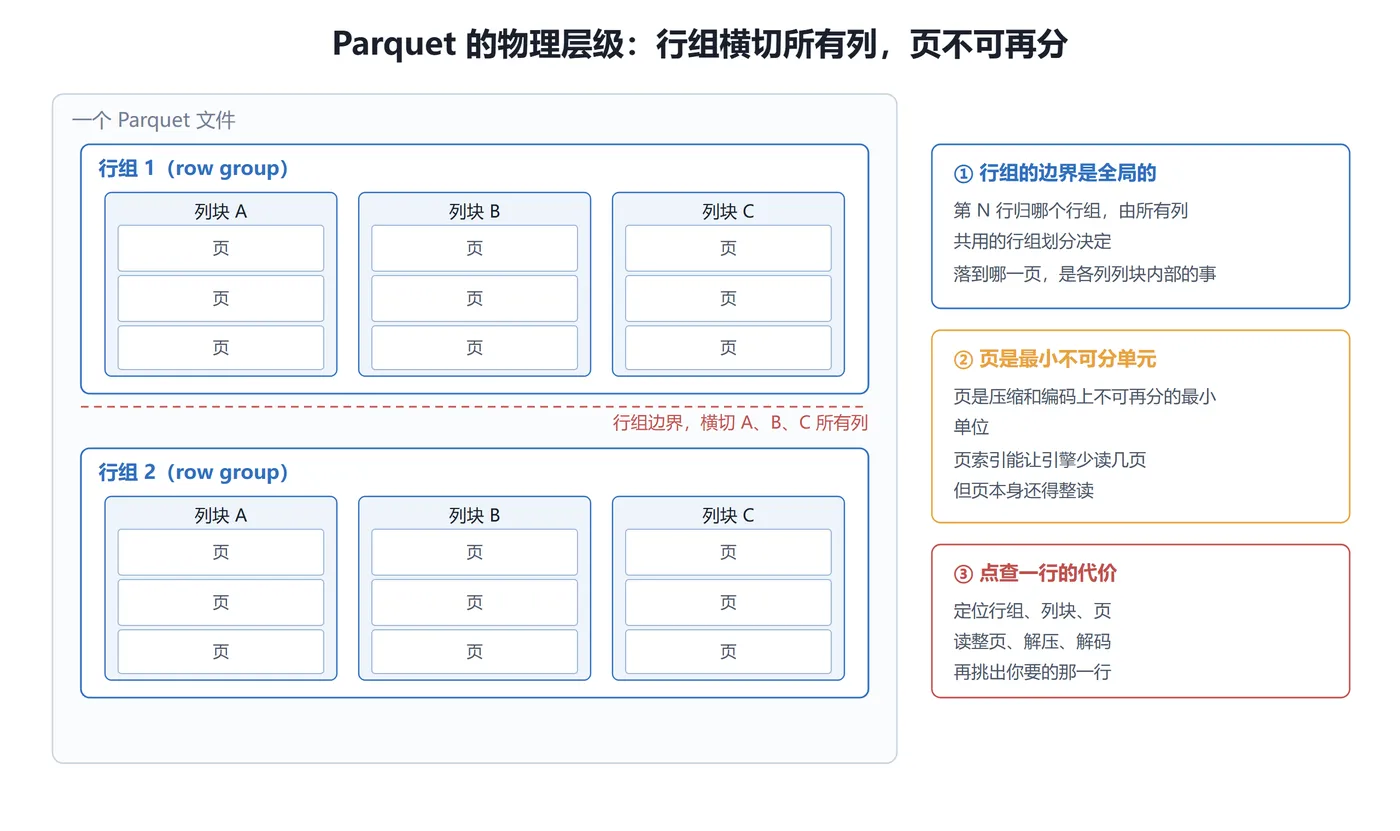
Parquet 后来补了一层叫页索引(page index)的东西,专门治这个。
它由两部分组成,一个列索引(ColumnIndex)记每一页的最小最大值,一个偏移索引(OffsetIndex)按行号记每一页的位置。
有了它,引擎可以拿谓词去和每页的 min/max 比一比,把明显不相关的页跳过去,再顺着偏移索引直接跳到目标页。
规范里把目标写得很直白,按排序列做单行点查时,每读一列只碰一个数据页。
页索引能干的事是页级跳过,它让少读几页变便宜,但它没把页这个不可再分的单位变小。
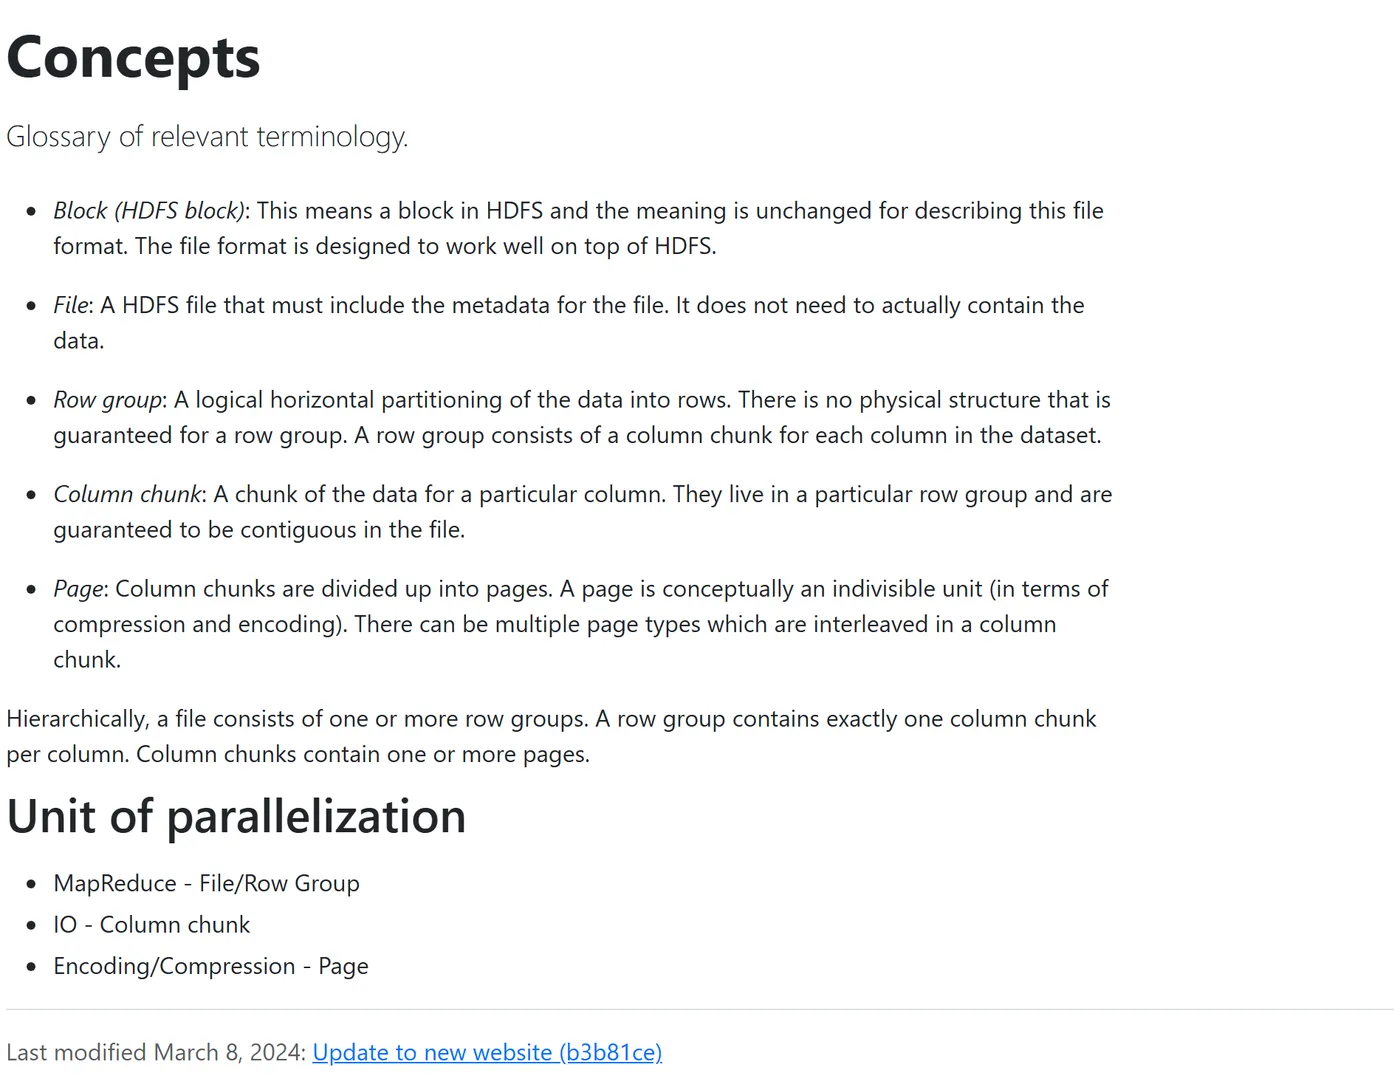
这层设计在 Parquet 官网的 概念页 里写得最清楚,行组、列块、页三级,各自的并行单元都标得明明白白。
Parquet 的文件元数据整个写在数据后面,为的是单遍写,代价是读端得跳到文件尾巴把它捞出来。
页索引也是后补的,被特意放在 footer 附近、跟行组分开存,不做选择性扫描的读端,压根不用付读这份索引的钱。
页索引是可选件,老文件里可能根本没有,没有它的文件,谓词只能退回行组级的 min/max,粒度更粗。
这套设计的每一步,都在翻译同一句话,默认你是在做大扫描。
行组的问题还不止页不可再分。
更麻烦的一层是,行组划出的是跨列共享的粗行边界,它只负责说某一行归哪个行组,这个边界所有列一起用。
而某一行落在哪一页,是各列自己列块内部的分页说了算,跟行组划分不是一回事。
你没法在行组这一层给某一列设一个更细的粒度,因为它是全局的。
可到了页这一层,退路也没了,各列虽各切各页,页本身还是不可再分,读的时候照样得整读。
列块连续放是为了读一整列时是一段连续 I/O,页作为压缩单元是为了让跨行编码在足够长的序列上跑出高压缩比。
问题在于,这些优化有一个共同前提,你是在顺序地、成批地读。
Parquet 的字典编码,一个列块里最多只有一个字典页,而且必须放在列块最前面,你要解码列块里任意一页的字典索引,就得先把整个字典读进来。
delta 编码、前缀压缩(DELTA_BYTE_ARRAY)这些,是按前一个值、上一条前缀递推出来的,你想从序列中间取第 100 行,没法从中间起步,得从头顺着解到那。
编码本身就把随机跳进去这条路给堵了。
规范还把并行单元标得清清楚楚,MapReduce 按文件或行组并行,I/O 按列块并行,编码压缩按页并行,随机访问不在这个清单里。
Parquet 这两年在补一种叫 ALP 的浮点编码,规范里明确写它每个值独立编码,支持对单值随机访问和并行解码。
连 Parquet 自己都在往随机访问友好的方向挪了。
Lance 的答案干脆,它把行组整个删了。
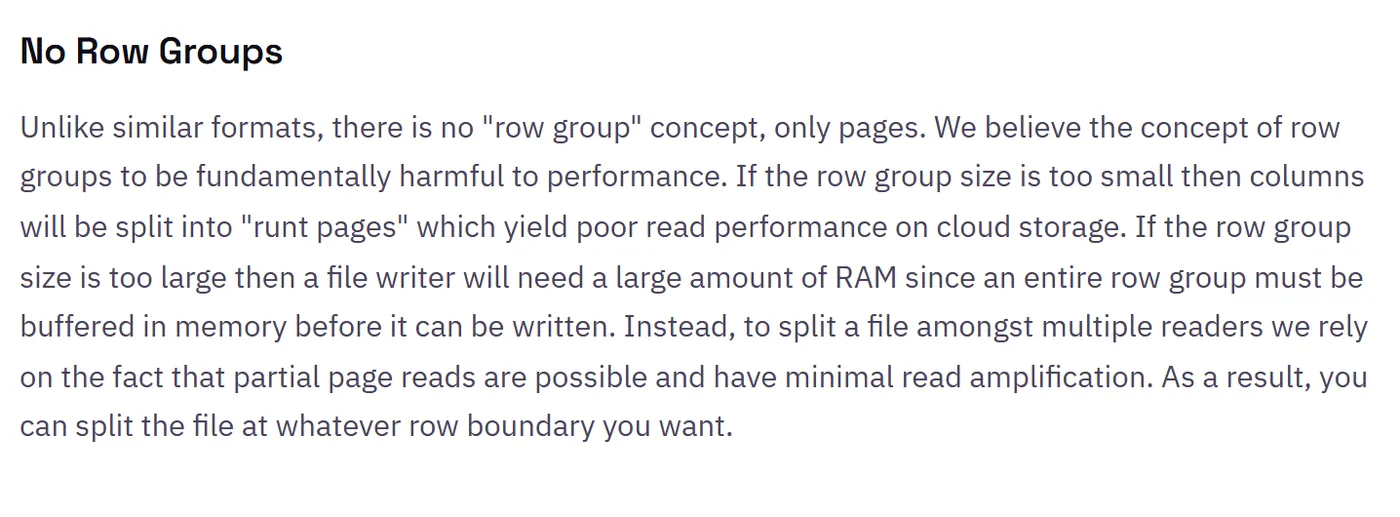
规范里有一节的标题就叫「No Row Groups」,原话更狠,说行组这个概念从根本上对性能有害。
行组太小,列会被切成一堆矮页(runt page),在云存储上读起来稀碎,吞吐全丢。
行组太大,写入端就得先把整个行组在内存里攒齐才能落盘,内存直接爆炸。
两条都指向同一个结论,行组的粒度是全局的,没法同时满足所有列。
Lance 只留磁盘页这一层,每一列各切各的页,页数可以不一样。
它明确说页不该是不透明的,需要时可以只读页里的一部分,文件就能在任意行边界上拆给多个读端,不用再受行组的牵制。
具体怎么在页里定位一行,Lance 靠的是一套叫迷你块(mini block)的布局。
它把一页切成很多个小块,每个迷你块装 2 的幂这么多个值,压完不超过 32 KiB。
规范里有一句话很坦率,要取单值就得读整个迷你块,所以迷你块必须做小。
为了让读端知道每个迷你块在哪、装了多少值,它单独留了一小段元数据,每个迷你块只占两个字节,12 位记这个块占几个 8 字节字,4 位记块里值个数的对数。
关键就在这两个字节。
这段小元数据在初始化阶段被加载进一个叫搜索缓存的东西,之后就常驻内存。
要取第 N 行,读端拿这份索引一算,就知道目标行落在哪个迷你块、哪个字节区间,直接去读那一段。
页还是那个页,但页内部的坐标,变成了一张随手能查的小地图。
Lance 的文件层还故意不塞表统计和查询索引,这些被拆成独立的规范层,索引想加就加。
对大值,比如向量 embedding,它另有一套全压缩(full zip)布局,用一条重复索引每一行记一个 u64 偏移,代价是随机访问一次要两趟 I/O。
到 1 MiB 往上的巨型二进制,还有一套 blob 布局,干脆走外置,一次 I/O 取一个值。
这些布局都要求压缩是透明的,也就是压完之后还能算出每一个值的位置,delta 这种把值串成一条链的编码在这儿就用不了。
编码长什么样,直接决定了随机访问这条路通不通。
Vortex 走的是第三条路,它压根不预设行组该有多大。
在它的模型里,文件就是一棵布局树(layout tree)序列化之后的样子,数据放在一堆叫 segment 的块里。
规范里有一句我读了两遍的话,说要还是不要行组这类东西,是写入端决定的,不是规范硬性规定的。
它的默认布局策略是这样一层层摞的。
最上层按列拆成结构布局,每一列套一层分区布局(ZonedLayout),每 8k 行记一份统计。
再套一层分块布局,按 2 MiB 未压缩数据切成块,然后过一遍压缩策略,再用缓冲布局把压完的块本地化到 1 MiB 一段,最后落到最底下的扁平布局。
结构布局管列裁剪,分区布局管行裁剪,缓冲布局管 I/O,每一层都是为了少读东西。
分区布局那层尤其要看,它存的是 zone map,也就是每一段行的 min/max 统计,扫描的时候先拿谓词去和这些统计比一遍,把整段无关的行区间直接证伪掉,连底层数据都不用碰,这一步叫修剪。
剩下的才读出过滤用到的列,算出一张行掩码。
Vortex 的另一半答案在编码上。
它的数组天生就是压缩态,很多运算不用下压,直接在压缩数据上做。
它带了一大票编码,FastLanes 那套位打包、delta、RLE 是 SIMD 加速的,字符串走 FSST,浮点走 ALP,还有一套 PCodec。
查询引擎拿到的可能就是压缩数组本身,比如 DuckDB 能直接接住 FSST 编码的字符串,中间省掉一次解压。
文件尾巴上是一个不超过 64 KiB 的后记(postscript),里面指着 dtype、布局、统计、footer 这几段,读的时候默认一次读 64 KiB 就能把这个后记覆盖住。
后记里的 footer 用字典编码压过一层,元数据走 FlatBuffer,列级定位是 O(1) 的。
Vortex 还年轻,它自己的规范写着,格式的兼容保证从 0.36.0 版起算,扫描接口那页也直说 API 还在路线图上,没定型。
这份年轻是它灵活性的代价,也意味着现在押注它,赌的是方向。
Lance 那边也有同类的清醒,它的规范把 2.3 标成 unstable,直说不要用在生产,因为编码还可能变,稳的那条线是 2.2,升级要显式钉版本,别跟着 next 这个别名漂。
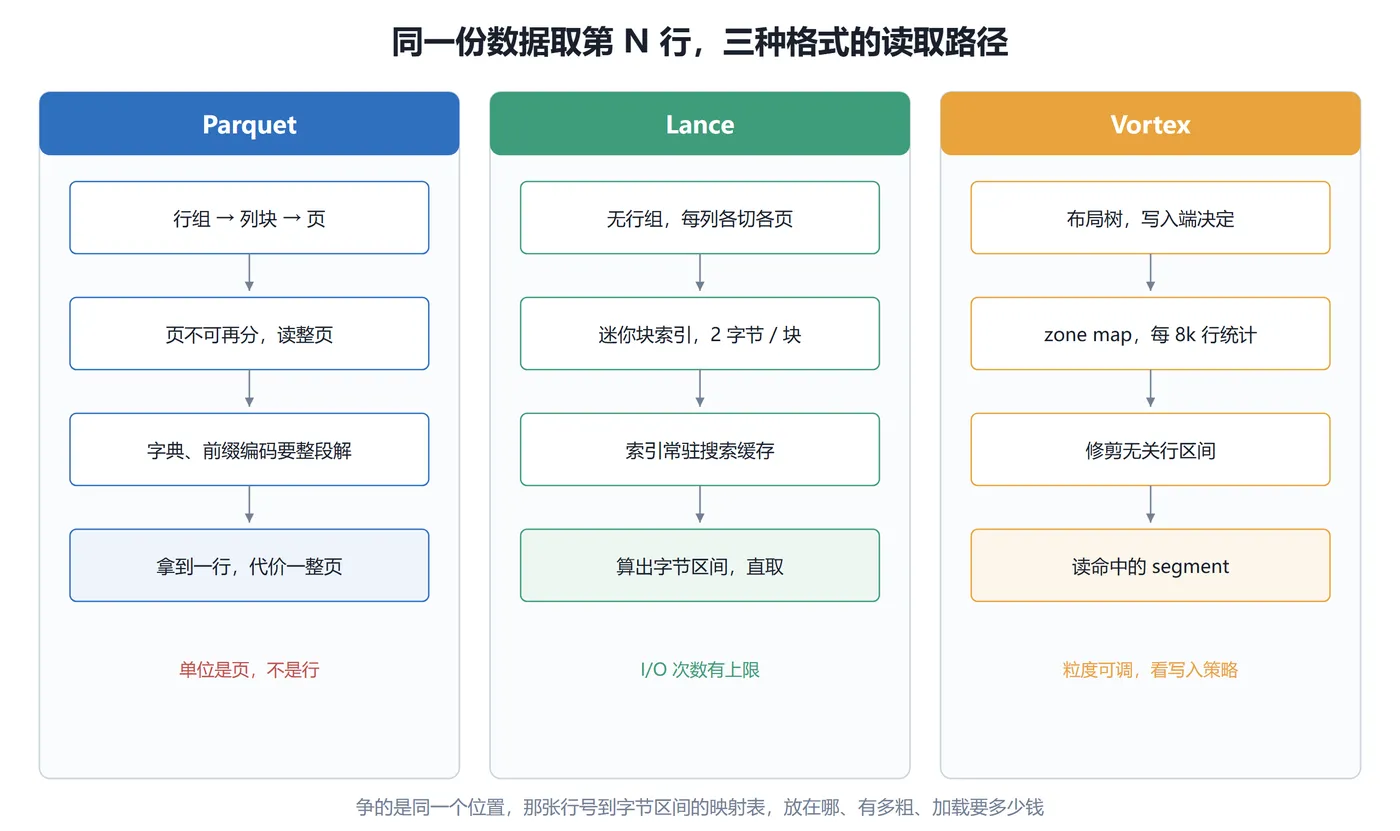
把三份摆到一起,按负载过一遍,差异就清楚了。
点查一行。
Parquet 要读一整页,还可能要把整个列块的字典拉进来。
Lance 靠搜索缓存里那份两字节一条的迷你块索引,算出字节区间直取,I/O 次数有上限。
Vortex 先过分区统计把无关区间修掉,再读命中段的 segment,段的 offset 和 length 就写在 footer 里。
采样一批随机行,这个负载是 Parquet 最难受的地方,行组的切分开销全压在它头上,抽得越散,读得越碎。
Lance 的规范点名过这类负载,说 ML 训练非顺序地采样行、向量检索的二次取数,正是它要照顾的。
Vortex 靠分块加分区裁剪,把随机抽取摊成一组可控的段读取。
多模态数据,图片、视频、向量。
Parquet 那套定宽列加每列块一个字典的结构,天生不待见大二进制。
Lance 有 blob 布局做外置惰性加载,向量还有专门的向量索引,索引在它的规范里是一等公民。
Vortex 用编码组合来解,什么样的数据配什么样的编码。
再往深看一层,这三种格式争的是同一个位置,那张行号到字节区间的映射表放在哪、有多粗、加载要多少钱。
Parquet 把它放得很靠外,是可选的页索引,粒度是页,页还得整读。
Lance 把它做得很小很密,藏在每一页自己的迷你块元数据里,初始化就进缓存,随用随查。
Vortex 把它做成一棵可组合的树,粒度由写入端挑,行裁剪靠 zone map,段定位靠 footer。
三家的动作方向是一致的,都在把那个又粗又全局的物理单位拆细,拆到可以便宜地加载,区别只在拆的力度,和开的口子。
这三种格式都不绑定计算引擎。
Parquet 谁都能读,Lance 和 Vortex 也都接进了 DataFusion、DuckDB、Spark、Trino 这一圈,所以格式的选择和引擎的选择是两件事。
落到用的人身上,我的判断是,这不是谁替代谁的问题。
做纯分析、跑大扫描的表,Parquet 仍然是那个最稳的默认,生态全,顺序吞吐好,这套行组设计在它擅长的场景里没毛病。
真正该考虑换格式的,是随机访问占了大头的那类负载,向量检索、模型训练的采样、交互式点查。
这类场景里文件格式选错,换再强的计算引擎也补不回来,因为瓶颈在布局里,不在算子。
Lance 给的是全套,文件、表、索引、目录一份规范压到底,代价是你要接受它整条栈,Vortex 给的是积木,布局和编码都拆成可插件,代价是很多决定得你自己拿。
说实话,一个收成栈、一个摊成工具包,这个路线上的分岔,比谁快几个点更值得记。
写这篇之前,我把三份规范来回读了几遍。
Parquet 概念页对页下的那句定义,Lance 规范里叫「No Row Groups」的那一节,Vortex 布局页 里那段拿 Parquet 行组举例的文字,是我觉得最见设计意图的三个地方,配着这篇看正好。
祝大家,取数愉快。