Python用枚举记录条目的原始位置

简介: 先明确范围,再分步骤整理,最后核对实际结果。内容由 AI 辅助整理。

Python用枚举记录条目的原始位置,可以从一个范围很小的例子开始。先把当前情况记录清楚,再逐步调整安排,能够避免一次改变太多东西以后反而找不到原因。本文整理一个便于反复核对的操作思路,不必一次处理所有内容。
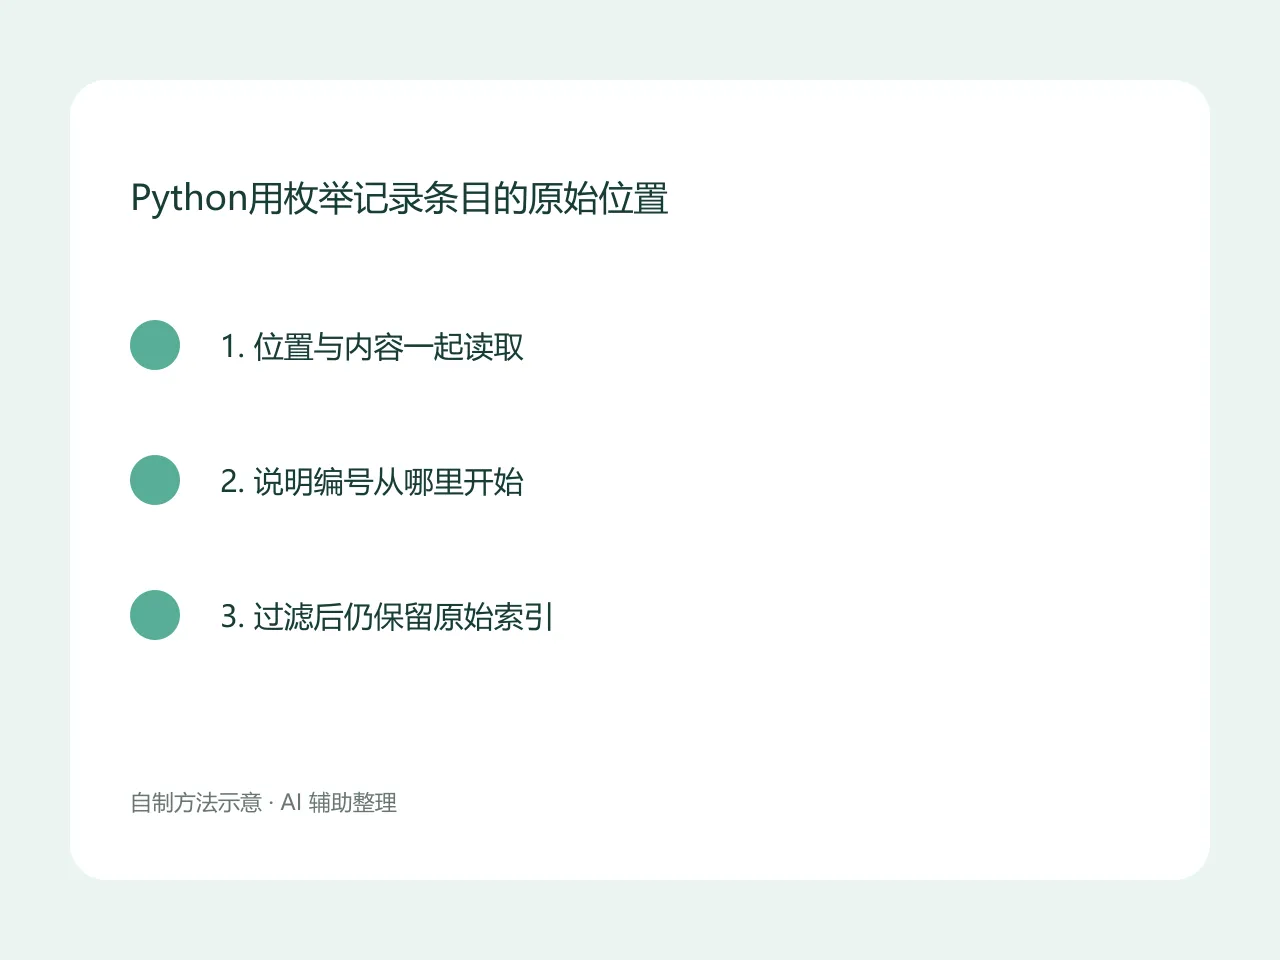
操作示意

位置与内容一起读取

1、位置与内容一起读取是这一阶段需要完成的具体动作。先确定手头有哪些条目,把来源、用途和需要核对的地方分别记下来。对于不能马上确认的内容,可以先标记为待确认,不要为了让清单看起来整齐而随意填写。

实际操作时,先挑三个有代表性的例子:一个最常见的情况,一个容易混淆的情况,再加一个暂时没有明确结论的情况。分别观察处理前后的差异,把判断依据写成一句简单的话。这样之后再次使用时,就不必重新猜测当时为什么这样安排。

如果发现某个条目始终无法归类,先检查分类条件是否足够明确,而不是立即增加很多细分层级。保留原始信息、记录修改原因,再选一个小范围重新核对,通常比盲目扩大处理范围更稳妥。

说明编号从哪里开始

2、说明编号从哪里开始是这一阶段需要完成的具体动作。先确定手头有哪些条目,把来源、用途和需要核对的地方分别记下来。对于不能马上确认的内容,可以先标记为待确认,不要为了让清单看起来整齐而随意填写。

实际操作时,先挑三个有代表性的例子:一个最常见的情况,一个容易混淆的情况,再加一个暂时没有明确结论的情况。分别观察处理前后的差异,把判断依据写成一句简单的话。这样之后再次使用时,就不必重新猜测当时为什么这样安排。

如果发现某个条目始终无法归类,先检查分类条件是否足够明确,而不是立即增加很多细分层级。保留原始信息、记录修改原因,再选一个小范围重新核对,通常比盲目扩大处理范围更稳妥。

过滤后仍保留原始索引

3、过滤后仍保留原始索引是这一阶段需要完成的具体动作。先确定手头有哪些条目,把来源、用途和需要核对的地方分别记下来。对于不能马上确认的内容,可以先标记为待确认,不要为了让清单看起来整齐而随意填写。

实际操作时,先挑三个有代表性的例子:一个最常见的情况,一个容易混淆的情况,再加一个暂时没有明确结论的情况。分别观察处理前后的差异,把判断依据写成一句简单的话。这样之后再次使用时,就不必重新猜测当时为什么这样安排。

如果发现某个条目始终无法归类,先检查分类条件是否足够明确,而不是立即增加很多细分层级。保留原始信息、记录修改原因,再选一个小范围重新核对,通常比盲目扩大处理范围更稳妥。

完成后再回看一次

最后按照原来的顺序检查数量、内容与位置,确认没有遗漏。把尚未完成的部分留在单独的待办清单中,下次从这里继续即可。这个方法强调可检查、可解释,不要求一次达到完美。

说明:文字由 AI 辅助整理,图片为自制方法示意。

可运行的小例子

items = ["alpha", "beta", "gamma"]
for index, value in enumerate(items):
    print(index, value)

先在本地观察输出,再对照上面的核对步骤理解每个字段。示例不读取外部文件,也不修改磁盘内容。

相关文章
|
2月前
|
人工智能 测试技术 Python
Python读取配置值时区分缺失和空字符串
Python读取配置值时区分缺失和空字符串,可以先从一组容易手工核对的小样本开始。把需要处理的对象、采用的方法和检查结果分别记录,能帮助我们发现遗漏。下面的步骤着重说明边界和复查方
Python读取配置值时区分缺失和空字符串
|
2月前
|
IDE 编译器 C语言
Dev C++下载安装教程-Windows零基础安装C语言编程软件完整步骤-5.11版图文详解与Hello World编译运行
Dev-C++ 是一款面向初学者的轻量级 Windows C/C++ 集成开发环境(IDE),免费开源、自带 MinGW 编译器,支持 C++98 至 C++17 标准。安装仅约 40MB,一键编译运行(F11)、中文报错、无需配置环境,特别适合教学、作业与算法训练。
403 1
Dev C++下载安装教程-Windows零基础安装C语言编程软件完整步骤-5.11版图文详解与Hello World编译运行
|
2月前
|
人工智能 JSON 安全
Windows 下 Claude Code 落地全指南:从安装配置到避坑优化
本文详解Windows下Claude Code的完整落地指南:涵盖WinGet/脚本/手动三种安装方式、对接阿里云Qwen等国内模型的配置、全界面与AI输出中文化、权限弹窗优化、长上下文卡顿(Stalled/Brewed)的性能调优,所有配置代码可直接复制使用,助你快速避坑、高效开发。(239字)
776 3
Windows 下 Claude Code 落地全指南:从安装配置到避坑优化
|
2月前
|
存储 NoSQL 安全
用 Java 接入大模型(五):多轮对话的上下文怎么管
本文深入剖析多轮对话的核心误区:大模型本身无记忆,所谓“遗忘”实为上下文管理失当。从messages结构化封装、token精准截断策略,到Redis会话存储与三步排错法,系统讲解如何可靠构建长程对话能力。
283 7
|
1月前
|
人工智能 自然语言处理 API
阿里云自研大模型清单:文本|多模态|图像视频|语音|向量模型一览
阿里云自研AI模型涵盖文本、图像、视频、语音及全模态,代表作通义千问Qwen系列(如Qwen3.8-Max/Flash、Qwen-VL、Qwen-Image等),法律、音乐、决策等垂直模型丰富,统一通过百炼平台提供API服务,支持免费额度试用。
282 1
|
2月前
|
数据采集 人工智能 搜索推荐
GEO和SEO到底有什么区别? 看了就知道
GEO与SEO本质不同:SEO优化搜索引擎,抢关键词排名;GEO优化AI大模型,争答案引用权。前者让用户“找得到”,后者让AI“信得过、提得到”。二者非替代,而是基建(SEO)与信任(GEO)的协同关系。(239字)
348 1
|
2月前
|
人工智能 自然语言处理
AI模型上下文长度是什么意思?AI 大模型 128k/256k/1M 到底有多强?一文讲透
上下文长度指大模型单次能处理的最大Token数(含输入+输出),决定其记忆与理解长文本能力。128K≈16万汉字,1M可达百万级,支持书籍、代码库等超长内容处理。在阿里云百炼官网:https://t.aliyun.com/U/fPVHqY 免费领取千万Tokens
465 3
|
2月前
|
人工智能 API 云栖大会
Qoder 协作能力升级,「项目」和「讨论」来了
Qoder 推出 Projects 与 Discussion 新功能,解决 AI 时代团队协作痛点:统一任务上下文、支持人与 Agent 共同讨论评审、自动同步执行结果,让协作围绕任务而非工具切换。
344 1
|
2月前
|
人工智能 缓存 自然语言处理
大模型AI对话前端应用实践:深度详解流式响应、工具调用状态与长会话同步落地方案24.1
本文深入解析AI对话式前端交互三大核心技术:流式响应(基于SSE逐字渲染)、工具调用状态展示(识别/执行/结果四阶段精细化UI)及长会话同步(虚拟列表+分段加载+前后端双向同步),覆盖实现原理、代码示例与异常兜底,助力构建高性能、高体验的AI应用。
256 2
|
1月前
|
人工智能 缓存 自然语言处理
阿里云百炼AI模型计费全解:按量付费、Token‑Plan、Coding‑Plan、节省计划四种方式指南
阿里云百炼AI模型提供四种计费方式:默认按量付费(Token计费)、Token Plan(订阅制,含个人/团队版)、Coding Plan(专为编程场景设计的月度请求包)及AI节省计划(承诺消费享最高5.3折)。开通即赠超7000万免费Tokens,助您低成本入门大模型应用。