「我改完自己试了几个问题,感觉没问题」不算发布记录:给每次 Prompt 上线留一份三段式报告
「这个拒答问题是什么时候开始的?」「上周订单确认率变好,是谁改了什么?」一场 Prompt 应用的线上效果复盘会,同样的问题五个人给出四版记忆:有人印象里是发版之后,有人记得那周只改了路由没动提示词,有人终于想起某个周二下午在后台改过一版——改了什么?没人记得。回滚?没有锚点。
这个画面几乎每天都在 AI 应用团队重演,根因只有一个:Prompt 是 AI 应用的事实源代码,却没享受过代码的发布待遇。代码变更有 PR、有评审、有流水线、有发布单;Prompt 常常是后台改完就生效——没有书面记录,没有回归对照,没有回滚阈值。于是效果问题的归因只能靠回忆,而回忆是有保质期的。这篇给出一份可以直接抄进下一次变更的三段式发布报告:变更台账 + 回归结论 + 回滚阈值。
一、审计结论摘要
审计对象是 Prompt 变更过程「零书面记录」这个状态,三条发现按风险从高到低。
第一,变更没有台账。生效内容、生效时间、改动动机全部散在聊天记录里。效果劣化时第一问「这版和上版差在哪」就答不出,属阻断级。
第二,回滚没有锚点。就算全员认定变差了,「回到哪一版」是第一个卡点——旧版本从未留档,只能靠记忆重建,重建出来的还不是原来的那一版。
第三,回归结论缺席或口径错误。最常见的形态是「我改完自己试了几个问题,感觉没问题」;即便有回归,用的也是绝对值口径——「拒答率低于 3% 就算过」,输入分布一变就误判。
建议动作四条:prompts/ 目录进 git 并强制 front-matter 元数据;CI 检测到 prompt 文件变更即自动关联对应场景回归任务、生成发布报告草稿;回归结论一律写「对照基线版本的相对变化」;回滚阈值一节不填不许合入。第三节给六小节模板,第四节给可运行代码。
二、为什么「后台改完就生效」不行
结论:后台直接生效省下的是每次二十分钟的填单成本,赔进去的是后面四个维度上按倍放大的成本。
| 对比项 | 后台改完就生效 | 三段式发布报告 |
|---|---|---|
| 效果归因 | 靠五人四版记忆,复盘会一半时间耗在「什么时候开始的」 | 每版留哈希、生效时间、改动动机,归因先查台账 |
| 回滚速度 | 旧版无锚点,回滚等于凭记忆重建,小时级起步 | front-matter 记好回滚锚点,切版是分钟级动作 |
| 交接审计 | 新人接手一个后台,不知每条规则为何而生 | 发布报告归档即交接文档,每条规则有出处 |
| 事故复盘产出 | 复盘完只剩一句「下次记得留文档」 | 复盘输入是一摞发布报告,输出是阈值修订 |
把它锚回你熟悉的东西:你从不敢在没有发布单的情况下改一行线上配置,因为配置影响代码分支、git 里可查;而 prompt 影响的是模型的行为分支,漂移空间只会更大。三段式报告的本质,是把代码早就有的三项基本待遇——版本化、变更记录、回滚路径——补给 prompt。
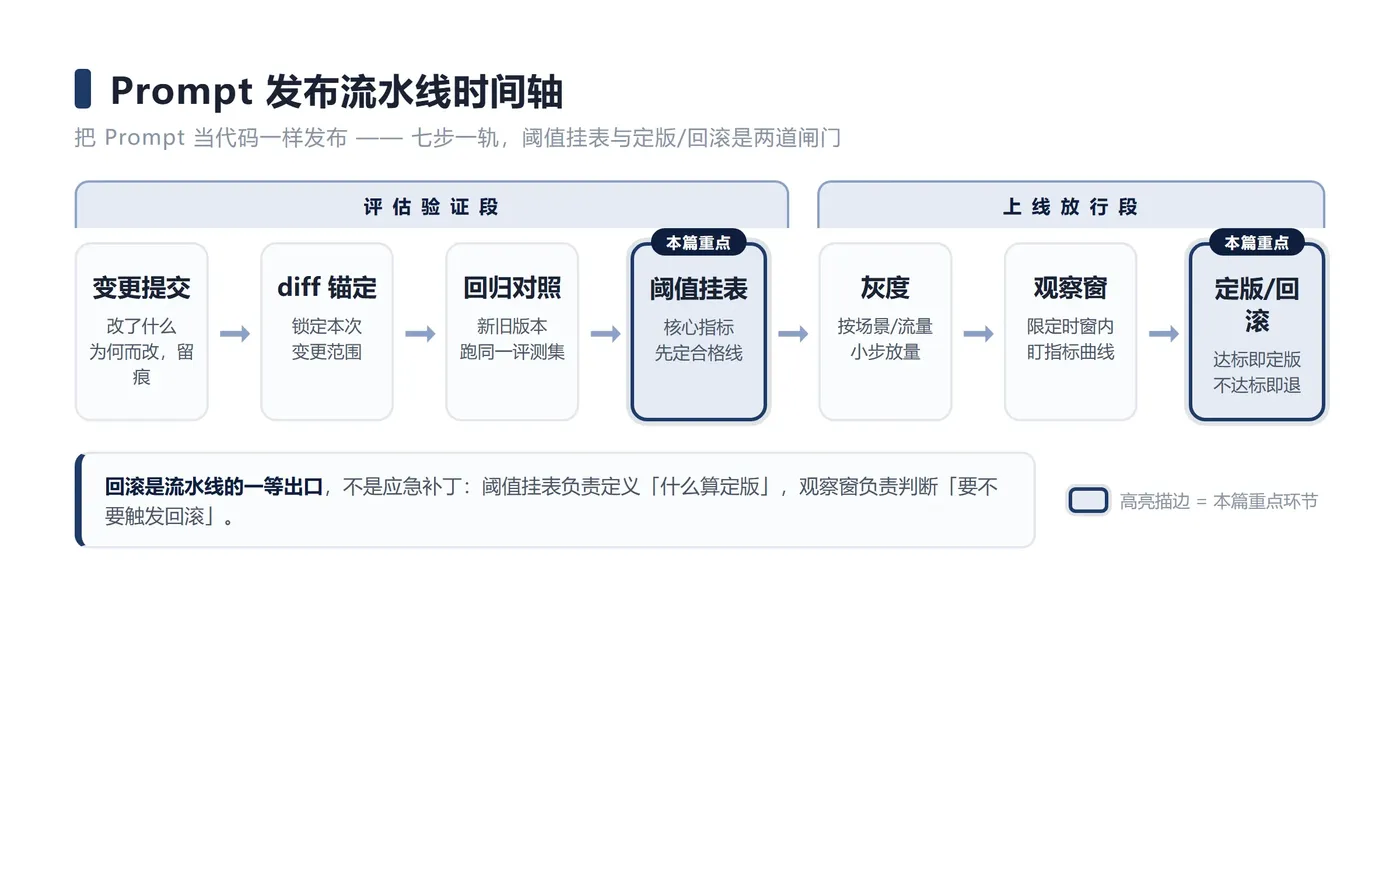
其中最容易被漏掉的是第四节:回滚阈值。多数团队补得起「改了什么」「跑了什么」两节,几乎没人写「哪些指标恶化到什么程度触发回滚、回到哪个版本、由哪个角色执行」。没有这一节,发布报告只是台账;有了它,才是引信。
三、六小节发布报告模板
结论:单次 Prompt 变更的发布报告固定六小节,填写目标控制在二十分钟内,其中回滚阈值一节必填,缺项不许合入。
| # | 小节 | 填写人 | 证据来源 | 5 分钟自检项 |
|---|---|---|---|---|
| 1 | 变更摘要:改了什么 / 动机 / 风险等级自评 | 变更发起人 | 需求单或缺陷单编号 | 两句话说清改动,不含「体验优化」空话? |
| 2 | 变更 diff:新旧 system prompt 的 sha256、版本号、影响的路由与场景清单 | 变更发起人 | prompts/ 目录 git diff | 两版哈希都记了?场景清单对照路由表核过? |
| 3 | 回归结论:跑了哪份场景用例清单、各指标对照基线版本的相对涨跌 | 测试执行人 | CI 回归任务链接 | 结论全是「对照旧版」口径而非绝对值? |
| 4 | 回滚阈值:哪些指标恶化到什么程度触发回滚 / 回到哪个版本 / 谁执行 | 变更发起人 + 测试执行人 | front-matter 的 rollback_anchor | 触发线、目标版本、执行角色三要素齐了? |
| 5 | 灰度与观测:先放多少流量、盯哪几个信号、观察窗多长 | 变更发起人 | 灰度配置页 + 监控面板链接 | 观察窗结束动作(定版/回滚/延长)写死了? |
| 6 | 签字与跟踪:发起 / 测试 / 评审三方确认,后续跟踪项带日期 | 三方签字人 | 报告归档位置 | 每条跟踪项都挂了日期? |
这张表的关键是「证据来源」一列:每一节都必须指向一个摸得着的东西——git diff、CI 链接、配置页——不允许存在靠「我记得」充数的节。这就是报告体和聊天记录的全部区别。
四、可运行实现:prompts 进 git,CI 把报告推到眼前
结论:报告不能靠自觉,要靠 CI 把它推到你面前——front-matter 不填,合入就失败。
第一段,prompts/ 目录下文件的 front-matter 元数据示例(正文之前加一段 YAML 头):
# prompts/refund_agent.md —— front-matter 示例
---
prompt_id: refund_agent
version: 12
status: canary                    # draft / canary / stable / rolled_back
effective_scope:
  routes: [refund_intent_route]
  scenes: [order_refund, refund_status_query]
regression_ref: tests/scenes/refund/      # 该场景的回归用例目录
baseline_version: 11
rollback_anchor:
  executor_role: on_call_release
  target_version: 11
  triggers:                       # 指标名与阈值为演示值
    - metric: refusal_rate
      rule: "对照 v11 相对涨幅 > 15%"
    - metric: order_confirm_success_rate
      rule: "对照 v11 相对跌幅 > 5%"
---
(此处往下是 prompt 正文,后台生效的永远只是这一段)
第二段,CI 检测 prompt 变更、校验元数据、自动生成发布报告草稿的脚本骨架:
"""
prompt_release_check.py —— 在 merge 前运行
用法:python prompt_release_check.py prompts/ origin/main
front-matter 缺必填项 → 退出码非 0,合入被拒。
"""
import hashlib, re, subprocess, sys
from pathlib import Path
import yaml

REQUIRED = ["prompt_id", "version", "effective_scope",
            "regression_ref", "baseline_version", "rollback_anchor"]

def changed_prompts(base_ref, prompt_dir):
    out = subprocess.run(["git", "diff", "--name-only", base_ref, "HEAD",
                          "--", prompt_dir],
                         capture_output=True, text=True, check=True).stdout
    return [Path(p) for p in out.splitlines() if p.strip()]

def front_matter(path):
    text = path.read_text(encoding="utf-8")
    m = re.match(r"^---\n(.*?)\n---\n", text, re.S)
    fm = yaml.safe_load(m.group(1)) if m else None
    body_sha = hashlib.sha256(text.split("---")[-1].encode()).hexdigest()[:12]
    return fm, body_sha

def draft(fm, body_sha):
    ra = fm["rollback_anchor"]
    trig = "\n".join(f"- {t['metric']}:{t['rule']}" for t in ra["triggers"])
    return f"""# 发布报告 {fm['prompt_id']} v{fm['baseline_version']} -> v{fm['version']}
## 1 变更摘要   TODO 改了什么/动机/风险等级
## 2 变更 diff   v{fm['version']} 正文哈希 {body_sha}
- 影响路由 {fm['effective_scope']['routes']} / 场景 {fm['effective_scope']['scenes']}
## 3 回归结论   运行 pytest {fm['regression_ref']} --baseline={fm['baseline_version']} 后贴链接
## 4 回滚阈值(必填)
{trig}
- 回滚目标 v{ra['target_version']},执行角色 {ra['executor_role']}
## 5 灰度与观测   TODO 流量比例/信号/窗口时长 + 窗末三选一动作
## 6 签字与跟踪   TODO 三方签字 + 带日期的跟踪项
"""

if __name__ == "__main__":
    blocked = False
    for p in changed_prompts(sys.argv[2], sys.argv[1]):
        fm, sha = front_matter(p)
        missing = [k for k in REQUIRED if not fm or k not in fm]
        if missing:
            print(f"[REJECT] {p} front-matter 缺: {missing}")
            blocked = True
            continue
        print(f"[PASS] {p}\n{draft(fm, sha)}")
    sys.exit(1 if blocked else 0)
第三段,回归结论的断言写法——相对口径,不是绝对值:
# test_refusal_rate_relative.py —— 新旧版对照拒答率(pytest)
import pytest

REL_TOLERANCE = 0.15          # 演示阈值:相对涨幅超 15% 即触发回滚讨论

def run_scene_suite(version, scene_dir):
    """用指定 prompt 版本重放同一份场景用例,返回
    {"refusal_rate": ..., "samples": n},harness 实现略。"""
    ...

@pytest.mark.parametrize("scene", ["order_refund", "refund_status_query"])
def test_refusal_rate_vs_baseline(scene):
    base = run_scene_suite("v11", f"tests/scenes/{scene}")
    cand = run_scene_suite("v12", f"tests/scenes/{scene}")
    assert base["samples"] == cand["samples"], "新旧版必须重放同一份用例文件"
    assert cand["refusal_rate"] <= base["refusal_rate"] * (1 + REL_TOLERANCE), (
        f"[{scene}] 拒答率 {base['refusal_rate']:.2%} -> "
        f"{cand['refusal_rate']:.2%},相对涨幅破线,进回滚讨论")
为什么这么写:断言里最关键的一行不是阈值比较,而是 samples 相等——相对口径必须建立在「同一份用例文件、同一天、新旧两版各重放一遍」上,基线版跑昨天的用例、候选版跑今天的,量出来的是流量分布变化而不是 prompt 变化。踩过的坑恰恰是绝对阈值:「拒答率必须小于 3%」写进报告后,赶上一次大促,长尾口语输入占比升高,拒答率自然爬到 3.4%,实际没人动过 prompt,却花了一周自证清白;换成对照基线版本的相对口径后,同样的场景读数会是「相对基线 +12%,未破 15% 触发线」,放进观察窗继续盯即可。rollback_anchor 与 CI 的 REQUIRED 校验卡的是同一件事:阈值没填不许上线——这种规则只能靠机器执行,靠自觉一定会在赶版本的那一周被漏掉。
五、四个落地细节
结论:模板是骨架,下面四个细节决定这份报告是活的还是仪式。
第一,diff 记哈希而不是「见 git」。报告里直接贴新旧两版 system prompt 的 sha256 截断值。后台生效的东西可以绕过 git,哈希是唯一能事后对账的身份证明——复盘时若某两版哈希相同,可以直接排除「prompt 变了」这个假设。
第二,影响场景清单必须每次对照路由表。front-matter 里的 scenes 是发起人以为的影响面,实际路由规则可能把它扩大。只有每次变更都把 effective_scope 与线上路由配置对一遍,「只改了退款话术怎么波及开票场景」才会写进报告而不是写进事故。
第三,观察窗要写结束动作。「灰度 5% 流量观察」只写了半句,最容易飘——三天后没人记得观察结束该干嘛。定版 / 回滚 / 延长一个窗口并注明理由,三选一当场写死。
第四,跟踪项带日期而不是「后续跟进」。第六节的「补齐场景用例」「修订阈值」若不挂日期,到下次复盘时又会变回记忆。
六、三条决策建议
- 建议 A:从下一次 Prompt 变更起启用第四节脚本,front-matter 与报告草稿强制化,代价是每次变更多花约二十分钟,收益是「什么时候开始的 / 谁改了什么 / 回滚到哪版」三问不再需要开会回答。
- 建议 B:先给现有高频变更的 prompt 补齐回滚锚点——把当前线上生效版本冻结留档并记哈希,哪怕报告制度后置,先消灭「想回回不去」的状态。
- 建议 C:维持后台改完即生效,接受下次复盘继续靠记忆对账;若本文提交后一周内无决策,默认滑向 C。
一份没有回滚阈值的发布报告,只是事后日记;一份没有变更台账的回归结论,只是无根浮萍。
Prompt 改一个字,只要它影响线上效果,就是一次发布;没有发布报告的上线,全都是裸奔。