
工作十几年,从早年的SSH架构到现在的Spring Cloud微服务、大模型Agent开发,日常工作的核心从来没变过:用最少的时间交付高质量的代码。但现实是,大部分工作日都消耗在机械性重复里——写重复的CRUD代码、翻几十页代码找架构逻辑、对着Git冲突改半小时、代码评审翻来覆去查规范、线上bug定位半天找不到根因。
接触WorkBuddy大半年,试过近三十个开发者向Skill,踩过“功能花哨但没用”“安装后再也没打开过”的坑,也找到了几个真正能嵌入日常开发流程、每天都要用的技能。很多人装Skill喜欢求多求全,实际上真正能提升效率的,永远是贴合你技术栈、匹配你工作流的那几个。
这份清单完全站在后端开发者视角,结合我自己Java项目开发、大模型Agent落地的日常工作筛选,每个技能都经过至少十个项目的实战验证,覆盖从项目初始化、编码、评审、测试、排障到部署的全流程。
1. springboot-scaffold:Java 后端项目的快速启动器
安装名:springboot-scaffold核心定位:一键生成符合工业规范的Spring Boot分层项目骨架,从零到可开发只需要30秒。
后端开发里60%以上的新项目,本质都是“Web接口+数据库CRUD+基础组件”的标准结构。每次从零搭建都要重复做一遍:建Maven模块、引依赖、写配置类、分层包结构、加通用返回类、全局异常处理、接口文档集成。这些工作没有技术门槛,但全做对至少要半小时,还容易漏配置、结构不规范。
这个Skill把Spring Boot项目的最佳实践封装成了标准化生成流程,内置了主流的技术栈组合:Spring Boot + MyBatis-Plus + MySQL + Redis + Swagger/Knife4j,严格按照controller/service/dao/entity/common的分层结构生成,连参数校验、统一返回结果、分页封装、跨域配置这些细节都提前做好了。它生成的不是零散的代码片段,是可以直接导入IDE运行的完整项目结构,所有依赖版本都经过兼容性验证,不会出现启动报错的问题。
实战场景: 之前接了一个内部管理系统的需求,要做一个部门人员的增删改查接口,带分页查询和条件筛选。放在以前,我得先建Maven项目,在pom.xml里挨个加依赖,写application.yml配置文件,建实体类、Mapper接口、Service实现类、Controller,再加上统一返回体、全局异常处理、参数校验,一套下来少说一个半小时,还经常忘加某个注解导致启动失败。
现在只需要对着WorkBuddy说一句: “用springboot-scaffold生成一个人员管理的Spring Boot项目,技术栈用Spring Boot 3.2 + MyBatis-Plus 3.5.5 + MySQL 8.0,包含部门和员工两个实体,部门和员工是一对多关系,支持分页查询、多条件筛选、参数校验,接口用Knife4j生成文档,数据库表名用tb_前缀”
不到30秒,完整的项目结构就生成好了,连数据库建表SQL、Mapper.xml、基础CRUD方法都顺带生成了。直接导入IDEA,改一下数据库连接地址就能启动,剩下的时间只需要写具体的业务逻辑就行。
使用心得: 很多人觉得脚手架生成的代码太死板,不适合复杂项目。我的用法是:基础骨架用它生成,复杂业务逻辑自己写。哪怕是微服务项目,每个服务的基础结构也是通用的,用这个Skill生成基础层,能省掉大量重复劳动,还能保证团队项目结构统一,新人接手不用再熟悉不同的包结构。
生成的时候一定要指定JDK版本、Spring Boot版本和ORM框架,默认版本可能和你项目的技术栈不匹配,提前说清楚能省掉后续改依赖的时间。另外可以把团队的自定义规范加进去,比如统一的异常码、日志格式、工具类,让生成的代码直接符合团队标准。
2. code-review:你的专属代码评审专家
安装名:code-review核心定位:基于行业最佳实践,对代码变更做全维度质量检查,把好代码提交前的最后一关。
很多团队的代码评审流于形式,要么没时间细看只扫一眼格式,要么每个人评审标准不一样,吵半天没结论。这个Skill的底层逻辑,是把业界公认的代码评审标准固化成了检查清单,从四个维度做结构化审查:代码质量、安全性、性能、可维护性,每个维度都有明确的检查项,不会凭主观感觉下结论。
根据WorkBuddy官方文档的定义,它的评审覆盖点非常具体:命名规范、代码复杂度、重复代码、SQL注入风险、XSS漏洞、权限校验、算法效率、资源使用、缓存策略、注释完整性、模块设计、测试覆盖率。输出的结果也很清晰:优点、问题、改进建议,按优先级排序,每个问题都标清楚文件和行号,还给具体的修改示例,不是空泛地说“这里写得不好”。
实战场景: 每次提交代码前,我都会让它先扫一遍本次变更的diff。比如上次写了一个用户查询的接口,自己觉得逻辑没问题,格式也规范,结果它直接指出三个问题:
- 接口没有做参数长度校验,用户名字段如果传入超长字符串会导致数据库报错,还存在恶意传参风险(安全问题,P1级)
- 查询方法没有加缓存,高频请求会直接打库,高峰期容易把数据库拖慢(性能问题,P2级)
- 方法名用了getUserInfo,不符合团队“动词+名词”的命名规范,应该用queryUserInfo(代码质量,P3级)
顺着它的建议改完,再提交到团队评审,基本不会再有基础问题,评审效率提升了至少一半。以前评审要花半小时找格式、规范问题,现在只需要聚焦业务逻辑本身。
使用心得: 不要等写完所有代码再评审,写完一个模块就审一次,问题早改成本低。可以在SKILL里加上团队自己的编码规范,比如命名规则、异常处理要求、日志打印规范,让它按照你们团队的标准来审,比人工评审统一得多。
另外要明确,它只能查出规则性问题,业务逻辑的合理性还是要人来判断,别完全依赖它做最终评审。我的习惯是:先用它做第一遍初审,解决所有基础问题,再提交给团队做业务评审,把人的时间花在更有价值的地方。
3. mcp-builder:大模型时代的工具扩展神器
安装名:mcp-builder核心定位:把你的内部系统、数据库、API快速封装成MCP服务,让AI Agent可以直接调用,打通大模型和业务系统的最后一公里。
做过大模型Agent开发的人都知道,最大的痛点不是模型本身,是工具调用。想让大模型操作你的数据库、调用你的内部接口、查你的监控系统,要么得写一堆函数调用逻辑,要么得对接各种协议,调试起来特别麻烦。每个工具都要单独写适配代码,换个模型又要改一遍,重复性工作极多。
MCP(Model Context Protocol)是现在AI工具调用的标准化协议,而这个Skill就是把MCP服务的开发流程全部简化了——不用写完整的服务代码,只需要描述你要暴露的工具、输入输出参数、权限控制,它就能生成完整的MCP Server,还自带接口文档、鉴权、流量控制、日志监控这些能力。生成的服务符合MCP标准,可以接入任何支持MCP的AI Agent,不用重复适配。
实战场景: 我手上有一个医疗项目的后台数据库,以前想让大模型查数据,得自己写查询接口、做参数校验、处理返回格式、加权限控制,一套下来两三天,还经常有SQL注入的风险。
用mcp-builder,只需要告诉它: “封装一个MySQL查询的MCP服务,连接twinbee_medical数据库,只允许查询患者表、医嘱表、检查报告表,禁止任何写入操作,限制单次查询最多返回100条,查询条件必须带时间范围,禁止全表扫描”
十几分钟就能生成可运行的MCP服务,接入WorkBuddy之后,直接用自然语言就能查数据:“帮我查一下昨天入院的患者人数,按科室分布,再统计一下平均住院天数”。它会自动生成合规的SQL、调用MCP服务、返回结构化的统计结果,比自己写SQL快太多,还不用担心写错删改数据,也不用担心SQL注入。
使用心得: 这是我认为最适合后端开发者拥抱大模型的技能。以前我们写代码是给人用,以后越来越多的代码是给AI Agent用的。把内部系统封装成MCP服务,相当于给你的业务系统开了一个AI原生的接口,后面做智能运维、智能客服、数据查询、自动化运维都能用。
注意权限控制一定要做严,尤其是涉及数据库的服务,只读权限就够了,千万别开写入权限,避免AI误操作改数据。另外要加流量限制,防止高频调用把业务系统打挂。
4. tdd:用测试驱动代码质量
安装名:tdd核心定位:严格遵循“红-绿-重构”的测试驱动开发流程,倒逼你写出可测试、低耦合的代码。
很多后端开发者写代码的习惯是先写功能,再补测试,最后测试用例都是为了凑覆盖率,根本测不出问题。上线后出bug,才发现边界条件根本没考虑到。TDD的逻辑反过来:先写测试用例,定义清楚功能的边界和预期结果,再写刚好能通过测试的代码,最后再重构优化。
这个Skill就是把TDD的流程固化成了强制步骤,不会让你跳步。每次开发一个功能,它会先引导你拆解需求、识别边界条件、写单元测试,测试跑不通过(红),再写实现代码让测试通过(绿),最后再做代码重构优化结构(重构),全程跟着走就行。它还会提醒你哪些分支没覆盖到,逼着你把所有场景都考虑到。
实战场景: 开发一个订单金额计算的功能,涉及满减、折扣、运费三种计算规则,还有各种叠加限制。要是以前直接写代码,很容易漏边界条件,比如满减和折扣能不能叠加、运费的起步价是多少、退款时金额怎么倒算。
用TDD的流程,先拆解需求,写测试用例:
- 正常订单,无任何优惠,金额和运费计算正确
- 满足满减条件,订单金额扣减正确,运费正常计算
- 使用折扣券,和满减叠加逻辑正确(先折扣后满减)
- 订单金额为0,运费收取起步价
- 异常参数(负数金额、不存在的优惠券),抛出对应异常
- 部分退款,优惠金额按比例分摊
写完所有用例,跑一遍全红,再一步步写实现代码,每个用例逐个转绿。全部通过之后,再去优化代码结构,提取公共计算方法,抽取出策略模式。最后出来的代码,测试覆盖率100%,边界条件全覆盖,上线后几乎没出过bug。
使用心得: 不要觉得TDD浪费时间,越复杂的业务逻辑,用TDD越省时间。前期写测试花的时间,后期改bug的时间能省好几倍。而且TDD倒逼你写可测试的代码,耦合度会低很多,后续维护也方便。
对于简单的CRUD接口,不用严格走完整流程,可以简化成“先写接口定义,再写实现,最后补测试”,灵活调整。配合spring-boot-starter-test用,生成的测试用例直接符合Spring Boot的测试规范,不用自己再搭测试环境。
5. github:Git 工作流的全自动助手
安装名:github核心定位:覆盖GitHub全操作场景,从提交、分支管理到PR、Issue处理,不用记命令,一句话就能完成。
后端开发者每天都要和Git打交道,但很多人只会commit、push、pull这几个基础命令,遇到变基、拣选、回滚、处理PR就头疼,查命令都要半天,还经常敲错参数导致代码出问题。尤其是多人协作的项目,Git操作不规范很容易搞乱分支。
这个Skill相当于把Git和GitHub的所有操作都封装成了自然语言接口,不用记复杂的命令参数,直接说你要做什么,它就能执行对应的操作,还会提前告诉你操作的影响,给出执行预览,避免误操作。从日常的提交代码、创建分支,到复杂的变基、回滚、拣选,再到PR评审、Issue管理,基本覆盖了99%的开发场景。
实战场景: 上周线上出了个bug,需要从主分支回退到上一个版本,还要把修复的代码拣选到开发分支,同时同步到三个环境分支。放在以前,我得查一下git revert和git cherry-pick的参数,生怕搞错了提交号,还要挨个分支操作,半天都不一定能弄完。
现在直接说: “帮我回退main分支上最新的一次提交,生成revert提交,不要直接重置。然后把提交号为a1b2c3d的修复提交拣选到dev、test、pre三个分支,每个分支拣选完都推送到远程”
它会先列出操作的具体内容和影响范围,确认无误后自动执行,完了还会告诉你执行结果和后续注意事项,比自己敲命令稳多了,也省了很多切换分支的时间。
还有PR评审的时候,不用打开网页一个个看文件,直接让它“总结一下#142号PR的改动,重点看数据库相关的变更和接口入参变化”,它会直接拉取diff,给你结构化的总结,哪些文件改了、改了什么、可能有什么风险,省了很多切换页面的时间。
使用心得: 日常开发用它足够了,基本覆盖99%的Git操作场景。但涉及到强制推送、重置主分支这种高危操作,一定要让它先给出操作预览,确认没问题再执行,别直接让它自动执行。
另外,团队的Git工作流规范(比如分支命名、提交信息格式、合并策略)可以配置进去,比如要求提交信息必须是“feat: 新增xxx功能”“fix: 修复xxx问题”的格式,它会自动帮你检查和规范,不用每次评审都纠正格式问题。
6. diagnosing-bugs:线上问题的结构化排查专家
安装名:diagnosing-bugs核心定位:针对代码bug和线上异常,用系统化的排查流程定位根因,给出修复方案,而不是只治表面症状。
后端开发者最头疼的就是排bug:报错信息看不懂、堆栈信息太长找不到重点、偶现问题没法复现、改了表面问题根因还在。很多人排bug全靠经验瞎试,试半天找不到问题,越改越乱,最后还不知道为什么修好的。
这个Skill的底层逻辑是标准化的故障排查方法论:先捕获错误信息和堆栈,再梳理复现步骤,接着定位故障点,然后分析根因,给出最小修复方案,最后验证效果和预防建议。不是上来就瞎改代码,而是一步步推导,逻辑非常清晰,每一步都有依据。它不会只告诉你“改这里就行”,还会告诉你为什么会出这个问题、以后怎么避免。
实战场景: 有个线上接口偶发超时,看日志就是请求响应慢,没有明显报错,高峰期出现的概率更高。我把错误日志、接口代码、最近的变更记录都丢给它,它按流程一步步排查:
- 先分析堆栈信息,发现耗时主要在数据库查询环节,应用本身逻辑没问题
- 检查对应的SQL语句,发现查询条件是两个字段组合查询,没有建联合索引,只建了单字段索引
- 再看数据量,用户表已经到百万级,条件过滤后还是要扫描大量数据,高峰期数据库负载高就会超时
- 最后给出完整方案:给查询字段加联合索引,同时给这个接口增加Redis缓存,缓存时间5分钟
- 附带预防建议:对所有高频查询接口做索引检查,超过10万数据的表必须有合适的索引
按照它的方案加完索引和缓存,接口响应时间从2秒降到了20ms以内,后续也没再出现超时问题。
使用心得: 排bug的时候,给的信息越多越准,最好把错误堆栈、相关代码、最近的变更记录、监控数据都给它。如果第一次排查不对,把新的现象告诉它,它会调整排查方向,比自己瞎试效率高太多。
但要注意,它只能分析代码和日志层面的问题,如果是基础设施的问题(比如网络波动、服务器资源不足、中间件故障),它是查不出来的,得结合监控系统一起看。我的习惯是:先让它排查代码层面的问题,排除了再去查基础设施。
7. zoom-out:陌生代码库的快速导航仪
安装名:zoom-out核心定位:一键生成代码库的高层架构图,梳理模块关系、调用链路、数据流向,快速看懂一个新项目。
接手老项目、研究开源代码、做架构评审,第一步都是先搞懂整体架构。以前的做法是翻文档、找入口、顺着调用链一点点摸,少则两三天,多则一周才能理清楚脉络。遇到文档不全的老项目,只能靠读代码猜架构,非常痛苦。
这个Skill做的事情,就是代替你做这个“通读代码理架构”的过程。它会深度扫描整个代码库,识别分层结构、核心模块、依赖关系、数据流向,最后输出一张分层架构图,而不是简单的文件树。你能一眼看清楚:哪层是接口层、哪层是业务层、数据层有哪些组件、模块之间怎么调用、关键入口在哪里。
实战场景: 接手了一个维护了五年的老项目,代码十几万行,文档早就不全了,之前的负责人也离职了。没人说得清整体架构,只知道能跑。我把项目文件夹丢给它,说“帮我梳理这个项目的整体架构,输出分层架构图,标注核心模块、关键入口和技术栈,重点说明数据层和消息队列的使用方式”。
大概十分钟,它就输出了完整的架构分析:
- 整体是经典的三层架构:表现层(Controller)、业务层(Service)、数据访问层(DAO)
- 核心模块有用户管理、订单管理、支付管理、库存管理四个
- 数据层用了MyBatis,二级缓存用Redis,消息队列用RabbitMQ做异步解耦
- 关键入口是controller包下的各个REST接口,定时任务在task包,MQ消费者在listener包
- 存在的架构问题:部分业务逻辑耦合在Controller层,没有抽离到Service
跟着架构图再去看具体代码,目标非常明确,一下午就把项目脉络摸清楚了,放在以前至少要三天。
使用心得: 看代码先看全局,再钻细节,效率会高很多。不要上来就扎进某个具体的方法里,先用zoom-out看清楚整体架构,知道你要改的代码在哪个位置、影响哪些模块、上下游是什么,再动手改,改出问题的概率会小很多。
对于特别大的项目,可以指定只扫描某个模块,不用全量扫描,速度会快很多。另外它生成的架构图可以导出,做项目交接、架构评审的时候直接用,省得自己画图。
8. skill-creator:把你的经验沉淀成可复用的能力
安装名:skill-creator核心定位:不用写代码,用自然语言描述你的重复工作流,就能生成专属的自定义Skill,一次配置,永久复用。
每个开发者都有自己的工作习惯和高频重复操作,比如我每次写完接口,都要做一遍:检查参数校验、加操作日志、写接口注释、更新Swagger文档、生成测试用例骨架。每次都要重复一遍,虽然不难,但很琐碎,忙起来还容易漏项。
这个Skill的作用,就是把你这些固定的流程封装成一个专属技能。你只需要描述清楚:什么时候触发、做什么事情、输出什么结果、有什么规则,它就能生成一个完整的Skill文件,以后一句话就能调用,AI会严格按照你定义的流程执行,不会漏步骤,也不会走样。
实战场景: 我把自己的“接口开发收尾流程”做成了一个自定义Skill,触发词是“接口收尾”。每次写完接口代码,只要说一句“对UserController做接口收尾”,它就会自动按顺序执行:
- 检查所有接口的参数校验注解是否完整,必填字段有没有加@NotBlank,数值有没有加范围限制
- 给每个方法加上操作日志和异常日志,日志格式符合团队规范
- 补全接口注释和参数说明,确保Swagger文档能正常生成,没有遗漏字段
- 生成对应的单元测试用例骨架,包含正常场景和异常场景
- 最后做一遍代码格式优化,导入排序整理
整个过程十几秒完成,比自己手动做快十倍,还不会漏项。做好之后我把这个Skill分享给团队,大家都用统一的流程做接口收尾,代码规范度提升了很多。
使用心得: 这是真正能拉开效率差距的技能。别人用Skill是用别人做好的,你可以自己造适合自己的Skill。越高频、越标准化的流程,越值得做成自定义Skill。一次投入,永久受益。
刚开始不用做太复杂的,先从简单的小流程开始,比如代码格式化、提交信息生成,慢慢再做复杂的工作流。做好的Skill还可以分享给团队,让大家都用统一的标准做事,减少沟通成本。
9. resolving-merge-conflicts:Git 冲突的高效解决专家
安装名:resolving-merge-conflicts核心定位:自动分析Git合并冲突的上下文,给出安全的解决方案,不用手动对着冲突标记改半天。
Git合并冲突是每个开发者都逃不开的痛点,尤其是多人协作的项目,改同一个文件的同一端代码太常见了。很多人解决冲突就是简单选“保留我的”或者“保留别人的”,很容易把别人的代码覆盖掉,导致功能异常,上线后出问题都不知道为什么。
这个Skill会先分析冲突两边的代码逻辑,理解各自的修改意图,然后给出合并方案。不是简单的二选一,而是尽可能把两边的修改都保留下来,逻辑冲突的地方会明确标出来,告诉你为什么冲突、应该怎么改比较合理,还会提醒你哪些地方需要人工确认,不会自作主张改业务逻辑。
实战场景: 上周和同事同时改了用户服务的业务层,我加了积分计算逻辑,他加了会员等级判断,还有几处都改了同一个方法的参数,合并的时候十几处冲突。放在以前,我得逐行看两边的修改,慢慢合并,还要理解对方的代码逻辑,少说二十分钟,还容易改错。
把冲突文件丢给它,一分钟就给出了合并方案:大部分代码都自动合并了,只有一处逻辑冲突——积分计算的基数和会员折扣的顺序问题,它标注出来并建议“按照业务规则,先计算会员折扣,再用折扣后的金额计算积分”,还给出了修改后的完整代码示例。
我确认了一下逻辑,和产品规则一致,直接用它的方案,五分钟就解决了所有冲突,合并完测试一遍就过了,没出任何问题。
使用心得: 简单的文本冲突、配置文件冲突它处理得很好,基本不用改。涉及到业务逻辑的冲突,一定要人工确认一下,它只能给出建议,最终逻辑对不对还是要人来判断,别直接全量应用。
养成小步提交的习惯,每次提交改动少一点,冲突的概率和难度都会小很多,也更容易合并。另外合并前先拉取最新代码,在本地解决完冲突再推送,别把冲突提交到远程分支。
10. cloudbase:后端服务的快速部署验证工具
安装名:cloudbase核心定位:一站式后端云服务,从数据库、云函数到部署上线全搞定,快速验证业务原型,不用搭服务器配环境。
很多时候我们想快速验证一个想法,比如做一个小工具、一个简单的后端服务、一个内部用的管理页面,要是从零搭服务器、配环境、装数据库、部署,大半天就过去了,等搭完想法都凉了。对于产品原型验证,速度比完美更重要。
CloudBase是腾讯云的一站式后端云服务,这个Skill把整个开发部署流程都打通了。你只需要说需求,它会自动生成前端页面、后端逻辑、数据库表,然后一键部署到公网,生成可访问的链接,全程不用管服务器、域名、运维这些事。从想法到可访问的原型,最快十几分钟就能搞定。
实战场景: 产品想验证一个用户反馈收集的功能,要做个简单的表单页面,提交的数据存到数据库,后台能看列表,还要有导出功能。要是按以前的流程,搭环境、写接口、写前端、部署,至少一天,还得专门开个测试环境。
用cloudbase,直接说: “做一个用户反馈表单页面,包含姓名、联系方式、反馈类型、反馈内容四个字段,提交后存到数据库,做一个简单的后台列表页能查看所有反馈,支持按时间筛选和导出Excel,部署成可访问的公网链接”
大概二十分钟,全套都做好了,直接给了我公网访问地址和后台管理地址。产品拿去测试,有问题直接改,半天就验证完需求了,效率提升不是一点半点。验证通过之后,再用正式的技术栈重构,也不会浪费太多时间。
使用心得: 它特别适合做原型验证、内部工具、小型项目,快速上线快速迭代。正式的大型项目还是用传统的架构更稳妥,可控性更强。
部署完记得改默认的权限配置,别让任何人都能改数据,尤其是涉及到用户信息的场景,一定要加登录校验和权限控制。另外重要数据记得定期备份,云服务虽然稳定,但也不能完全依赖。
技能组合:打造你的后端开发高效工作流
单个技能只是工具,把它们串起来形成完整的工作流,才能发挥最大的价值。我自己日常的开发流程是这样的:
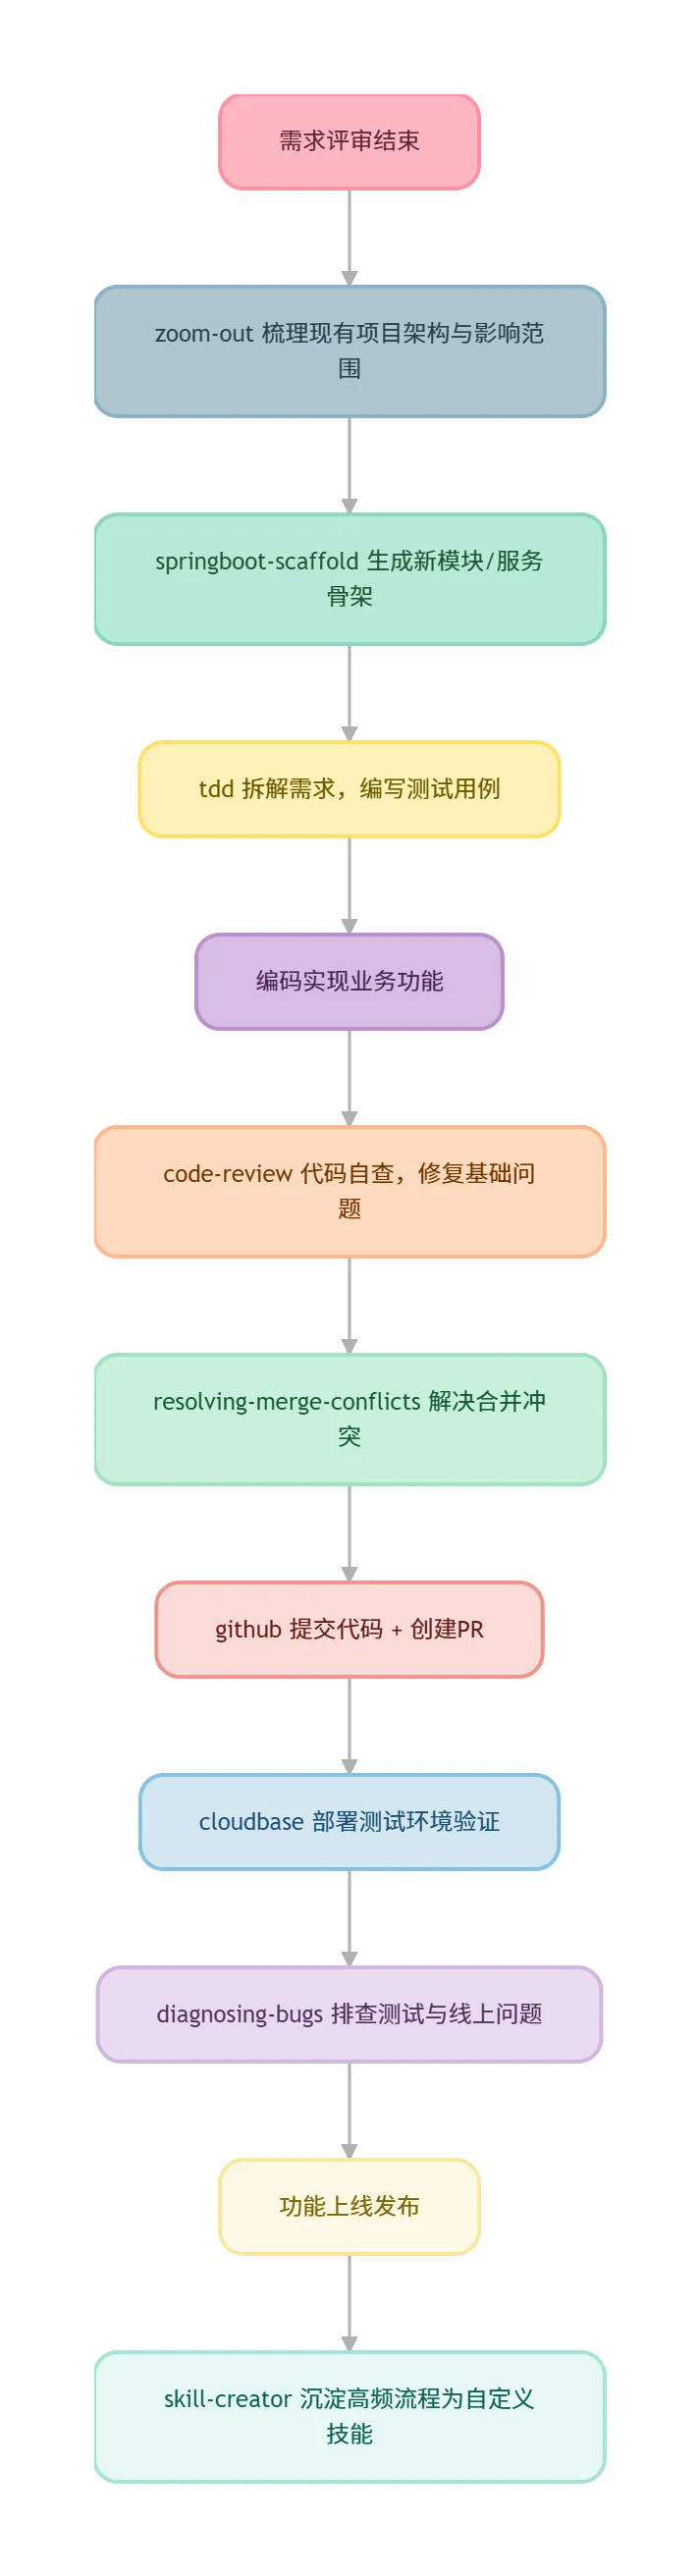
这套流程跑下来,从需求到上线,每个环节都有对应的技能辅助,机械性工作占比从60%降到了20%,剩下的时间都可以花在业务逻辑和架构设计上。以前一周才能做完的需求,现在三四天就能交付,质量还更高。
写在最后:用好技能,但别依赖技能
用了这么多Skill,最深的感受是:它们是效率放大器,不是能力替代品。
你懂架构,zoom-out才能帮你更快理清架构;你懂代码质量,code-review才能帮你查出真正的问题;你懂业务逻辑,TDD才能帮你写出合理的测试用例。技能帮你省掉的是重复劳动的时间,让你有更多精力去做更有价值的思考,而不是代替你思考。不要为了装技能而装技能,先把自己常用的两三个用透,比装几十个从来不用的强得多。也别完全依赖技能,核心的技术能力还是要自己练,工具永远是辅助,真正的底气还是你的技术功底。
如果你也是Java后端开发者,建议先装springboot-scaffold、code-review、github这三个,日常用得最多,见效也最快。然后再根据自己的工作场景慢慢补充,找到最适合自己的组合。毕竟,工具的终极意义,是让我们从繁琐的重复劳动里解脱出来,把时间花在真正能创造价值的事情上。




