
物料生产线上,图像生成的卡点在文字
百炼的 IG(图像生成)能力下挂着十个模型族,从 z-image-turbo、qwen-image-3.0 系列,到 wan-text-to-image、qwen-mt-image。选型时大家通常看两样东西:官方模型描述和单价。
但把生图接进公众号封面、活动海报、价目表这条物料线之后,真正决定这张图能不能发的是第三样:图里那些带日期、价格、法务句的中文小字,出来对不对。"AI 会画画"早就不是问题,"画出来的字能直接用"才是。
我用同一份 prompt 在三档主力模型上各跑两遍,逐处放大核字,把结果按档位、耗时、单价整理成一张可复算的账。命令签名以本机 bl 1.22.0 的 --help 输出为准,单价取自 bl model list 的实时返回,不是抄评测文。
一、模型矩阵与计价口径
| 模型 | 单价(每张) | 定位 |
|---|---|---|
z-image-turbo |
¥0.1 | 官方模型说明称在 Artificial Analysis 文生图开源模型里排第一,60 亿参数、8 步推理 |
qwen-image-3.0 |
¥0.18 | 1K 与 2K 同价,主打密集信息排版 |
qwen-image-3.0-pro |
¥0.25(1K)、¥0.5(2K) | 同族 Pro 档,强化复杂排版与文字渲染 |
那句"排第一"是官方 description 字段的原话,我没有去独立复核那张榜单,往下引用时请留意口径。三档之间价差 2.5 倍,速度差 20 倍,这两个倍数后面都会落到实测数字上。
二、实测设计:把变量压到只剩 --model
控制变量这件事得先交代,否则后面所有百分比都是空的。
两份 prompt。第一份是活动海报:主标题、副标题、三行带数字的要点、一行含日期时间地点的页脚小字,共 10 处文字要素。第二份把信息密度拉满:会员权益说明,标题副标题加五行要点,页脚两行小字,其中一行是日期区间,另一行是"最终解释权归杭州西湖文化广场门店所有"这种法务句,还塞了个 1:1.5 的小数,共 9 处要素。
每份 prompt 在三档上各跑一次,只改 --model,其余全部走 CLI 默认(--watermark 默认 true、--prompt-extend 默认 true,这正是多数人的真实用法)。评分是笨办法:把 prompt 要求的每一处文字在图里找出来,放大,逐字核对,记 正确 / 错字 / 缺笔 / 串字 / 缺失。
环境只装一样东西:
npm install -g bailian-cli
装完 百炼 CLI(bl) 就能用。查单价和查参数都不消耗额度:
bl model list --capability IG
bl image generate --help
三、第一轮:三档全对,区分度落在速度与水印
第一份海报 prompt 跑完,三张图并排放大逐处核,结果三档都是 10/10。主标题、副标题、三行要点的数字、页脚日期时间地点,一处没错。"中文小字普遍乱码"这个印象,在这三档的当前版本上已经不成立。
| 模型 | 实测耗时 | 10 处要素 | 水印表现 |
|---|---|---|---|
z-image-turbo |
5.1s | 10/10 | 右下角干净 |
qwen-image-3.0 |
101.1s | 10/10 | 右下角出现被画面边缘裁切的橙色角标,只剩"生成"二字的一半 |
qwen-image-3.0-pro |
53.8s | 10/10 | 同位置干净 |
两个反直觉的点。一是速度:最贵的 Pro 比中间档的 Standard 快一倍,跟"越贵越慢"的直觉相反。二是水印:同一组参数下两档行为不一致,Standard 那个被裁掉一半的角标在对外物料上是硬伤。
水印开关是管用的。我单独跑了一次加 --watermark false,角标消失,文字仍 10/10。批量出对外物料时这个 flag 建议显式写上,别依赖默认值。
四、第二轮:字号压到页脚,差别出来了
第一轮的字还是偏大,真正考验渲染的是页脚小字,尤其是数字和长句子。第二份 prompt 的结果分出了胜负。
| 模型 | 实测耗时 | 9 处要素 | 错误明细 |
|---|---|---|---|
z-image-turbo |
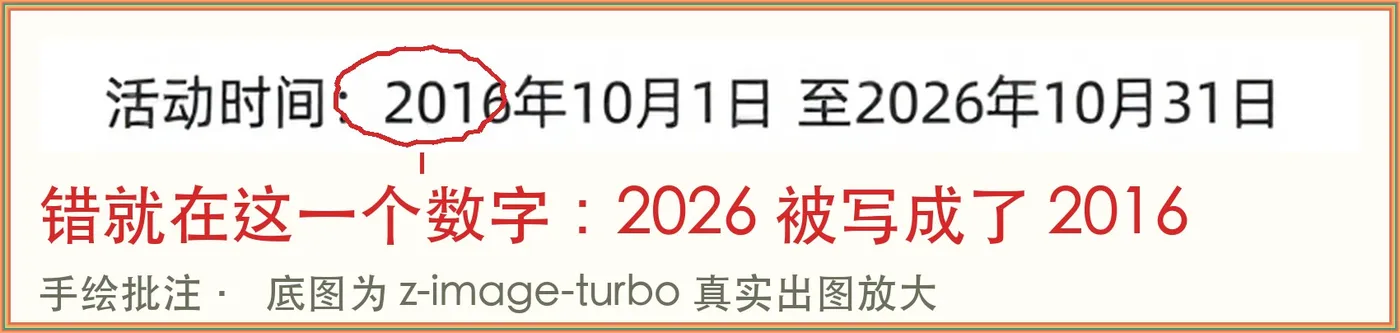
5.1s | 8/9 | 页脚要求"活动时间:2026年10月1日 至 2026年10月31日",它把开头写成了 2016年10月1日,单个数字 2 变 1;其余 8 处全对,含 1:1.5 与法务句 |
qwen-image-3.0 |
112.4s | 9/9 | 无,日期区间与法务句逐字正确 |
qwen-image-3.0-pro |
81.8s | 9/9 | 无,同上 |
两轮合计:turbo 18/19(94.7%),Standard 19/19,Pro 19/19。
这个错法值得单独说。它不是乱码,不是缺笔画,是一个看起来完全正常的数字。整张海报扫一眼,构图对、标题对、要点对,没人会停下来盯页脚那行小字里的年份。但这是一张要发出去的促销图,日期错一年是运营事故,不是美观问题。
对企业侧的含义很直接:便宜和快是真的,5 秒对 101 到 112 秒,¥0.1 对 ¥0.18 到 ¥0.25;代价是 5.3 个百分点的正确率,且只体现在最小字号的数字上。这笔账能算清,也能靠流程兜住。
五、翻车之后:两条补救路径的边界
看到 turbo 把 2016 写错,我第一反应是别重跑,改一下就行,于是试了 bl image edit:
bl image edit --image turbo那张图.png --prompt "把页脚第一行小字里的「2016年10月1日」改成「2026年10月1日」,其他所有文字、排版、配色保持完全不变" --model qwen-image-3.0
结果一半好一半坏。好的是字改对了,页脚两行全部正确,2026 回来了,法务句没动。坏的是图没保住:原图是一张有插画、有人物、有配色的海报,edit 出来的是纯文字白底版式,插画和颜色全没了。它确实改了字,但顺手把整张重绘了。
所以 edit 的适用边界是:文字为主的图(白底黑字的权益说明、价目表)改字很好用;插画为主、只想动一行字的图,别指望它保住原画,拿原 prompt 用 Standard 或 Pro 重跑更稳。
另一条我以为能用的路是固定 --seed 复现同一张图。实测不是。同模型、同 prompt、同 seed 42,只改了水印开关,两次出来的构图完全不同。--seed 在这条链路上不是复现按钮,它顶多让随机性稍微对齐一点,做 A/B 对照时结论要以逐字评分为准,别指望两张图像素级可比。
六、批量出图与成本口径
bl image generate 的参数里有几个是给批量场景准备的:--n 单次请求出图数(默认 1,最大 6)、--concurrent 并发请求数(默认 1)、--async 只返回任务 id 不等待、--out-dir 与 --out-prefix 控制落盘位置与命名、--poll-interval 控制轮询间隔。接 CI 的话,--async 配 --out-prefix 能把出图步骤挂进流水线,文件名前缀带上构建号,产物就不会互相覆盖。
本次实测的成本上限是 ¥0.86,按价格表算:turbo 两张 ¥0.2、Standard 两张 ¥0.36、Pro 两张 ¥0.5。
免费额度这块得说清楚。官方免费额度清单显示 qwen-image-3.0 和 qwen-image-3.0-pro 各有 10 次,到期 2026-11-03;z-image-turbo 在清单里没有免费额度条目。我自己跑完之后查额度,余量没动,用量页也查不到记录,这把 Key 的计费归属和 Console 登录看到的账本对不上。所以免费额度能不能命中,以你自己控制台的账单与额度页为准,我不替任何账号打包票。企业环境做预算时按单价乘张数算,别把免费额度计进成本模型。
Key 在 控制台密钥管理页 创建,bl auth login 贴进去就能跑。免费额度只覆盖华北2(北京)地域的模型,别的地域没有。
七、按用途分档,不要一档通吃
| 场景 | 建议档位 | 依据 |
|---|---|---|
| 对外发布物料(带日期、价格、法务句、联系方式) | qwen-image-3.0 或 qwen-image-3.0-pro |
两轮 19/19,小字数字没翻过车 |
| 上述场景里批量出图、对交付时间敏感 | qwen-image-3.0-pro |
比 Standard 贵七分钱一张,但第二轮 81.8s 对 112.4s,快差不多一倍 |
| 内部草稿、快速试版、给决策层看方向 | z-image-turbo |
5.1s 一张、¥0.1,大字与中等字号跟另外两档一样稳 |
| 文字为主的图要改一处字 | bl image edit |
实测字能改对,版式会重绘成白底文字版 |
| 插画为主的图要改字 | 原 prompt 重跑 | edit 保不住原 artwork |
还有一条流程建议,成本为零但收益最大:凡是带日期、价格、电话的图,出图之后放大核一遍数字。我这次抓到的 2016 就是放大才看见的。模型把字画对了九成九,剩下那一点恰好落在最不能错的地方。
现在的流程是:草稿用 turbo 五秒出一版看方向,定稿用 Pro 重跑,出图放大核数字,要改字先看是文字图还是插画图再决定 edit 还是重跑。一套下来十分钟。




