那批单元测试是 AI 生成的,一共 60 条,覆盖率报告很漂亮:行覆盖 95%,全绿。上线前一天,我们还专门截了那张覆盖率图发进群里。
上线第二天,业务方报了一个缺陷:满减叠加优惠券的时候,折扣算反了——本该先减满减、再打折,代码却先打了折、再减满减,用户少付了钱。奇怪的是,这条路径的那几行代码,明明是被测试「覆盖」到的,跑的时候一片绿。
复盘时我们扒开那 60 条用例,发现一个让人后背发凉的规律:AI 是「跟着实现写断言」的。实现里 price * 0.9 算出来是多少,它就把那个数填进 assertEqual。覆盖率当然高——每一行都被执行到了;但它根本没有能力发现实现里的逻辑是错的,因为它的期望值就是从错误实现里抄来的。
覆盖率量的是「你的代码被测过没有」,不是「你的测试能不能抓住 bug」——这两件事,AI 时代差得越来越远。
一、覆盖率高 ≠ 检出率高
先把结论摆前面:行覆盖率高,只能说明测试跑过了这些行,不能说明测试在跑过的时候有能力让错误的代码变红。
一条 assertEqual(apply_discount(300, 10, True), 260.0),如果那个 260.0 是照着实现算出来抄进去的,那么无论实现里的折扣逻辑是对是错,这条断言都会通过——它测的是「实现等于它自己」,恒真。覆盖率统计里,这几行被标记成「已覆盖」,绿得理直气壮。
这就是 AI 生成用例最典型的假绿:不是没写测试,而是写了一堆没有独立判断力的测试。要戳破它,你得换一个问法——不问「测过没有」,改问「如果代码错了,这些测试抓得到吗」。
二、为什么 AI 写的断言特别容易假绿
这不是 AI 笨,是它的工作方式决定的。你让它「给这个函数写单元测试」,它手上最可靠的信息就是这个函数本身。于是它做的事本质上是一次翻译:把实现读一遍,再把实现的行为写成断言。这种测试有一个致命的循环——期望值来自被测代码,被测代码错了,期望值跟着一起错,断言照样成立。
人工写用例时也会偷懒,但脑子里通常还带着「需求说应该怎样」这份独立信息;AI 拿到的往往只有代码、没有需求,于是「应该怎样」被「实际怎样」悄悄替换掉了。覆盖率工具看不出这次替换,因为它只统计行有没有被执行,从不统计断言有没有独立来源。
识别假绿有个便宜的土办法:挑几条用例,把被测函数里的一个运算符手动改错,再跑一遍。如果测试还是全绿,这批断言就是抄来的。这个土办法的自动化版本,就是变异测试。
三、变异测试:故意把代码改错,看测试抓不抓得到
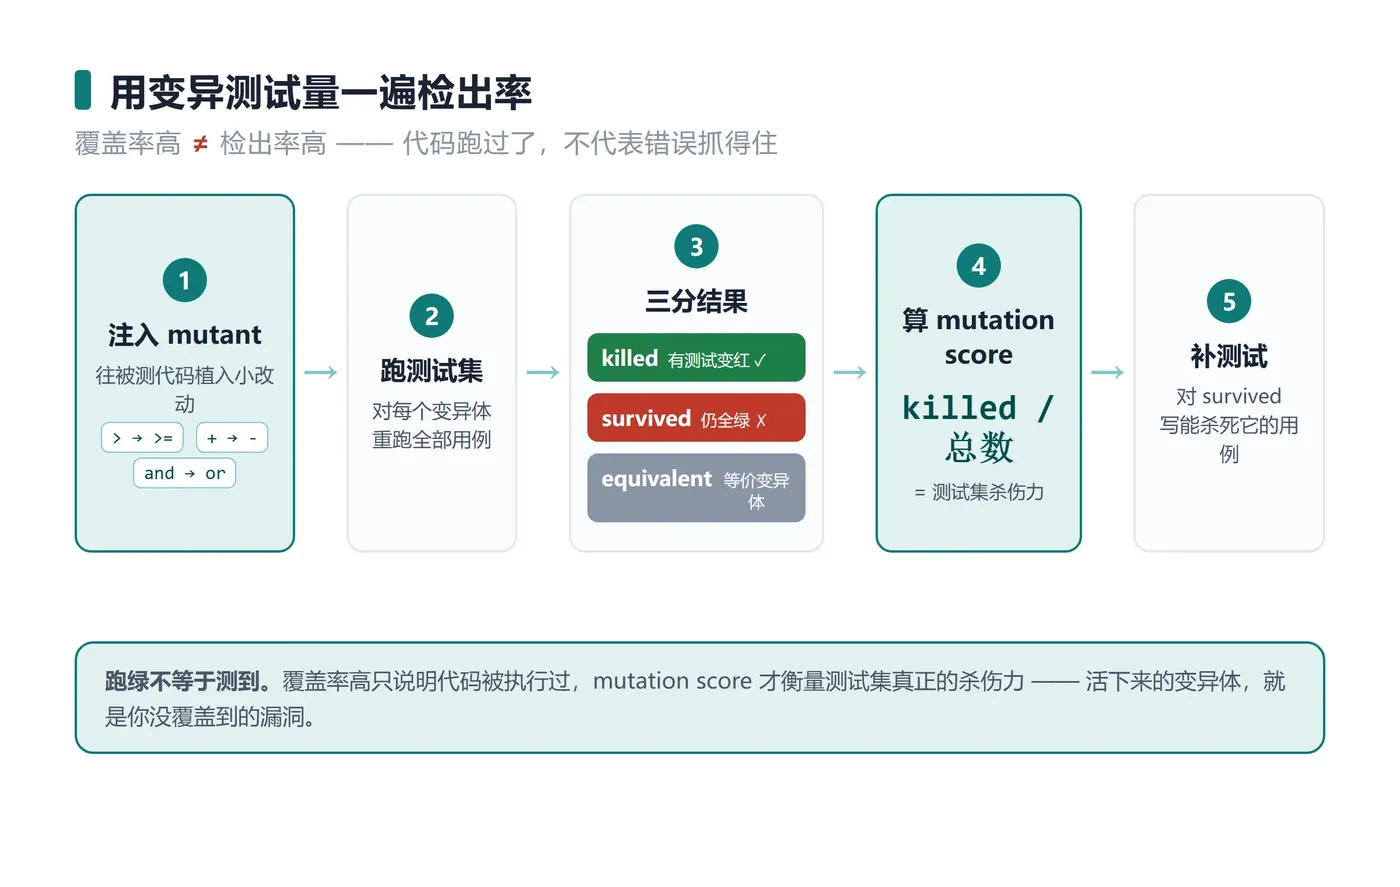
变异测试的思路特别朴素:既然你不确定测试有没有杀伤力,那就人为往被测代码里注入一些小缺陷,再跑测试集,看它能不能发现。
每一个被注入的小改动叫一个 mutant(变异体),常见的注入就是把 > 改成 >=、把 + 改成 -、把 and 改成 or、删掉某一行、把常量改一个值。注入之后跑整组测试:
- 有测试变红了,说明这个 mutant 被「杀死」(killed)——测试发现了代码被改错,好;
- 全部还是绿的,说明这个 mutant「存活」(survived)——代码都被改错了,测试居然没反应,这正是你线上会漏 bug 的地方;
- 还有一种叫「等价变异体」(equivalent),改了写法但行为不变(比如
x*2改成x+x),这种本来就杀不死,不该算进分母。
下面这张表把常见算子和杀它的难度列出来,方便你判断哪些存活 mutant 是真问题:
| 变异算子 | 示例 | 易杀难度 |
|---|---|---|
| 关系运算符替换 | > → >=、< → <= |
中:需要边界值断言才杀得死 |
| 算术运算符替换 | + → -、* → / |
低:只要期望值不是抄的,基本能杀 |
| 逻辑运算符替换 | and → or |
中高:需要覆盖条件组合的用例 |
| 常量修改 | 0.9 → 1.0 |
低:金额类断言容易抓到 |
| 删除语句 | 删掉一行赋值 | 高:若无对应断言,极易存活 |
一句提醒:边界值相关的算子(> 改 >=)最考验测试质量,它们存活往往意味着你的用例只测了「典型值」,没测「临界值」——而线上出的事,多半就出在临界值上。
四、mutation score 才是检出率
把上面的结果量化成一个数,就是 mutation score:
mutation score = 被杀死的 mutant 数 ÷(总 mutant 数 − 等价变异体数)
它量的才是你真正关心的东西——测试集的检出率。覆盖 95% 但 mutation score 只有 30%,意思是:代码几乎每行都被跑过,可一旦这些行被改错,你的测试十次里有七次抓不到。这种测试集在 CI 里绿得再好看,也挡不住「折扣算反」这类缺陷上线。
把两个指标放一起,差别就一目了然:
| 维度 | 行覆盖率 | mutation score |
|---|---|---|
| 衡量的是什么 | 代码有多少行被执行过 | 代码被改错时测试能抓住多少 |
| 能被什么骗 | 期望值抄实现的「假绿」测试 | 极难作弊,改错了就必须变红 |
| AI 生成用例常见表现 | 很高(跟着实现跑一遍) | 偏低(断言没有独立判断力) |
| 怎么提升 | 补更多走到的路径 | 补边界值、补能杀死存活 mutant 的断言 |
| 适合用来 | 快速看有没有大片没测 | 判断测试集到底有没有杀伤力 |
五、Python 里怎么落地:mutmut 与 cosmic-ray
Python 生态最常用的是 mutmut 和 cosmic-ray。mutmut 上手最快,配置也简单;cosmic-ray 更适合分布式跑、算子可配。下面以一个折扣模块为例,给一套能直接跑的东西。
先看被测模块和一组典型的「AI 风格」测试——覆盖率高,但断言是照着实现抄的:
# discount.py —— 订单折扣计算模块(被测代码)
VIP_THRESHOLD = 200.0   # 满 200 才享会员九折


def apply_discount(price: float, coupon: float, vip: bool) -> float:
    """先看是否达到满减门槛,达标才打会员折,再减优惠券。价格不能低于 0。"""
    if vip and price >= VIP_THRESHOLD:
        price = price * 0.9          # 会员九折
    price = price - coupon           # 再减优惠券
    if price < 0:
        price = 0
    return round(price, 2)


# test_discount_ai_style.py —— AI 生成:覆盖率高,但期望值抄实现,杀伤力低
import unittest
from discount import apply_discount


class TestDiscountWeak(unittest.TestCase):
    def test_vip_over_threshold(self):
        # 期望值 260.0 是照着 300*0.9-10 从实现里抄进来的,不是独立算出来的
        self.assertEqual(apply_discount(300, 10, True), 260.0)

    def test_vip_below_threshold(self):
        # 100 没到门槛,不打折:100-10=90
        self.assertEqual(apply_discount(100, 10, True), 90.0)

    def test_non_vip(self):
        self.assertEqual(apply_discount(100, 10, False), 90.0)

    def test_zero_floor(self):
        self.assertEqual(apply_discount(5, 100, False), 0)


if __name__ == "__main__":
    unittest.main()
跑 mutmut,把 mutation score 打出来。命令和配置如下:
# 安装
pip install mutmut

# setup.cfg 里限定只对核心模块跑,控制 mutant 爆炸
# [mutmut]
# paths_to_mutate=discount.py
# tests_dir=./

# 1) 先确认测试本身是绿的
python -m unittest -v

# 2) 跑变异测试(会往 discount.py 逐个注入 mutant 再跑测试)
mutmut run --paths-to-mutate discount.py --tests-dir ./

# 3) 看结果汇总:killed / survived / timeout 各多少
mutmut results

# 4) 逐个查看存活 mutant 的具体改动
mutmut show 1
跑完你会发现:那几条抄实现的测试,杀掉了算术类 mutant(* 改 /)和常量 mutant(0.9 改 1.0)——期望值虽然是从实现里抄的,但抄的是当前这一版实现,代码一改就对不上号。真正存活的是关系运算符 mutant:把满减门槛的 price >= VIP_THRESHOLD 改成 price > VIP_THRESHOLD,四条测试全绿,因为没有一条正好打在 200 这个门槛值上。mutation score 就卡在这种地方。
如果仓库更大、想分布式跑或者自定义算子,就换 cosmic-ray,它的流程是「先建基线、再执行、最后出报告」:
pip install cosmic-ray

# 1) 初始化会话与基线配置(toml 里写清 mutate 哪个模块、用什么命令跑测试)
cosmic-ray init session.toml baseline.toml

# 2) 先跑基线:确认没注入任何 mutant 时,测试本身就是全绿的
cosmic-ray baseline baseline.toml

# 3) 注入并逐个执行(可分布式,把任务摊到多台机器上)
cosmic-ray exec session.toml

# 4) 出报告:mutation score 与存活 mutant 清单
cr-report session.toml
不管用哪个工具,控制 mutant 爆炸只有三条经验。一是范围锁死在核心业务模块,算钱、算权限、算库存的地方优先跑,工具类和自动生成的代码不跑。二是先让测试跑快,变异测试的总成本约等于「mutant 数 × 单次测试耗时」,一个本身就慢的测试集会让整件事不可行,先把慢用例挪走或打桩再开跑。三是分批读结果,别指望一次跑完就消化几千条,按存活 mutant 所在的函数排序,从算钱的那几个开始补。
六、针对存活 mutant,补一条真能杀死它的测试
mutmut show 会告诉你第几号 mutant 存活、改了哪一行。假设存活的是把满减门槛的 >= 改成了 >——它之所以能活下来,是因为你从没有一条测试正好打在门槛值 200 上。补一条边界断言就能杀死它:
# test_discount_kill_survivor.py —— 针对存活 mutant 补的门槛边界测试
import unittest
from discount import apply_discount


class TestDiscountBoundary(unittest.TestCase):
    def test_vip_exactly_at_threshold(self):
        # 正好 200,落在 >= 与 > 的临界点上:达标该打折,200*0.9-10 = 170.0
        # mutant 把 >= 改成 > 之后,这里会算出 190.0,断言当场把它杀死
        self.assertEqual(apply_discount(200, 10, True), 170.0)

    def test_vip_just_below_threshold(self):
        # 199 差一点没到门槛,不该打折:199-10 = 189.0
        self.assertEqual(apply_discount(199, 10, True), 189.0)


if __name__ == "__main__":
    unittest.main()
补完再 mutmut run,那个存活 mutant 被杀死,mutation score 往上跳一格。这就是变异测试最爽的地方:它不只告诉你「测试不够好」,还精确指给你看是哪一行改动没被抓到、该在哪个边界上补断言。
几点为什么这么写。第一,setup.cfg 里一定要用 paths_to_mutate 把范围锁死在核心业务模块,别对全仓库跑——mutant 会爆炸,几千个变异体跑一晚上都出不来,而你对工具类代码的检出率其实没那么在意。第二,示例里故意保留了「期望值抄实现」的写法,因为只有让 mutation score 掉下来,你才能亲眼看到覆盖率骗人的样子;真实补测时,期望值必须自己独立算,不能从实现里复制。第三,解读存活 mutant 前先排掉等价变异体——就拿本模块说,把 if price < 0 改成 if price <= 0,在「低于 0 就置 0」这段逻辑里行为一模一样(price 等于 0 时赋成 0 还是 0),它本来就杀不死,不是测试的锅,别为它硬凑断言。踩过的坑是 timeout:有的 mutant 会让代码死循环,mutmut 记成 timeout,这类要单独看,别混进 survived 一起算。
七、别把它当日常,把它当体检
变异测试贵——每个 mutant 都要重跑一遍测试集,慢且耗资源,不适合挂在每次提交的 CI 上。合理的用法是当定期体检:对核心业务模块(算钱、算权限、算库存的地方)按周或按迭代跑一次,盯住 mutation score 的趋势。AI 大量生成用例的团队尤其该这么做,因为覆盖率这个老指标已经被「跟着实现写断言」的假绿彻底带偏了,你需要一个骗不了的数来兜底。
绿灯不代表测到了,覆盖率也不代表抓得住——只有当代码被改错时你的测试会脸红,它才算真的在替你把关。
覆盖率证明你跑过了代码,mutation score 才证明你有能力抓住代码里的错——AI 时代,后者才是测试集的真本事。
你们那套 AI 生成的用例,敢不敢往被测代码里注入一个缺陷,看它能杀死几个?