说明:本文中 SysOM 为龙蜥社区运维联盟开源的项目,是阿里云操作系统控制台运维组件,SysOM Agent 是 SysOM 的智能助手。
除了龙蜥社区 Skillhub 的优质技能,我们也会陆续推荐一些企业官方的优质 Skill 给大家 ,同时持续引导企业将 Skill 贡献到社区。今天,我们推荐的是龙蜥社区理事长单位阿里云发布的 SysOM 诊断 Skill。
SysOM 是龙蜥社区系统运维联盟(System Operation & Maintenance Alliance,简写 SOMA)开源的项目。自 2021 年在龙蜥社区开源以来,SysOM 已迭代了多个版本,围绕操作系统层的智能诊断、监控告警、异常检测、集群运维与 AIOps 沉淀了大量能力,并深度集成到 Anolis OS 之中,成为龙蜥社区最具代表性的运维方向开源产品之一。
在龙蜥社区里,阿里云将大规模生产环境中沉淀的运维经验持续回馈社区:推动 eBPF 可观测、CPU&GPU Profiling、故障自愈等前沿能力在开源侧落地;联合社区合作伙伴共同建设覆盖单机诊断、集群运维、AI 辅助分析的完整技术栈。此次发布的 SysOM 诊断 Skill,正是社区合作伙伴将多年运维专家经验沉淀为 AI Agent 可复用能力,通过龙蜥社区与阿里云操作系统控制台向所有运维工程师开放。
这一发布的背后,是一个行业性的困境。过去十年,运维技术一直在缩短“发现问题”的时间——从手动巡检到自动化监控,从阈值告警到 APM 全链路追踪。但有一段路始终没变:告警响了之后,工程师登录机器,手动跑命令,靠经验分析根因。如今,阿里云操作系统控制台推出的 SysOM 诊断 Skill,把这段路彻底交给 Agent。
SysOM 诊断 Skill 是什么?一句话:让任何运维 Agent 具备资深内核专家的诊断能力。不需要你记得住 eBPF 探针怎么挂、内核调用栈怎么看、cgroup 内存统计怎么算——Agent 通过 Skill 融合分析监控、日志、探针数据完成数据采集、因果归因、修复决策,几分钟返回完整根因链和修复方案。
这不是某个监控指标的改善,而是运维工作模式的结构性变化:
| 旧范式 | 新范式 | |
| 第一步 | 工程师接到告警 | Agent 接收告警 |
| 第二步 | 打开 Grafana/Prometheus 看面板 | Agent 调用诊断 Skill |
| 第三步 | SSH 登录机器,逐个跑命令排查 | Skill 告诉agent需要怎么排查问题 |
| 第四步 | 靠经验交叉比对,拼凑因果链 | Agent 自动完成数据收集和根因分析 |
| 第五步 | 人工判断修复方案 | Agent 输出修复建议 |
工程师的角色,从“凌晨两点手动拼线索的侦探”,变成“审阅诊断报告、决策修复策略的架构师”。
真实困境:监控告诉你“出了问题”,然后呢?
凌晨两点,告警响了——某台 ECS 实例 CPU 100%。Grafana 一片红,Prometheus 告诉你 sys 95.8%。到这一步,“发现异常”的任务已经完成。
但接下来才是真正痛苦的开始。
你登录机器,top 一敲,CPU 90%,然后呢?需要区分是哪种类型 CPU 高,user 高、sys 高、还是 si(软中断)高?不同的指标高是完全不同的排查方向:比如sys 高,可能是 syscall 过于频繁,也可能是锁竞争、缺页中断,内核回收等等,而 si 高就更隐蔽了。一个看似初级运维 问题可能折腾两小时还在 top 和 ps 之间来回切;而 Skill 做的事情,就是把分析决策树固化下来——让 Agent 具备丰富的问题排查经验。
这就是那个 gap:监控体系解决“发现异常”,但从“发现异常”到“定位根因”之间,仍然完全依赖工程师经验排查。
阿里云操作系统控制台推出的 SysOM 诊断 Skill 要解决的,正是这个 gap——并且把问题分析能力从少数人手里释放出来,交给每一个运维 Agent。
Agent + Skill:一句话触发,根因分析
安装 SysOM 诊断 Skill 后(安装步骤见下),运维 Agent 的工作方式变成这样:
案例一:CPU 周期性抖动,3 分钟定位内核级根因
某企业核心业务服务器的 CPU 出现周期性抖动——sys 每隔几秒飙到 45% 以上,但 top 看不到任何高 CPU 进程,业务日志也无异常。传统排查方式(top、strace、dmesg)2 个小时无果。
使用 SysOM 诊断 Skill 完成 CPU 抖动诊断的操作步骤:
1、前置条件:
在开始之前,请确认以下环境已就绪:
- 已安装支持 Skill 的 Agent 客户端(如 OpenClaw、QoderWork 等)
- ECS 实例已安装阿里云 CLI,版本 >= 3.3.3(可通过 aliyun version 验证)
- 拥有阿里云 RAM 角色管理权限(需能创建角色并授权)
2、安装 Skill
访问 SysOM 诊断 Skill 页面,查看 Skill 详情和版本信息。链接:
https://skills.aliyun.com/skills/alibabacloud-sysom-diagnosis
执行安装命令:以 openclaw 为例,执行如下命令安装 SysOM 诊断 Skill
npx skills add aliyun/alibabacloud-aiops-skills --skill alibabacloud-sysom-diagnosis --agent openclaw -y --full-depth复制
说明:如果您使用的是其他 Agent 框架,请将 --agent openclaw 替换为对应的 Agent 名称。--full-depth 参数确保拉取完整的参考文档和脚本。
安装后,重启 Agent 客户端即可使用此 Skill。
3、创建 RAM 角色并授权
SysOM 远程深度诊断依赖阿里云 OpenAPI,需要为 ECS 实例配置一个具有 SysOM 访问权限的 RAM 角色,这是整个鉴权体系的基础。
打开 RAM 控制台(https://ram.console.aliyun.com/roles);点击“创建角色”,受信服务选择 ECS;填写角色名称(例如 SysomRole),给角色授予 AliyunSysomFullAccess 策略,完成创建。
4、配置鉴权
在您的 Agent 运行的环境中配置 CLI:‘
aliyun configure --mode EcsRamRole --ram-role-name <角色名>复制
5、使用 SysOM 诊断 Skill
工程师通过 Agent 输入:“我的实例 CPU 使用率出现周期性抖动,sys 很高”。
Agent 自动调用 CPU Profiling 采集火焰图,发现 native_queued_spin_lock_slowpath 占用了 40% 以上的 CPU——这是内核自旋锁的慢路径。进一步分析调用栈,追溯到 lookup_fast → try_to_unlazy_next → __legitimize_path,确认根因:业务进程高频访问不存在的文件路径,导致内核 Dentry Cache 堆积了海量 Negative Dentry。当系统触发回收时,VFS 路径解析从 RCU 快路径被迫降级到需要获取锁的慢路径,大量并发线程在 dentry 自旋锁上爆发严重竞争。
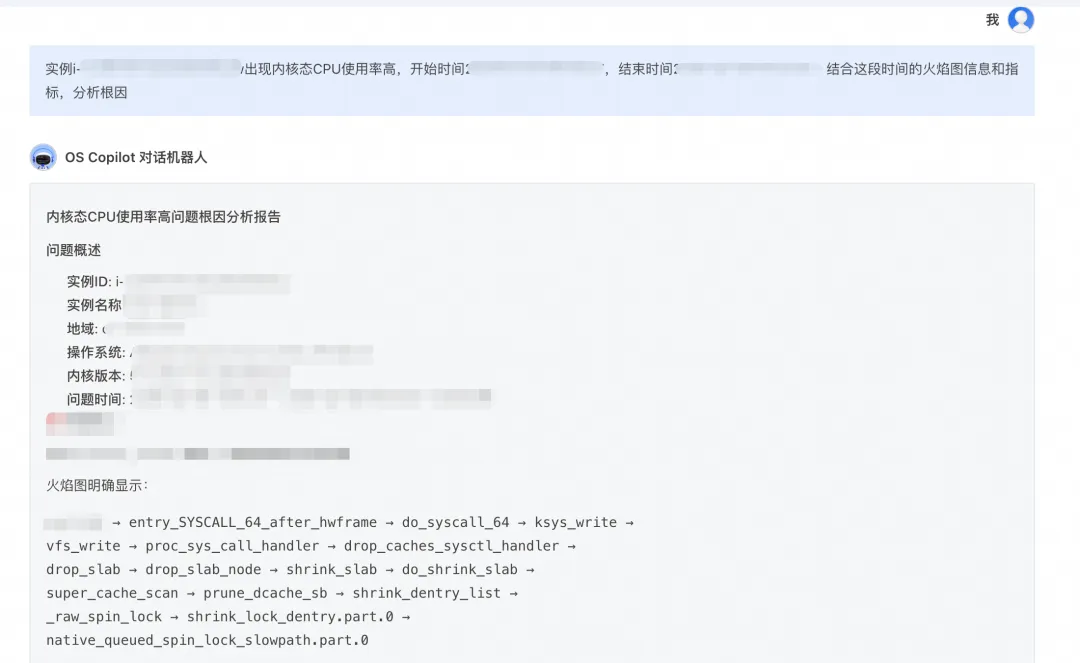
这类问题的隐蔽之处在于:top/ps 完全看不到高 CPU 进程,抖动容易被误认为“正常波动”,传统排查平均需要 4 小时以上。SysOM Agent 3~5 分钟完成定位,并给出完整的解决方案——应急清理缓存、修复业务代码中访问不存在路径的逻辑、缓存文件存在性检查结果。
传统排查手段(top、ps)只能看到进程级别的 CPU 占用,无法告诉你 CPU 时间花在了哪个内核函数上。eBPF(Extended Berkeley Packet Filter)是 Linux 内核提供的可编程观测框架,允许在不修改内核代码、不重启系统的前提下,在内核函数的入口和出口动态挂载探针程序。
具体到 CPU Profiling 场景,用户通过阿里云操作系统控制台纳管机器后,会周期性采样当前 CPU 正在执行的函数调用栈。每次采样记录一条从当前函数到调用栈顶的完整路径,数千次采样叠加后生成火焰图(Flame Graph)。火焰图的横轴是函数名按字典序排列,纵轴是调用深度,每个色块的宽度代表该函数在采样中出现的频率——色块越宽,CPU 花费在该函数上的时间越多。
Skill 指导 Agent 分析火焰图,发现 native_queued_spin_lock_slowpath 占据了 40% 以上的采样。Skill 的分析规则进一步指导 Agent 沿调用栈向下追溯:该自旋锁函数被 lookup_fast 调用,lookup_fast 是 VFS(虚拟文件系统)路径解析的 RCU 快速路径入口,当快速路径失败时降级到需要获取 dentry 锁的慢路径 try_to_unlazy_next。结合 /proc/sys/fs/dentry-state 中 Negative Dentry 数量异常的指标,Skill 的因果推理链最终串联出完整根因:高频访问不存在路径 → Negative Dentry 堆积 → 回收触发时 RCU 快路径降级 → 自旋锁竞争爆发。
案例二:30 秒定位 Pod WorkingSet 告警根因
某 K8s 集群中,Pod 频繁触发 WorkingSet 高告警——使用率 87.2% 并持续走高,但业务运行完全正常,无 OOM、无性能问题。运维团队陷入“该扩容还是该忽略”的两难。
传统排查需要在监控、节点、容器之间反复切换,1-2 小时起步,而且核心痛点是:监控能看到 WorkingSet 和 Cache 都在涨,但”底是哪个文件占了多少缓存”这个问题回答不了。
使用 SysOM 诊断 Skill 完成 Pod 频繁触发 WorkingSet 诊断的操作步骤:
1、参考案例一的步骤,完成 Skill 安装、RAM 角色创建授权及 CLI 鉴权配置。
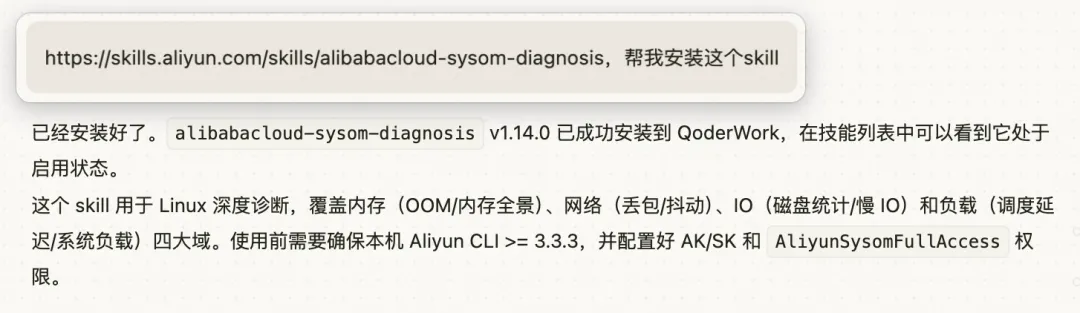
在安装 Skill 的环节,如果您信任自己的 Agent,也可以在准备好 RAM 角色后,直接发 Skill 给它,“帮我安装这个 Skill”。
2、使用 SysOM 诊断 Skill
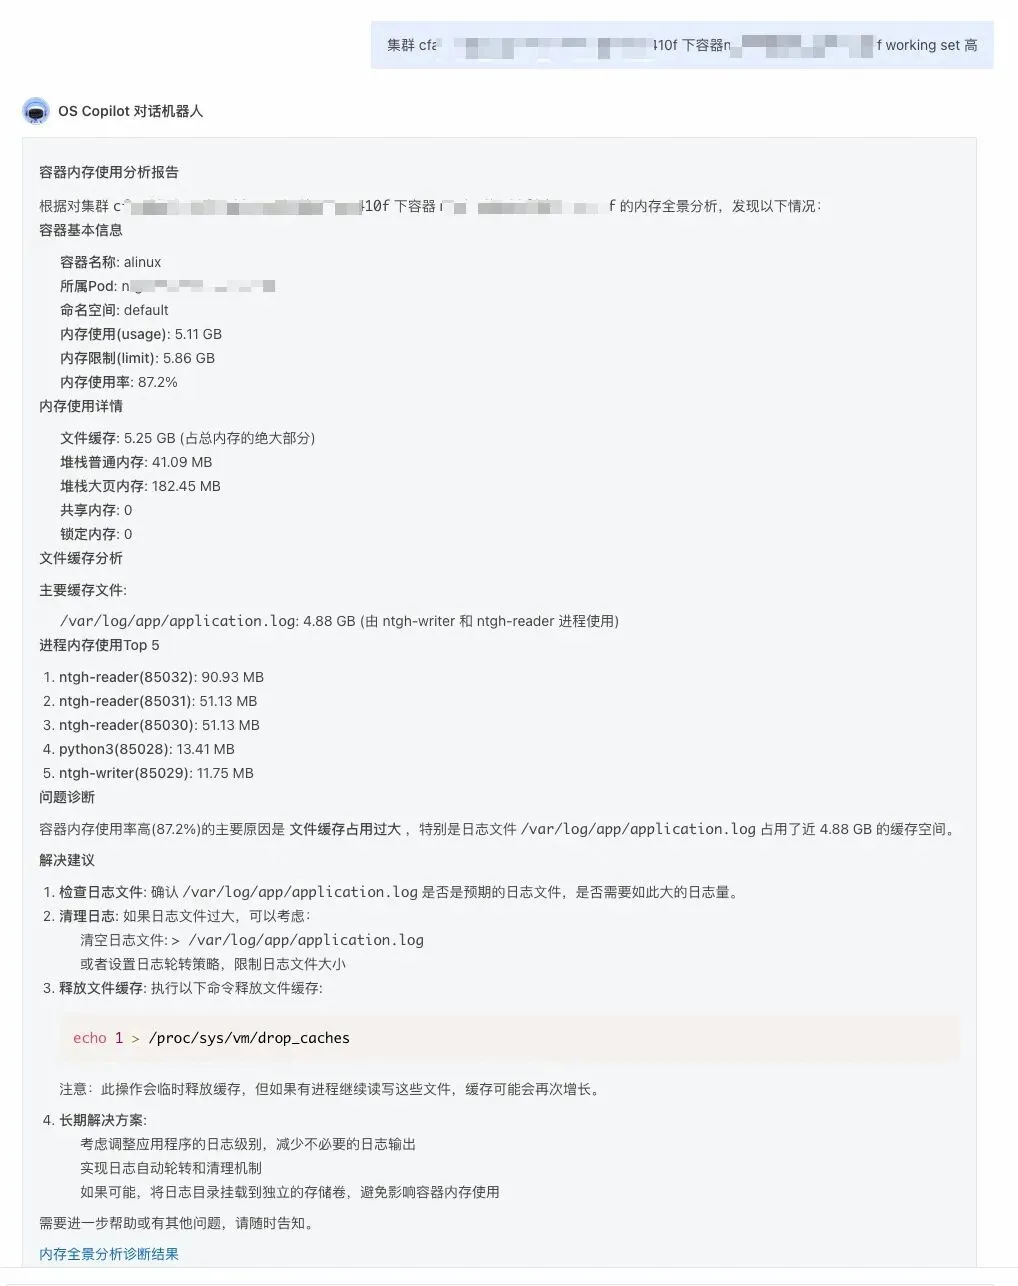
工程师打开 Agent,输入问题描述:“集群里的 Pod 频发 WorkingSet 高”。
约 30 秒返回完整诊断结果:/var/log/app/application.log 占用了 4.88GB 缓存,4 个进程(1 个写入进程 + 3 个读取进程)重复读取同一日志文件,推高了 Active(file) 被计入 WorkingSet。Agent 同时给出组合方案——短期清理日志释放缓存止血,长期配置日志轮转、优化采集链路等方法,避免“未辨根因就扩容”带来的持续资源成本浪费。
那么为什么日志文件会推高 WorkingSet?
理解这个案例需要先理解 Kubernetes 中 WorkingSet 内存的计算方式。WorkingSet 并非简单的 RSS(常驻内存集),它的计算公式是:WorkingSet = Usage - min(TotalInactiveFile,Usage - RSS)。简单来说,WorkingSet 等于容器总内存用量减去“不活跃的文件缓存”——内核认为不活跃的 Page Cache 是可以随时回收的,所以不算进 WorkingSet;但活跃的 Page Cache(Active(file))会被计入。
本案例的关键在于:4 个进程持续读取同一个日志文件,使该文件对应的 Page Cache 页面始终处于 Active 状态——内核的 LRU 算法认为这些页面被频繁访问,不会将其移到 Inactive 列表。结果就是 4.88GB 的日志文件缓存全部被计入 WorkingSet,即使这些缓存对业务毫无价值(日志读取是顺序扫描,读完就不再需要)。
这类问题的隐蔽性在于,排查方向容易走偏,人工定位往往需要数小时的反复验证。Skill 的价值是将这个过程压缩为一次诊断调用——Agent 沿 Skill 预设的分析路径直达根因,既省去了人工逐层排查的时间成本,也避免了通用 Agent 在无 Skill 引导下盲目采集大量指标、反复试错带来的 token 消耗。
评测数据说话:16 个场景横向对比
前面两个案例展示了 SysOM 诊断 Skill 在 CPU 抖动和 Pod WorkingSet 两个具体场景下的诊断效果。但个例容易让人产生疑问:这是精心挑选的“最佳展示”,还是真正代表了系统性的能力提升?
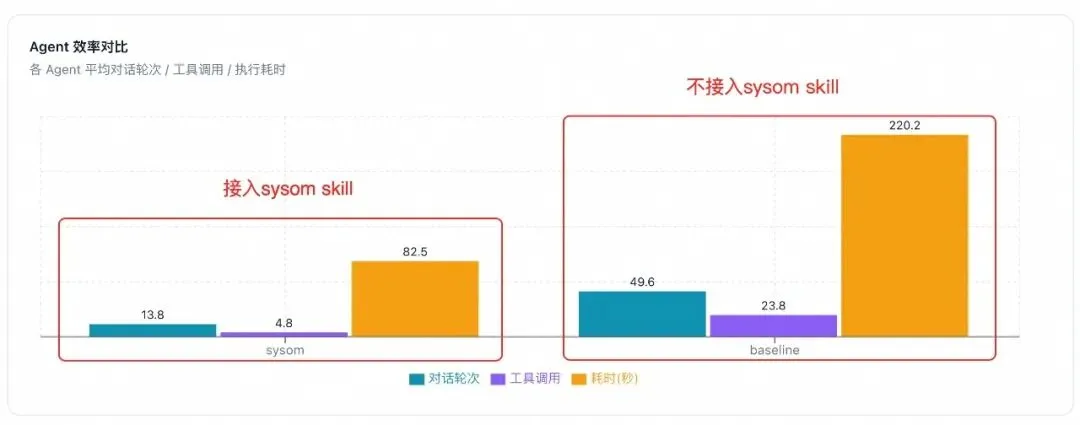
为了回答这个问题,我们在 16 个真实运维诊断场景上做了一组横向评测。评测对象是两个 Agent:一个是安装了 SysOM 诊断 Skill 的 Agent(以下简称 SysOM),另一个是同等配置但未安装任何 SysOM 诊断 Skill 的通用 Agent(以下简称 baseline)。两者使用相同的大语言模型底座,面对相同的问题描述,唯一的区别是:SysOM 拥有 Skill 封装的专家诊断经验,baseline 没有。
评测从六个维度打分:任务完成率(能否走通完整的诊断流程)、推理准确性(根因分析是否正确)、解决方案质量(给出的修复建议是否可落地)、效率(是否在合理步骤内完成诊断,而非反复试错)、关键指标覆盖(是否采集和分析了与问题真正相关的核心指标)、以及技术能力(能否调用 eBPF 探针、内核 Profiling 等高级诊断手段)。
结果如下:
| 评测维度 | SysOM(有 Skill) | baseline(无 Skill) | 差异 |
| 总完成率 | 98% | 71% | +22.8pp |
| 任务完成率 | 100% | 88% | +22pp |
| 推理准确性 | 100% | 78% | +22pp |
| 解决方案质量 | 98% | 70% | +22pp |
| 效率 | 89% | 22% | +67pp |
| 关键指标 | 96% | 71% | +7pp |
| 技术能力 | 99% | N/A | — |
| 高风险误判 | 0次 | 6 次 | — |
以下几个发现值得展开说说:
效率差距是所有维度中最大的。 baseline 的效率得分只有 22%,而 SysOM 达到了 89%,差距 67 个百分点。这并不意外——没有 Skill 的通用 Agent 在面对一个运维问题时,虽然能执行 top、ps、iostat、dmesg 等基础命令,但它不知道接下来应该做什么。面对 CPU sys 高,它不知道该挂 eBPF 探针做 CPU Profiling;面对内存异常,它不知道该怎么区分 slab 分配异常和 page cache 膨胀。于是 Agent 陷入“执行命令 → 拿到数据 → 不知道怎么解读 → 再执行另一个命令”的循环,大量 Token 和时间花在了无效的探索上。Skill 做的事情,就是把资深内核专家的“下一步该看什么”固化成了一条决策树,Agent 沿着这条路径直达根因,不需要试错。
推理准确性和解决方案质量的差距同样显著。 baseline 的推理准确性为 78%,解决方案质量为 70%。这意味着即使 baseline 偶尔能“猜对”问题方向,它给出的修复建议往往停留在表层——“建议增加监控”“建议扩容““建议重启服务”。而 SysOM 在这两项上分别达到了 100% 和 98%,几乎每个场景都能给出精确到进程、文件、内核函数级别的根因定位,以及分级的修复方案(应急止血 → 短期修复 → 长期根治)。这个差距的本质是:通用 Agent 缺少“从数据到因果链”的推理能力,而 Skill 恰恰填补了这个空白。
6 次高风险误判是最值得警惕的数字。 在 16 个场景中,baseline 出现了 6 次高风险误判,占比超过三分之一。所谓“高风险”,不是“没答对”这么简单,而是 Agent 给出了可能直接导致业务影响的错误建议。比如将 Pod WorkingSet 高误判为“内存不足,需要扩容”——如果运维团队据此执行扩容,不仅浪费资源,还掩盖了真正的根因(大量 Page Cache 被日志文件占用);又比如在 CPU 抖动场景下给出“重启观察”的建议,导致问题在重启后暂时消失、但很快复发,白白浪费了一次故障窗口。sysom 在 16 个场景中的高风险误判数为 0——Skill 的诊断路径经过专家校验,在“不确定”时宁可说“需要进一步采集数据”,也不会给出可能误导的建议。
技术能力维度上,baseline 根本无法完成评估。 评测框架中包含需要调用 eBPF 探针采集内核运行时数据、解析火焰图、分析内核调用栈等高级诊断任务。baseline 在这些任务上无法完成(N/A),说明通用 Agent 在面对内核级深度诊断时,不是“做得不好”,而是“做不到”。这类能力需要领域专家将采集方法、分析逻辑、判断阈值等经验封装为 Skill,Agent 才能调用执行。
这组评测数据回答了一个核心问题:SysOM 诊断 Skill 的价值不是“让 Agent 做得好一点”,而是从根本上决定了 Agent “能不能做”和“做得对不对”。没有 Skill,Agent 是一个能执行命令但不会看病的实习生;有了 Skill,Agent 拥有了资深内核专家的诊断能力。
为什么是“Skill”而不是“更好的监控”?
监控工具(Prometheus、Datadog、云监控)回答的是 “发生了什么”——哪个指标超线、什么时候超线,这个能力已经非常成熟。
SysOM 诊断 Skill 回答的是 “为什么发生” 和 “怎么修”。它做了三件传统监控做不到的事:
第一,内核层采集。 不仅仅读 /proc 表面指标,也在内核运行时采集 IO 路径、调度延时、内存分配的数据。这依赖 eBPF 等内核可观测性基础设施的成熟。
第二,根因推理。 传统工具给你 iostat、vmstat、top 的零散指标,需要专家经验来分析。Agent+Skills 自动融合所有数据,完成从指标到因果链的推理。
第三,封装为 Skill。 这些能力不是沉淀在文档里,而是封装成 Agent 可调用的 Skill。任何支持 Skill 协议的运维 Agent——无论是你自建的、还是第三方的——都可以即插即用地获得内核专家级诊断能力。
诊断能力:覆盖 8 大场景分析
SysOM 诊断不是“指标超阈值”式的监控告警,而是深入内核运行时数据的根因分析。覆盖 8 大场景分析:
| 子系统 | 诊断能力 |
| CPU | 内核态/用户态占用归因、热点函数定位、CPU 饱和度分析 |
| 内存 | 内存泄漏路径追踪、OOM Kill 触发链还原、slab 分配异常检测 |
| IO | IO 延迟归因(精准到进程和设备)、iowait 根因分析 |
| 网络 | 丢包发生在协议栈哪一层、网络抖动来源定位 |
| 负载 | load 突刺时刻的任务队列深度分析 |
| 延时 | 调度延迟归因、实时线程抢占行为分析 |
| 宕机 | kernel panic 调用栈自动解析 |
| 参数调优 | 自动调优高频内核参数 |
上述 8 个场景的诊断深度远超传统监控能力边界,每个场景背后都依赖特定的内核可观测性技术——而这些能力被 SysOM 诊断 Skill 封装为一次工具调用。
以内存诊断为例,Linux 内核的内存管理是一个多层嵌套的体系:物理页框 → Buddy System → Slab/Slub 分配器 → Page Cache → cgroup 内存控制器,任何一个层级都可能出现异常。面对 OOM Kill,人工排查需要依次读 dmesg 确认被杀进程、查 cgroup 内存统计定位消耗来源、再用 perf 或 eBPF 回溯分配调用栈,整个过程涉及多种工具、数小时的分析。而 Skill 将这些步骤整合为一次诊断调用:自动回溯 OOM 发生前的内存分配调用栈(通过 eBPF 挂载 __alloc_pages_nodemask 等关键分配函数),重建内存消耗的时序链条,直接区分是 Slab 泄漏(如 dentry/inode cache 未回收)、Page Cache 膨胀、还是应用层内存泄漏(匿名页持续增长),返回完整根因。
网络诊断同样如此。丢包定位一直是运维最棘手的场景之一——一个 TCP 报文从网卡驱动进入内核,经过 GRO/GSO、Netfilter、TC qdisc、协议栈处理、socket buffer 排队,最终到达用户态应用,路径上任何一环都可能丢包。人工排查需要 tcpdump 抓包配合 wireshark 逐层分析,耗时以小时计。Skill 通过一次调用,利用 eBPF 在 kfree_skb(内核释放 sk_buff 的函数)挂载探针,精确捕获每个丢包事件的内核调用栈和丢包位置——是 qdisc 队列满、conntrack 表溢出、还是 socket receive buffer 不足——将数小时的排查压缩到分钟级。
IO 诊断则通过 eBPF 挂载块层和调度层的 tracepoint(如 block_rq_issue、sched_switch),精确计算每个进程在 IO 等待队列中的排队时间和实际 IO 服务时间,区分延迟是来自磁盘本身变慢、IO 调度策略不合理、还是某个进程 monopolize 了 IO 带宽。
这些场景的共同特点是:诊断所需的内核级采集能力和因果推理逻辑,已经被 Skill 整合到统一的诊断工具中。Agent 无需逐个查找指标、自行拼装分析链路——一次调用即可获得完整根因。这不仅省去了人工逐层排查的时间成本,也避免了通用 Agent 在无 Skill 引导下反复采集指标、试错分析带来的大量 Token 消耗。
进阶:纳管 + 钉钉告警,让 Agent 全自动运转
单次诊断解决的是“出了问题叫 Agent 来查”。那么更进一步,你可以让 Agent 7×24 自动守护:
纳管 + 自动诊断: 安装 SysOM Agent 后,实例出现异常时自动触发内核诊断,无需任何人工介入。支持单实例、ACK 集群、批量纳管。
钉钉告警推送: 配置钉钉群 Webhook,异常发生时诊断报告直接推到团队群——不是推告警,是推根因和修复方案。团队看到的不再是“CPU 100%”,而是“dd 进程写满磁盘,建议删掉进程后调整日志级别”。
这就是完整的新运维闭环:告警触发 → Agent 自动调用 Skill 诊断 → 根因+修复方案推送到群 → 工程师决策执行,人只在最后一步介入。
这不是工具升级,是运维模型的范式转移
回看运维技术十年演进,每一步都在解决“更快发现问题”。但“发现问题”之后的“定位根因”,长期以来是一个只能靠人、靠经验、靠时间堆的手艺活。它无法规模化,无法 7×24 在线,无法跨团队复用。SysOM 诊断 Skill 的目标是是把“根因分析”这个手艺活标准化、自动化、Skill 化:运维工程师的价值不会消失——而是从“执行排查”上移到“决策修复策略、设计系统韧性”。Skill 解放的是重复性的体力劳动,工程师有更多时间去思考和做更有价值的工作。
SysOM 诊断 Skill 解决的是“出了问题查根因”,但更好的方式是在问题发生前就发现隐患。而 SysOM 巡检 Skill ——覆盖近百个巡检项,7×24 小时主动扫描指标、配置、日志异常,发现隐患后自动触发对应的诊断能力,形成“巡检发现问题 → 诊断定位根因 → 给出处置建议”的完整闭环。
后续企业官方的运维相关技能也将陆续开源到龙蜥社区 Skillhub,敬请关注。
—— 完 ——